北京時間 2026年11月19日 05:51、Google 公式 X アカウント(@Google)は新モデル Gemini 4 Neon を発表しました。続いて 06:06 には @antigravity が Google Antigravity のデスクトップアプリ、CLI、IDE 拡張機能向けにロールアウトを開始したと案内しており、有料の Google AI Pro・Ultra サブスクライバーおよび Gemini for business の法人ユーザーが利用できます。
モデル仕様と Orchestrator によるデュアルモデル連携
Gemini 4 Neon は複雑なコーディング、ナレッジワーク、科学ワークフロー向けに設計されており、1M トークンのコンテキストウィンドウと 4 段階の思考レベル(four thinking levels)を備えています。xhigh 設定時の Artificial Analysis Intelligence Index で総合 3 位、Coding Agent Index で 1 位、Vals Index で 2 位、Agent Arena の操縦性(steerability)で 2 位を獲得し、Antigravity 社内テストではこれまでで最も低いハルシネーション(fabrication)率を記録したとされています。
また、Google Antigravity の Orchestrator を使うことで、Gemini 4 Neon をプランナー(planner)に、既発の Gemini 4 Hydrogen をエグゼキューター(executor)に割り当て、重要な設計判断は Neon、高速な反復実行は Hydrogen に任せる構成が可能です。
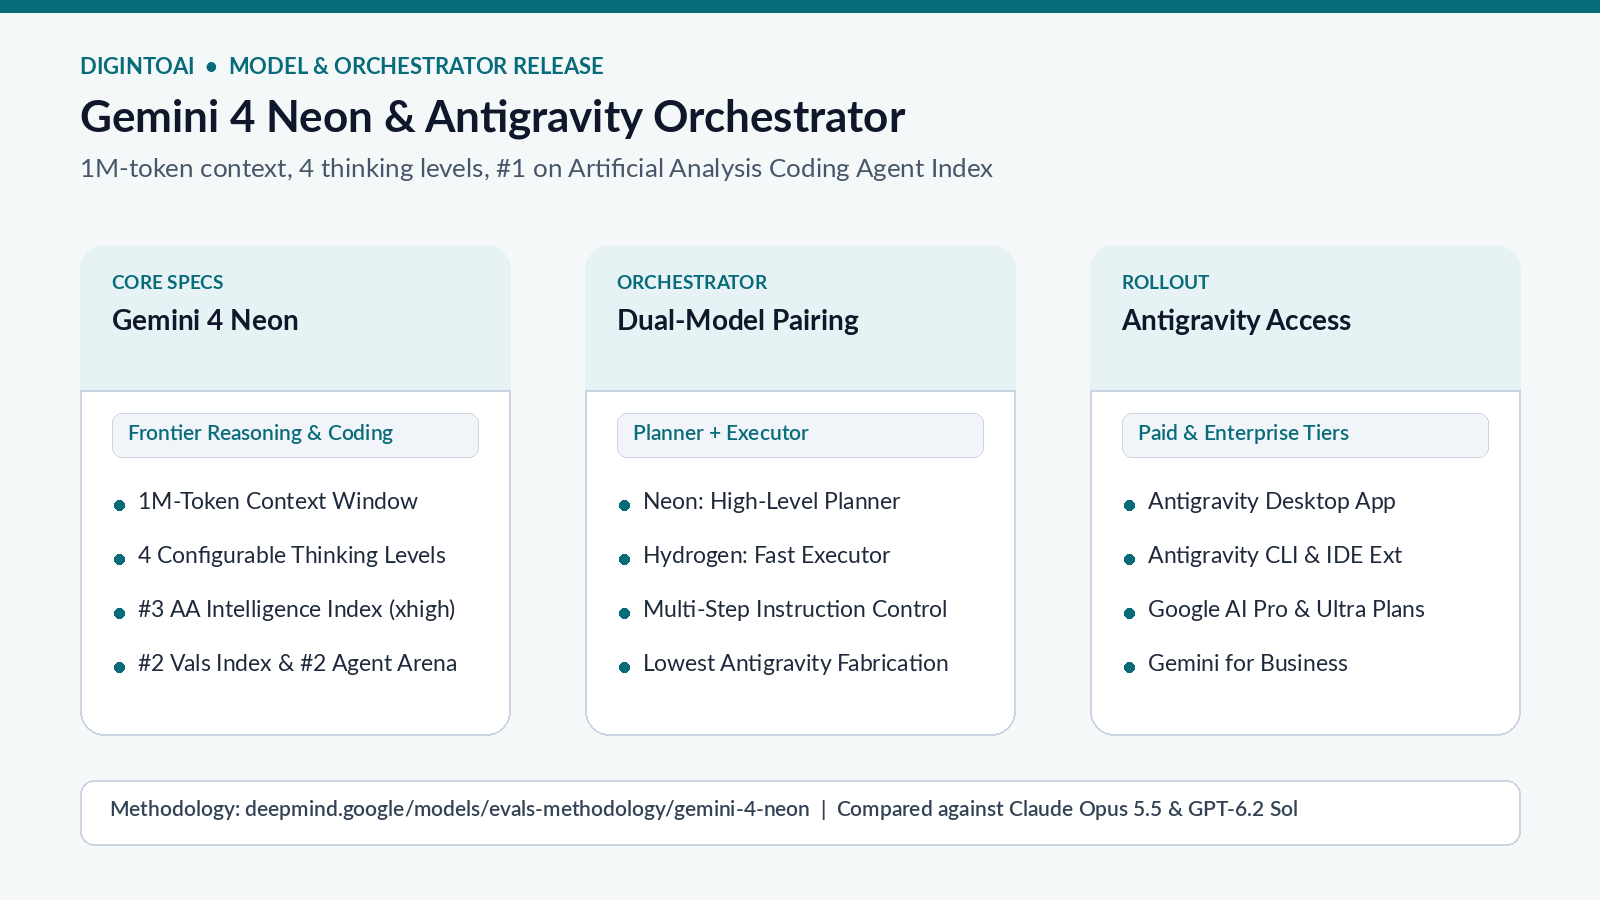
画像の出典:Google および Google Antigravity の公式発表をもとに DigIntoAI が作成した概要図。
公式ベンチマーク比較表(Claude Opus 5.5・GPT-6.2 Sol との対比)
Google は Gemini 4 Neon と Claude Opus 5.5、GPT-6.2 Sol(詳細は OpenAI GPT-6.2 Astra と GPT-6.2 Sol 発表記事 を参照)の 7 分野 18 項目にわたる比較表を公開しました(評価手法は deepmind.google/models/evals-methodology/gemini-4-neon に掲載)。
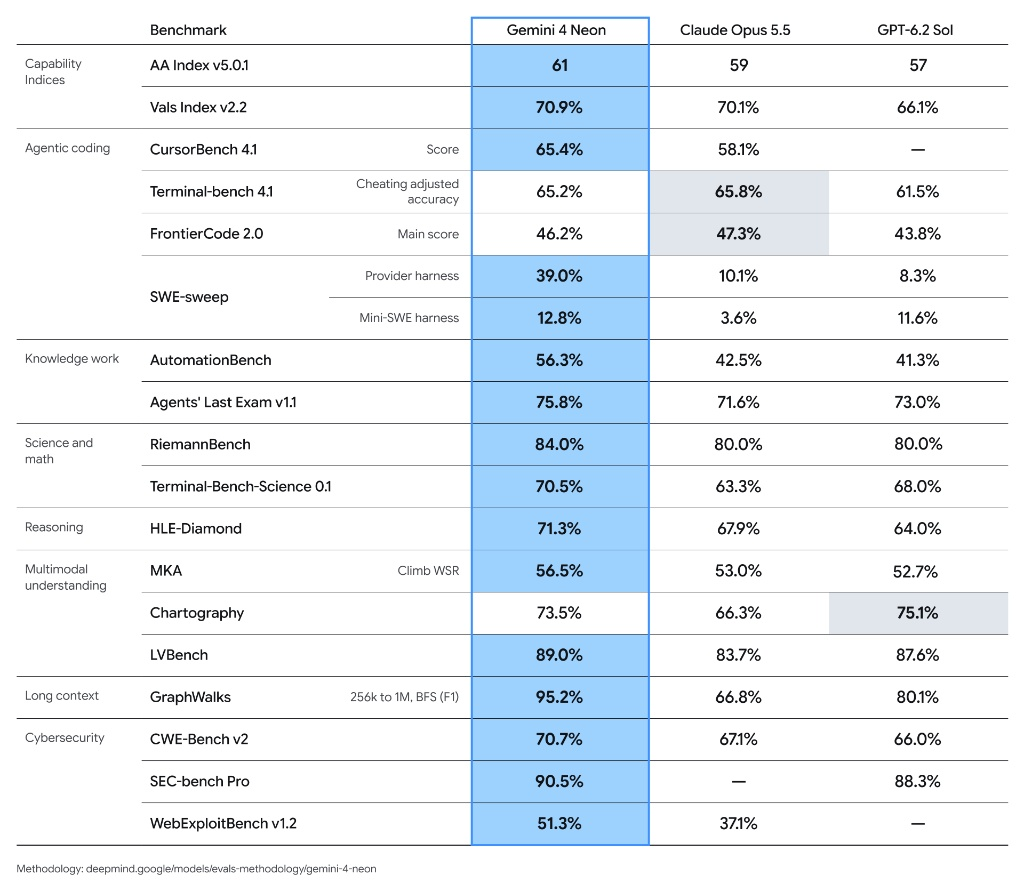
画像の出典:@Google 公式 X 投稿で公開されたベンチマーク比較チャート。
総合能力指標(Capability Indices):AA Index v5.0.1 は 61 点(Claude Opus 5.5 は 59 点、GPT-6.2 Sol は 57 点)、Vals Index v2.2 は 70.9%(同 70.1%、66.1%)を記録しました。
エージェントコーディング(Agentic coding):CursorBench 4.1 は 65.4%(Opus 5.5 は 58.1%)、SWE-sweep(Provider harness)は 39.0%(Opus 5.5 は 10.1%、GPT-6.2 Sol は 8.3%)、Mini-SWE harness は 12.8%(同 3.6%、11.6%)。Terminal-bench 4.1 は 65.2%(Opus 5.5 の 65.8% に次ぎ、GPT-6.2 Sol の 61.5% を上回る)、FrontierCode 2.0 は 46.2%(同 47.3%、43.8%)です。
ナレッジワーク・科学数学・推論:AutomationBench は 56.3%(同 42.5%、41.3%)、Agents' Last Exam v1.1 は 75.8%(同 71.6%、73.0%)、RiemannBench は 84.0%(両競合とも 80.0%)、Terminal-Bench-Science 0.1 は 70.5%(同 63.3%、68.0%)、HLE-Diamond は 71.3%(同 67.9%、64.0%)となりました。
マルチモーダル・長文脈・サイバーセキュリティ:MKA(Climb WSR)は 56.5%(同 53.0%、52.7%)、LVBench は 89.0%(同 83.7%、87.6%)、Chartography は 73.5%(Opus 5.5 の 66.3% を上回り、GPT-6.2 Sol の 75.1% に次ぐ)、GraphWalks(256k〜1M、BFS F1)は 95.2%(同 66.8%、80.1%)を達成。セキュリティ分野では CWE-Bench v2 で 70.7%、SEC-bench Pro で 90.5%、WebExploitBench v1.2 で 51.3%を記録しています。なお、公開 API のモデル ID やトークン料金表はまだ発表されていません。