目次
2026年11月12日、OpenAI は Python SDK v3.50.0(コミット f44c1ec/PR 4268)と Node SDK v7.56.0(PR 3145)をリリースし、Responses API のレスポンスオブジェクト(Response および BetaResponse)に読み取り専用の配列フィールド input_transformations を追加した。従来、ステートレス運用(store=False)や独自の履歴管理において過去のコンテキストを書き換えた際、暗号化済み推論アイテム(Reasoning items)がサーバー側で静かに破棄されても、開発者は reasoning_tokens の急増やレイテンシ悪化から推測するしかなかった。v3.50.0 以降は、除外された推論アイテムの ID と理由をレスポンスから直接取得できる。
input_transformations の構造と5種類の除外理由(reason)
input_transformations はリクエストパラメータではなく、レスポンス側に返却される診断用フィールドである。送信した input 内の推論アイテムがモデル実行前に除外された場合、入力順でオブジェクトが格納され、各要素には type(固定値 reasoning)、id(元の推論アイテム ID)、action(固定値 removed)、および以下5種類のいずれかを示す reason が含まれる。
prefix_mismatch(プレフィックス履歴の不一致・最頻出):新しいフロンティア推論モデルでは、送信された各推論アイテムより前の会話履歴(プレフィックス)が元の生成時と一致しているか検証される。推論アイテムより前のメッセージ編集、ツール出力の短縮、順序変更、途中挿入が行われると対象アイテムは除外される。
turn_boundary(ターン境界ポリシー):選択したモデルや reasoning.context の設定(auto と all_turns の違いなど)により、ターン境界を越えた推論の引き継ぎが許可されない場合に発生する。
model_mismatch(モデル不一致):継続リクエストで別のモデル ID へ切り替えたため、以前のモデルが生成した暗号化推論アイテムを再利用できなくなったケースである。
organization_mismatch(組織IDの不一致):推論アイテム生成時とは異なる OpenAI 組織 ID の認証情報で継続リクエストを送信した場合に発生する。
end_user_mismatch(エンドユーザー識別子の不一致):リクエストの user または safety_identifier の値が、推論アイテム生成時に指定された識別子と一致しない場合に除外される。
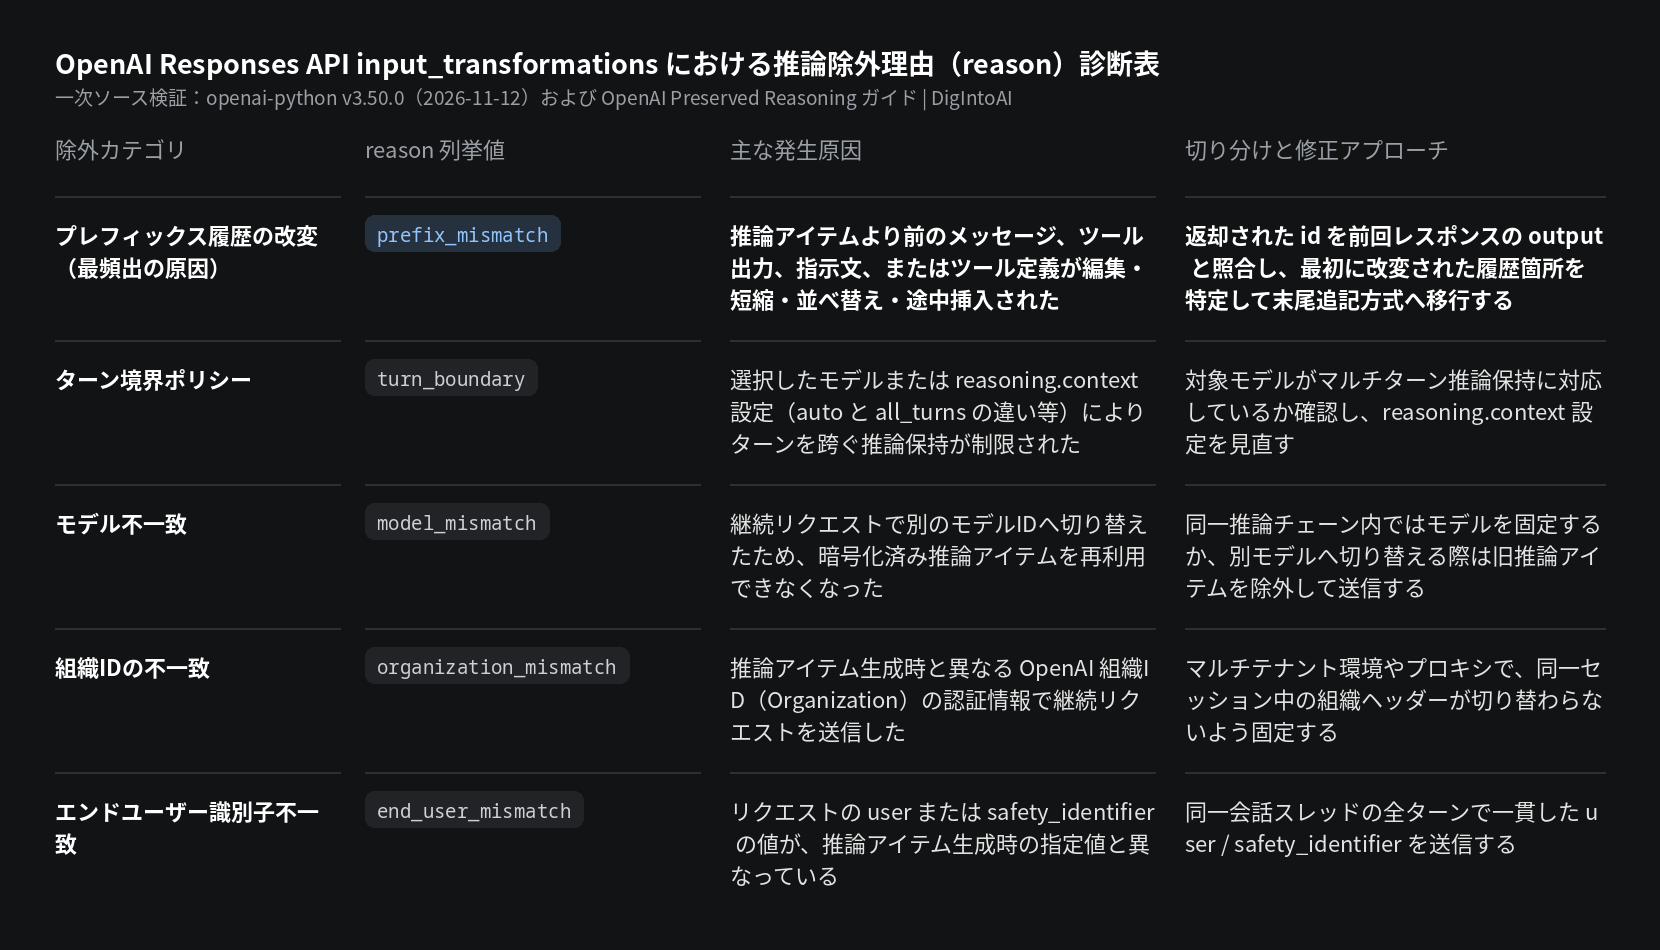
画像の出典:openai-python v3.50.0 の型定義および OpenAI API 公式ドキュメントをもとに DigIntoAI が作成。
サイレント除外の挙動と prefix_mismatch の4段階切り分け手順
トラブルシューティングで最も重要な点は、Responses API が prefix_mismatch を検出しても HTTP 400 エラーを返さないことである。API は該当する推論アイテムを静かに除外(action: removed)したうえで残りの履歴を使って処理を続行し、モデルにゼロから再推論を実行させる。そのため、エラーログが一切出ないまま推論トークン消費と応答時間だけが膨らむ現象が起きる。
公式ガイドの台帳検索の例では、ターン1で「ユーザー質問 → 推論A → ツール呼出 → 生の明細行 → 推論B」が生成された後、ターン2で過去の明細行を合計値テキストへ差し替えた場合、変更点より前にある推論Aはプレフィックスが保たれているため再利用される一方、変更点より後ろにある推論Bは一切改変していなくても prefix_mismatch として除外される。
openai-python v3.50.0 以降では、以下の4ステップで原因を特定できる。
ステップ1:response.input_transformations の記録:client.responses.create の実行後に input_transformations を確認し、空でない場合は各要素の id と reason をログに出力する。
ステップ2:アイテム ID から前回レスポンスを特定:報告された id を前回ターンの response.output と照合し、会話シーケンス内のどの位置にあった推論アイテムかを特定する。
ステップ3:前置プレフィックスの差分比較:該当推論アイテムより前に配置された入力リストを元の履歴と先頭から比較し、最初に改変・短縮・挿入が行われた箇所(過去の function_call_output の書き換え、instructions の変更、tools 配列の増減など)を洗い出す。
ステップ4:末尾追記型の履歴管理へ移行:肥大なツール出力は最初の function_call_output 送信前にフィルタリングを済ませ、後続ターンでデータが更新された場合は末尾に訂正メッセージを追加する。モード切替時は既知の tools 定義を固定し、tool_choice の allowed_tools または末尾の additional_tools で制御する。長文圧縮には OpenAI 純正のコンパクション機能を用い、独自要約文の後ろに旧推論アイテムを再送しないようにする。
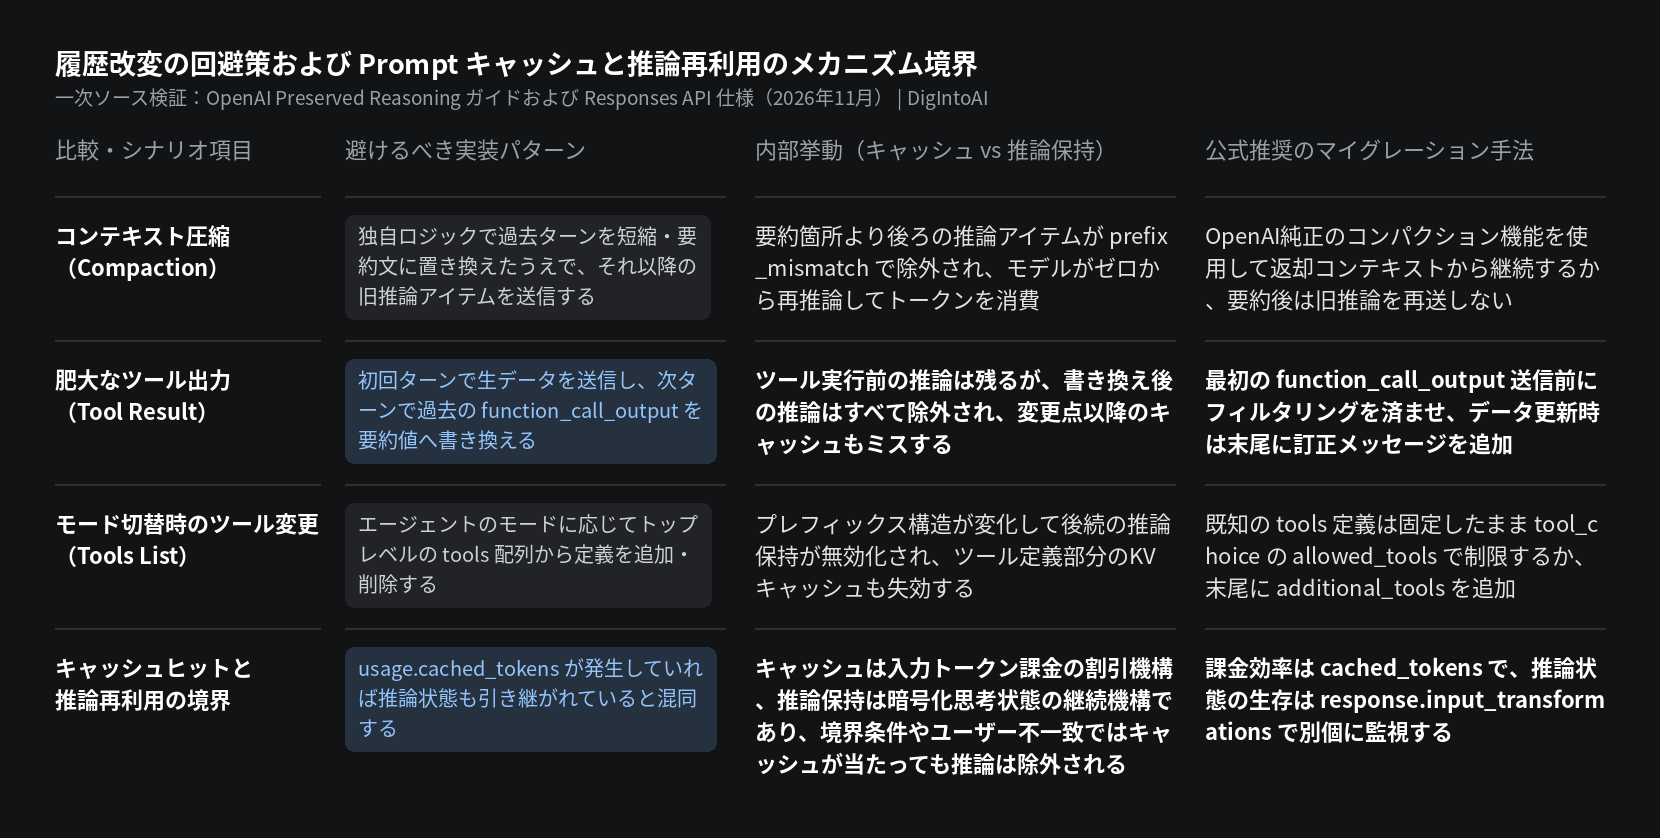
画像の出典:OpenAI Preserved reasoning 公式ガイドおよび Responses API 仕様をもとに DigIntoAI が作成。
Prompt キャッシュヒットと推論再利用を同一視できない理由
usage.input_tokens_details.cached_tokens が 0 より大きければ推論状態も引き継がれていると誤解されがちだが、Prompt キャッシュと推論保持は異なるレイヤーで動作している。
Prompt キャッシュは入力トークンの KV キャッシュ再利用と課金割引を担い、システムプロンプトや前半の会話テキストが一致していれば割引が適用される(ミス理由は prompt_cache_diagnostics で確認可能)。一方、Preserved Reasoning は暗号化済み思考連鎖の内部状態を復元する仕組みであり、プレフィックスの完全性に加えてモデル一致・組織一致・エンドユーザー識別子一致・reasoning.context 条件を満たす必要がある。
そのため、turn_boundary や end_user_mismatch によって推論アイテムがすべて除外されたリクエストであっても、静的なシステムプロンプト部分ではキャッシュヒットが発生し得る。実運用では入力コスト削減を測る cached_tokens と、推論状態の生存を測る response.input_transformations の双方を個別に監視することが不可欠である。