2026年11月20日、Thinking Machines Lab はテキスト・画像入力と 1M コンテキストに対応するループ型 MoE モデル「Inkling 2 Mini」を Apache 2.0 ライセンスで公開した(Hugging Face および Tinker API で提供)。
24層の重みで48層深度を実現するループ設計とネイティブ NVFP4 配備
中間12層3回ループと事後量子化劣化ゼロの約 20 GB チェックポイント:24層のうち中間12層の重みを共有して3回反復実行し、トークンあたり実質 5.4B パラメータ(128専門家中8個活性)で48層分の推論深度を得る。20層をネイティブ NVFP4、最終4層を MXFP8 で学習・配備するため変換劣化がなく、約 20 GB の単一ファイルで 1台の NVIDIA DGX Spark や 32 GB 以上の Apple Silicon Mac(Ollama/Exo Labs 等)上で動作する。スタンフォード Hazy Research Lab の初期計測(DGX Spark・MXFP8・低思考)ではワットあたり知能スコア 0.703 を記録し、Qwen3.6-35B-A3B(0.430)を大きく上回った。
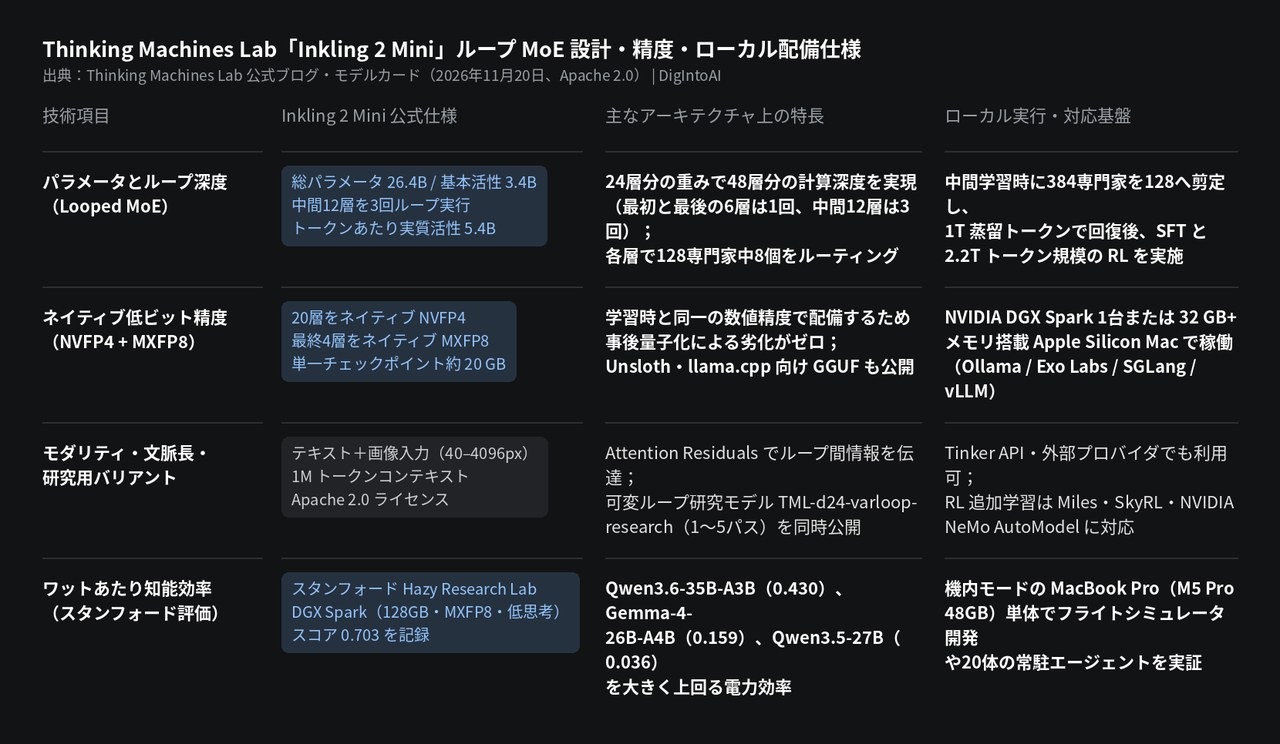
画像の出典:Thinking Machines Lab 公式ブログおよびモデルカードをもとに DigIntoAI が作成。
100B 未満コーディング首位と監視性検証・明確な弱点
ツール活用での優位性と多ターン対話・知識記憶の限界:100B 未満のオープンウェイト比較では DeepSWE v1.1(48.2%)、Vals Index v2.2(46.5%)、BrowseComp(79.0%)、MCP Atlas(82.7%)等で首位を報告。同時公開の可変ループ研究版 TML-d24-varloop-research では非 CoT 50% タスク時間地平が1パス16秒から3パス37秒へ伸び、CoT の可読性も維持された。一方で公式記事は、ループでは静的知識容量を増やせない点(AA-Omniscience -8.6)や、MultiChallenge(50.0%)および ComplexConstraints v1.1(33.4%)で Qwen3.8-27B に及ばない点を明記している。
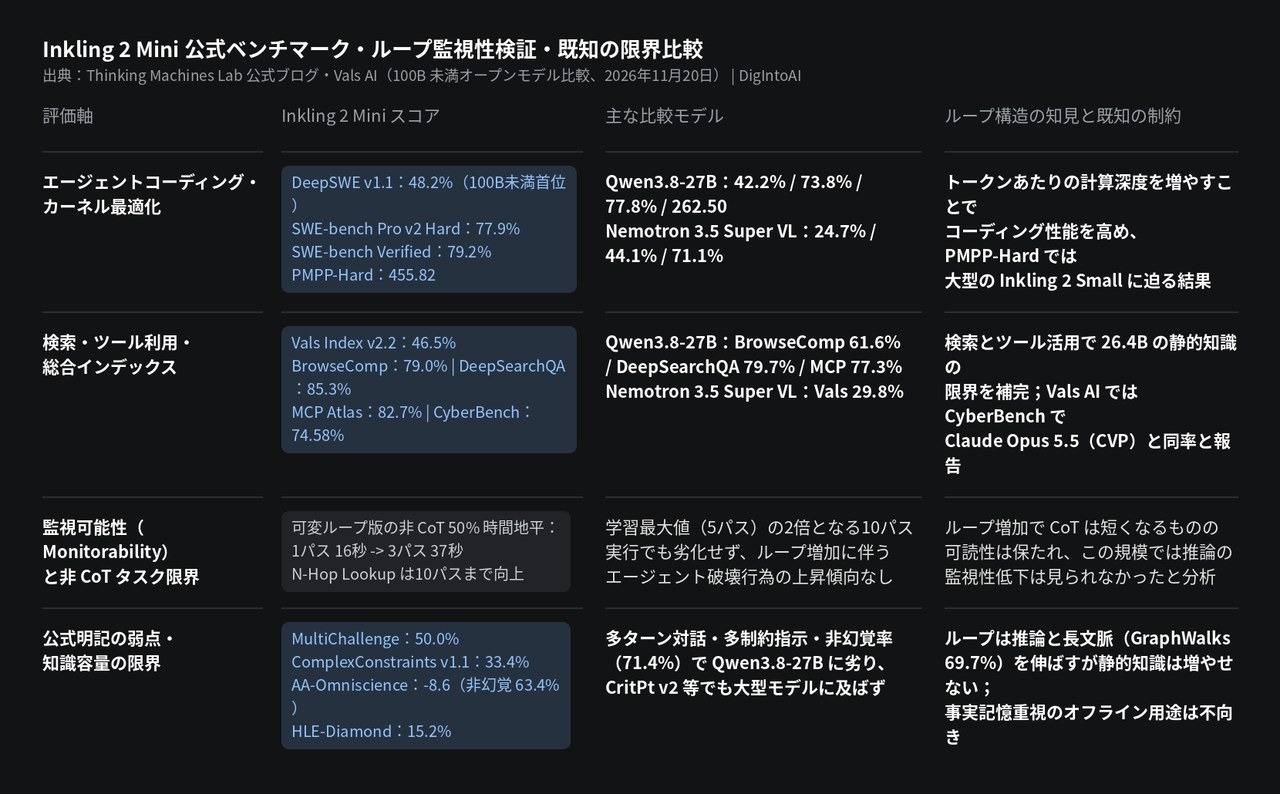
画像の出典:Thinking Machines Lab 発表記事および Vals AI 公表値をもとに DigIntoAI が作成。