目次
AI研究機関のZyphraは、多言語テキスト音声合成(TTS)およびゼロショット音声クローンモデル「ZONOS3-Mini」をHugging FaceとGitHubで公開した。なお、公開日時の表記については、Hugging Faceの技術ブログページ上部に「2026年11月12日公開」と記載されている一方、記事本文の署名欄では「11月11日」となっており、関連コミットも11月9日から12日にかけて行われている。公式側で単一の初回公開日時が確定されるまでは、いずれか一方を断定せず現在の公開リポジトリ状態を基準に解説する。
ライセンス面では、商用利用しやすい2段階のオープンソース形態が採られている。モデル重み(bf16のPyTorchチェックポイントおよび量子化GGUFファイル)はApache 2.0ライセンス、推論サーバーやブラウザ用WebGPUビルド、Web UI(Zonos Voice Studio)を含むランタイムコードはMITライセンスで公開されており、開発者は文字数や再生時間に応じたロイヤリティなしで自社サービスへ組み込める。
モデルアーキテクチャと43言語への対応
前世代のZonos2は8Bパラメータのバックボーンと86 Hzフレームレートの音声コーデックを組み合わせていたため、ブラウザや薄型ノートPCでのローカル実行が困難だった。ZONOS3-Miniでは音声表現と系列モデリングを刷新し、エッジ端末でもリアルタイム動作する軽量設計を実現している。
活性パラメータ100Mの疎なLatent MoEバックボーン:11層(モデル次元1,024)の言語モデルバックボーンは総パラメータ数800Mで、64エキスパートから上位2つを選択するLatent MoE構造により、1トークンあたりの実効計算パラメータを約100Mに抑えている。系列ミキサーにはGated DeltaNet層9層とグローバルGQAアテンション層2層を3対1の比率で交互配置し、最大32,768ポジションのコンテキスト長(連続最大10分間の音声生成)に対応する。
15 Hzデュアル音声コーデック ZAC-1 と 44.1 kHz出力:同時にオープンソース化された専用コーデック「Zyphra Audio Codec 1(ZAC-1)」は、44.1 kHz音声を毎秒わずか15フレーム(15 Hz)の10コードブック(Wav2Vec2-BERT 2.0由来の意味コードブック1つ+音響RVQコードブック9つ)へ圧縮する。因果マルチ解像度iSTFTデコーダ(標準のfull-mrと約3倍高速な軽量版keep2-plainを選択可能)により、フレーム生成と同時に44.1 kHz波形をストリーミング出力する。
日本語・中国語・英語を含む43言語と音声制御:モデルカードには東アジア・東南アジア・南アジア・欧州・中東の43言語が列挙されており、日本語(Japanese)、中国語(Mandarin Chinese)、英語(English)が明記されている。推論時のテキスト前処理にはRust移植版のNeMoテキスト正規化(zyphra-textnorm)が組み込まれており、日本語・中国語・英語・韓国語および欧州主要5言語の数値や記号の読み方を正規化したうえで8,192語彙のSuperBPEトークナイザへ渡す。また、5〜60秒の参照音声からのゼロショット声質複製や、192次元話者ベクトルによる年齢感・声質・感情・話速の制御にも対応する。
ブラウザとローカル端末での4つの実行方法
GitHubリポジトリに収録されているすべての実行バックエンドは、OpenAI互換の /v1/audio/speech エンドポイントおよび独自の /v2/generate エンドポイントを共通して備えており、同じZonos Voice Studio画面から操作できる。
経路1:ブラウザ WebGPU によるインストール不要のクライアント実行(servers/web):WebGPUとWeb Workerを活用し、Chrome・Edge・Safariなどの対応ブラウザ上でユーザー自身のGPUを使って推論を完結させる方式である。Python環境やバックエンドのGPUサーバーは一切不要で、初回アクセス時(または ?api=web パラメータ付きで起動時)にWebGPU用分割重みがブラウザにキャッシュされ、2回目以降はオフラインでも動作する。
経路2:Apple Silicon Mac ネイティブ MLX サーバー(servers/mlx):M1〜M3以降のMacでは、uvによるPython 3.12環境とRustツールチェーン(テキスト正規化モジュールのビルド用)を準備し、Hugging FaceからGGUF形式の重みを取得して起動スクリプトを実行するだけで、ローカルの1919番ポートで音声合成サーバーが立ち上がる。Zyphraの公表値では、M3 MacBook Airでの初回音声到達時間(TTFA)は150 ms未満、Pixel 9のブラウザWebGPU上では570 ms未満とされている。
経路3:クロスプラットフォーム C++ / ggml 単体実行(servers/ggml):WindowsノートPCやLinux CPU環境、あるいはPythonランタイムを同梱できないデスクトップアプリ向けには、C++とggmlで実装された単体サーバー・CLIが用意されている。CPU・CUDA・Metal・Vulkanの各バックエンドで動作し、GGUF重みと27種類の多言語デフォルトボイスをそのまま利用できる。
経路4:NVIDIA GPU 高スループットサーバーとオフラインPython API(servers/sgl):NVIDIA GPUとCUDA 12.8を備えたLinuxサーバーでは、Mini-SGLangバックエンド(またはSGLang-Omni)を用いて約9 GBのbf16 PyTorch重みを配信できる。単一のH100 80GB GPU・8並列リクエスト時の中央TTFAは80 ms、ピーク処理速度は実時間の457倍と報告されており、バッチ処理用のオフラインPython APIも同梱されている。
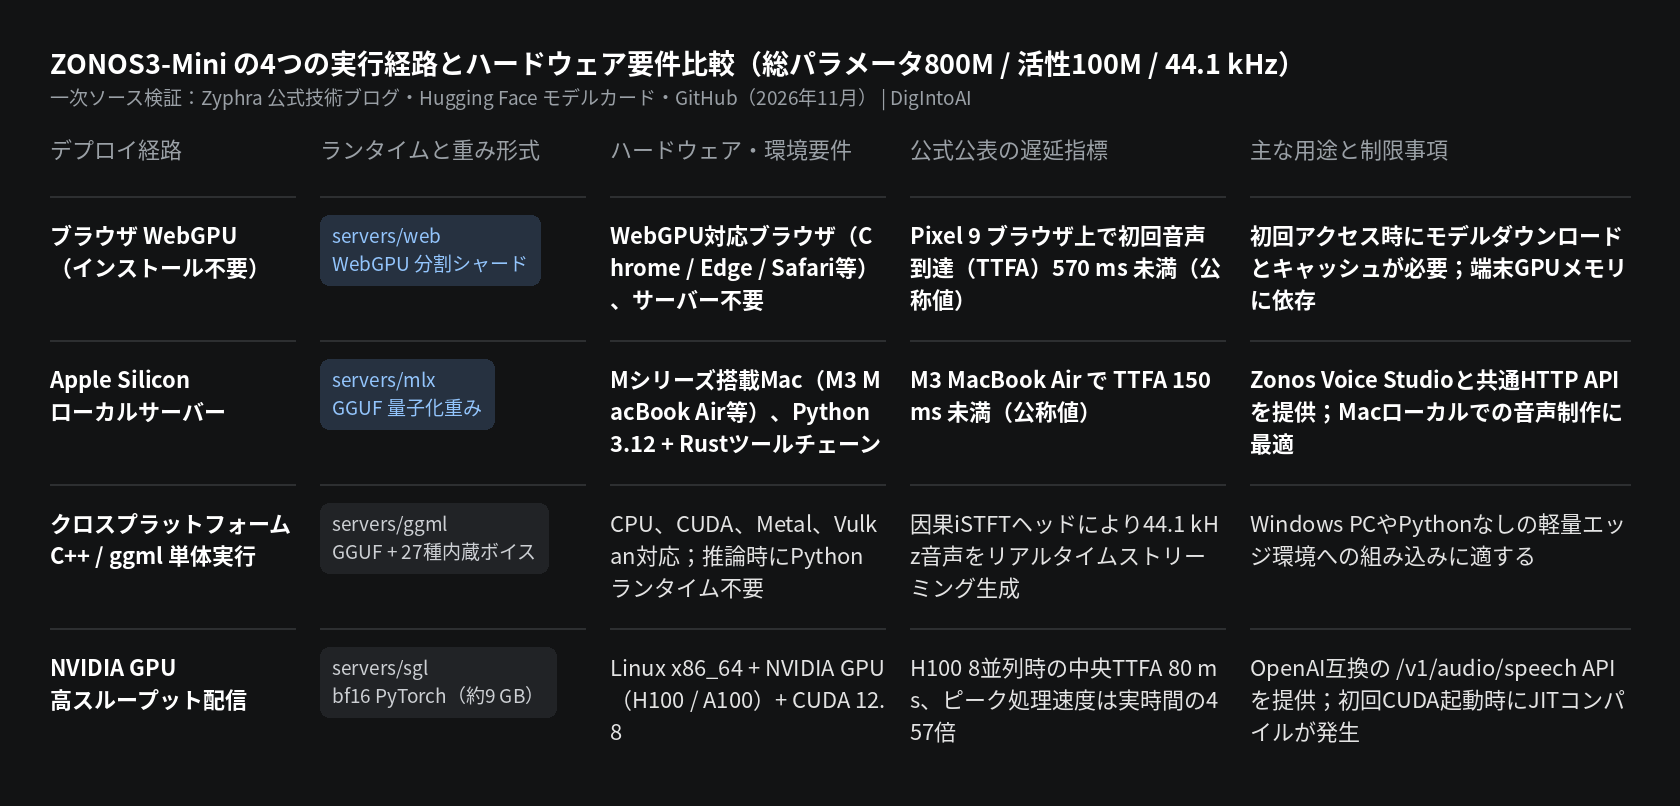
画像の出典:Zyphra 公式技術ブログ、Hugging Face モデルカード、GitHub リポジトリをもとに DigIntoAI が作成。
クラウド音声 API とのコストおよび設計境界の比較
日本語・中国語・英語向けの音声機能を実装する際、ZONOS3-Miniのローカル/ブラウザ運用とクラウドTTS APIのどちらを選ぶべきかは、以下の3つの軸で整理できる。
従量課金コストとインフラ費用の違い:クラウドTTS APIは文字数や生成秒数に応じた従量課金が基本となる。2026年11月時点の公開価格では、OpenAIのtts-1が100万文字あたり15ドル、tts-1-hdが30ドル、gpt-4o-mini-ttsが1分あたり約0.015ドルに設定されている。またElevenLabsはFlash v2.5およびv4 Turboが1,000文字あたり0.04ドル(100万文字あたり40ドル)、多言語主力モデルのEleven v4が1,000文字あたり0.08ドル(100万文字あたり80ドル)となっている。これに対しZONOS3-Miniはライセンス料・API従量課金ともに0円であり、ブラウザWebGPU方式であれば推論計算をすべてエンドユーザー端末側で処理できるため、開発者側のサーバー負担は静的モデルファイルの配信帯域のみに抑えられる。
プライバシー保護とオフライン動作:クラウドAPIでは入力テキストや参照音声を外部サーバーへ送信する必要があるが、WebGPUやローカルのggml/MLX環境であればすべてのデータが端末内または社内閉域網にとどまるため、機密性の高い業務アプリやオフライン端末でも安心して利用できる。
音声クローンの自由度と追加モジュールの条件:OpenAI TTSなどの標準クラウドAPIは9〜13種類の固定ボイスのみを提供し、任意の参照音声によるゼロショット複製には対応していない。ZONOS3-Miniは基本構成のままゼロショット複製を行える一方、生成後の部分音声編集(Speech Editing)や音素指定を利用するには、別配布の編集用LoRA、強制アライメントモデルFuseAlign(1.34 GB)、および音声認識モデルQwen3-ASR-1.7Bを追加導入する必要がある。
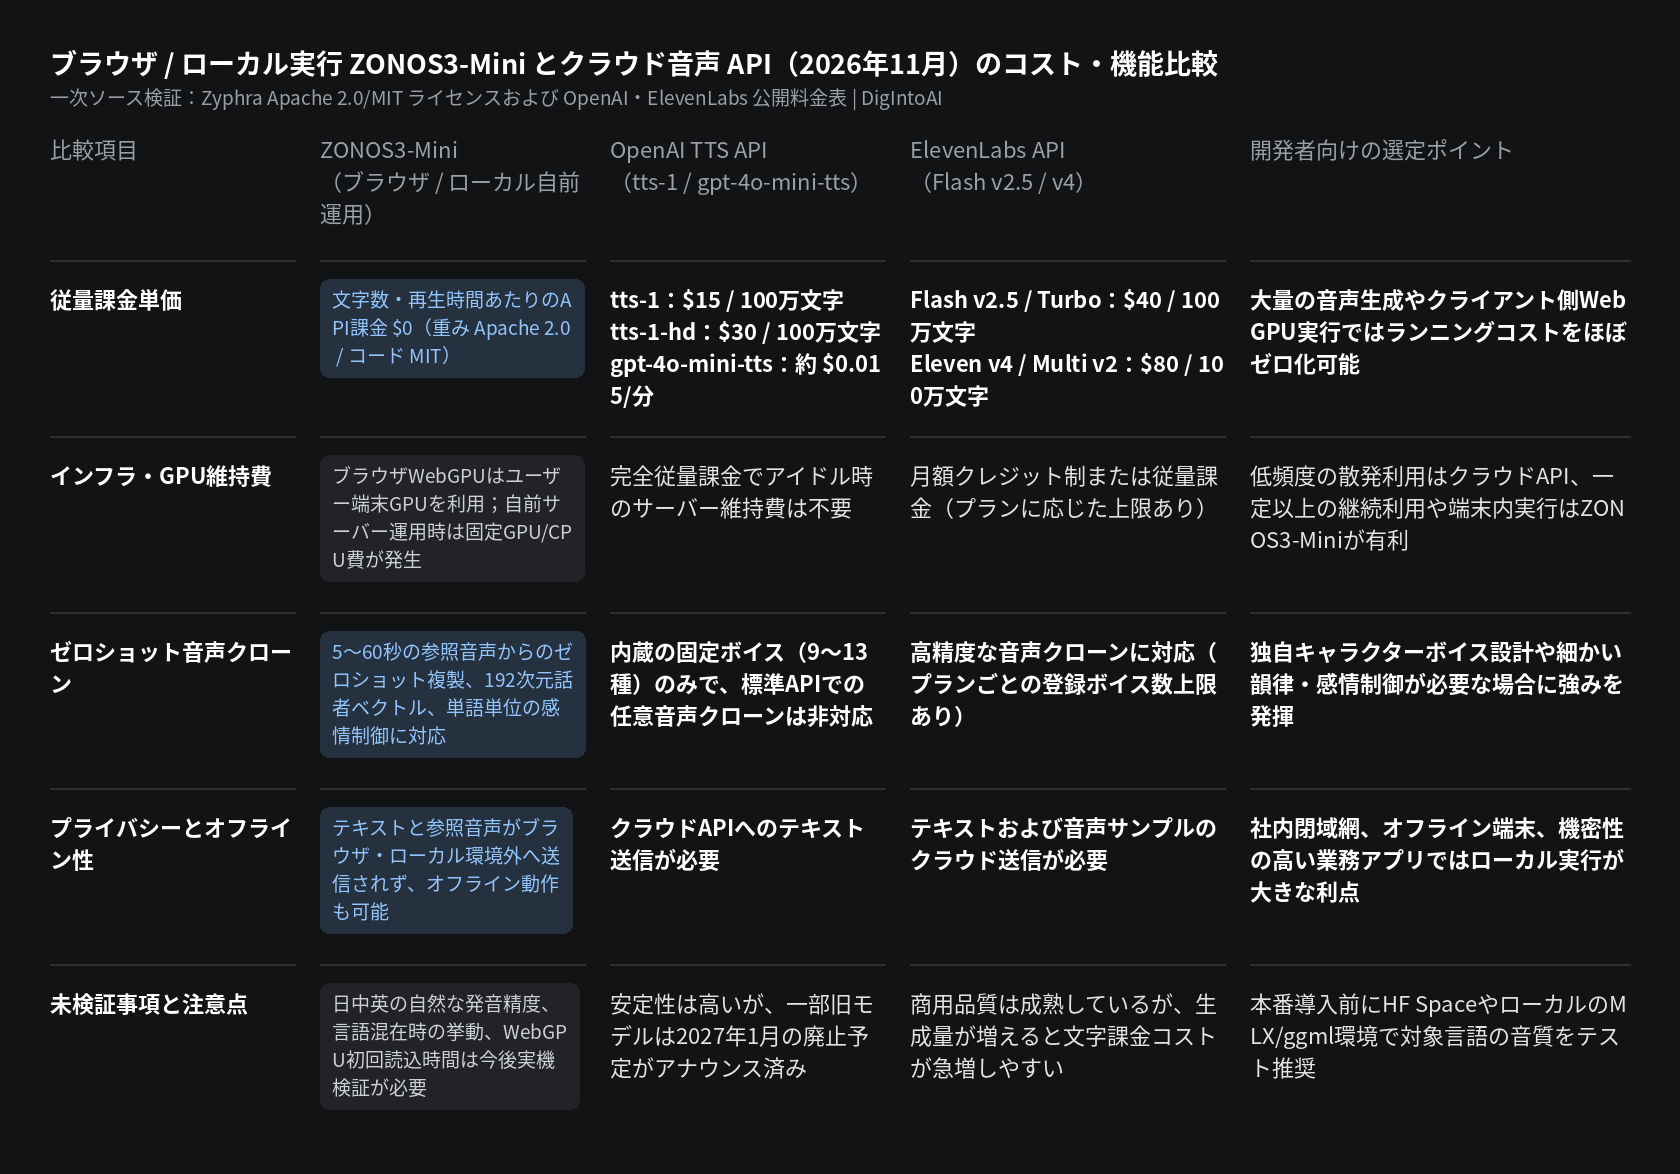
画像の出典:Zyphra ライセンス規定および OpenAI・ElevenLabs 公開料金表をもとに DigIntoAI が作成。
対象外事項および今後の実機検証ポイント
汎用テキスト対話モデルではない:内部にMoE言語モデル構造を備えているものの、15 Hz音声トークン予測に特化した音声合成モデルであり、チャットボットとしてテキストの質問応答を行う用途には使えない。
ブラウザ実行時の初回ダウンロードとVRAM制約:インストール不要とはいえ初回アクセス時には数百MB規模のモデルシャードをダウンロードする必要があり、低速回線での待ち時間やモバイル端末のGPUメモリ上限には注意が必要となる。
日中英の実際の音質と処理速度は今後の実測が必要:本記事で言及した80 ms・150 ms・570 msの遅延数値およびZTTS2-Eval評価結果はすべてZyphra公式発表値である。日本語のピッチアクセントの自然さ、中国語の声調精度、言語混在時の読み上げ品質、および一般的なコンシューマーGPUでの実測速度については、今後当サイトで実機検証を行う予定だ。