目次
2026年11月18日(日本時間19日未明)、フリーランスデザイン基盤の Contra Labs と評価インフラ企業の BenchFlow は、実務レベルの Web・アプリデザイン能力を測る「Frontier Design Benchmark」を発表した。全17エントリー(AI モデル16種+人間デザイナー基準1種)のうち、開発元非公開のステルスモデル「Gestalt」が 11月19日時点のライブ順位表で Elo 1931(勝率 90%)を記録し、人間基準(Elo 1739)を超えた初のモデルとなった。
順位表の全体像と 204 Elo の二極化構造
発表記事スナップショットとライブ順位表の数値整理:11月18日公開のブログ本文時点では Gestalt が Elo 1,928(勝率 89%、423戦378勝)、Claude Fable 5.2 が 1,714 だったが、11月19日のライブ順位表(総投票数 4,311票)では Gestalt が Elo 1931(勝率 90%、95%信頼区間 86%–92%、420票)、2位の Human golden が Elo 1739(勝率 74%、571票)となっている(人間基準との直接対決では 28戦中 20戦で Gestalt が選出)。公開済みモデルでは上位6種(Claude Fable 5.2[1713・$127.22〜]、Claude Opus 5.5[1691・$24.26]、GPT-6.1 Sol[1668・$1.31]、Claude Sonnet 5.5[1667・$20.49]、Kimi K3.1 Pro[1663・$1.91]、GPT-6 Astra[1638・$7.33])と、9位の Qwen3.8 Max(1434)以下の9モデル群との間に 204 Elo の大きな断層が見られる。
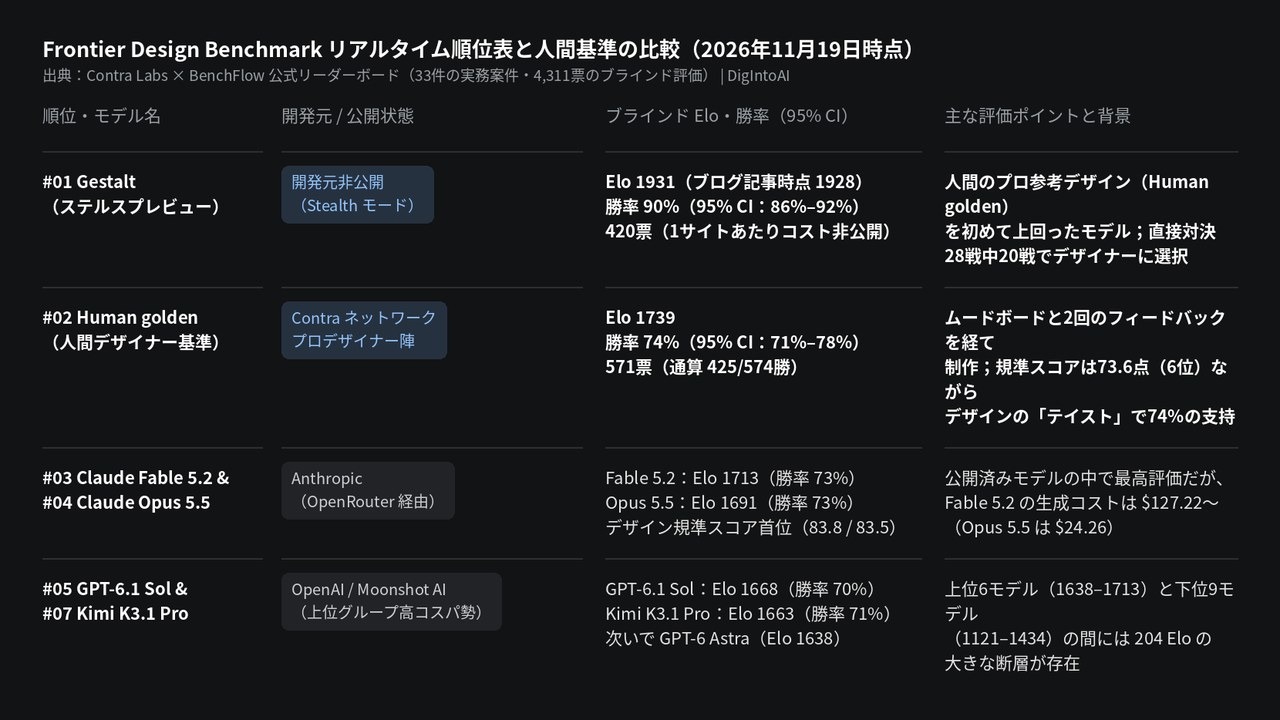
画像の出典:Contra Labs × BenchFlow 公式リーダーボードをもとに DigIntoAI が作成。
33件の実務案件・規準スコアと人間テイストの乖離・AI Slop 検出
実案件テストと評価指標の役割分担:Contra の実案件を改変した 27件とスタートアップ実プロジェクト 6件(ロゴ支給 19件、モバイル要件 17件)を用い、BenchFlow が各社固有の Agent Harness 上で実装・評価を実施。プロデザイナー35名によるブラインド投票に加え、34/35項目のデザイン規準(Design Rubric)と 0〜100 スケールの「AI Slop 検出器」を導入した。モデルの規準スコアは Elo と r = 0.94 で相関する一方、人間参考稿はボタンコントラスト等の細部減点により規準 73.6点(6位)にとどまりつつ、審美眼(テイスト)を問うブラインド投票では 74%(425/574票)を獲得。また AI Slop 検出器では人間基準が 0.9、Gestalt が 1.2 と低く(見出し上の小さな大文字ラベルや 01/02/03 番号見出し、カード多用などの AI テンプレート癖が少ない)、Claude(31–38)、GPT(41–53)、Gemini(54–57)と対照的な結果となった。
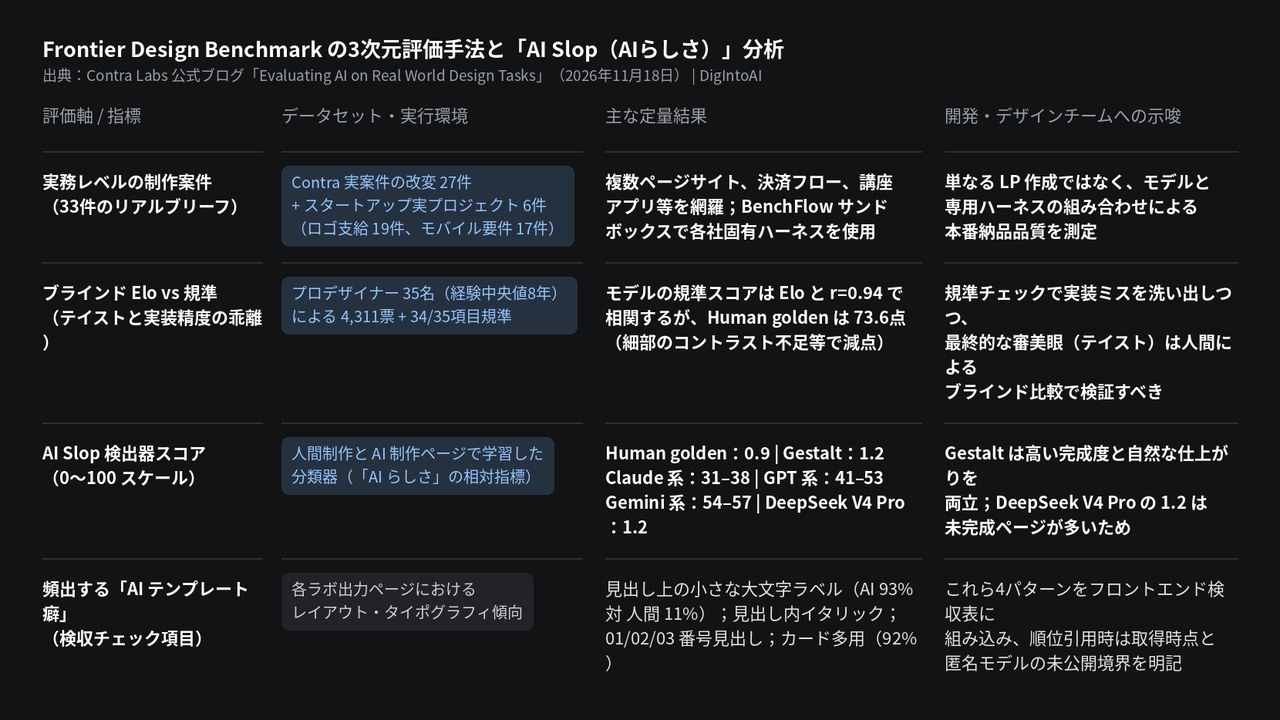
画像の出典:Contra Labs 公式ブログの方法論と評価結果をもとに DigIntoAI が作成。
Gestalt の正体と引用時のファクト境界
ステルス状態の尊重と評価範囲の限定:Contra Labs および BenchFlow は Gestalt について「現在ステルス段階にある高品質デザインモデル」とのみ説明しており、開発企業・パラメータ数・生成コスト・一般公開時期はいずれも非公開となっている。本ランキングは汎用知能ではなく商用 Web・UI デザイン特化評価であり、モデル単体ではなく専用ハーネスを含めた総合力の結果である点に留意する必要がある。