
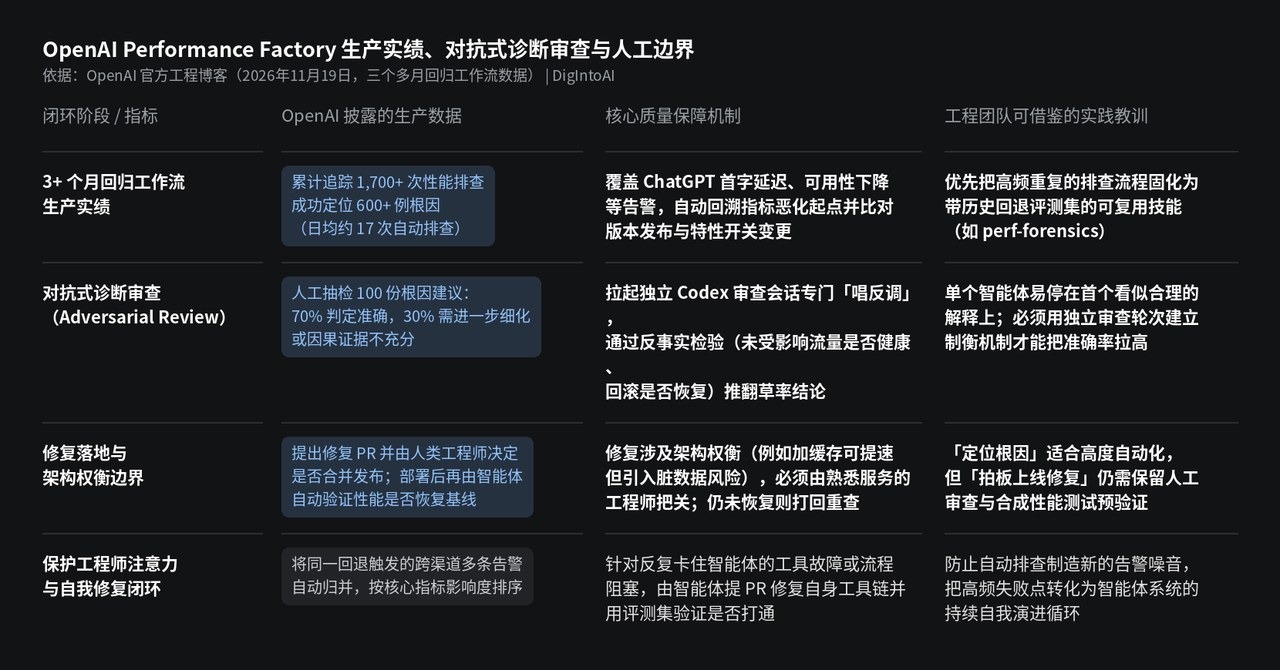
2026 年 11 月 19 日,OpenAI 技术团队成员 Okay Zed 与 Cyrus Forbes 发表工程长文《How OpenAI's Performance Factory keeps ChatGPT fast》,首次完整揭秘 OpenAI 内部用于保障 ChatGPT 响应速度的自主性能工程系统——Performance Factory。随着 AI 辅助开发大幅加快代码迭代节奏,传统依赖资深工程师人工翻看监控、查链路、读源码排查性能回退的模式已难以为继。OpenAI 披露,其首个投入生产的「回归工作流(Regression Workflow)」在三个多月内已追踪超 1,700 次性能排查、成功定位超 600 例根因,折合日均执行约 17 次自动化排查。
从「人类传话筒」到智能体工厂:四大核心组件架构
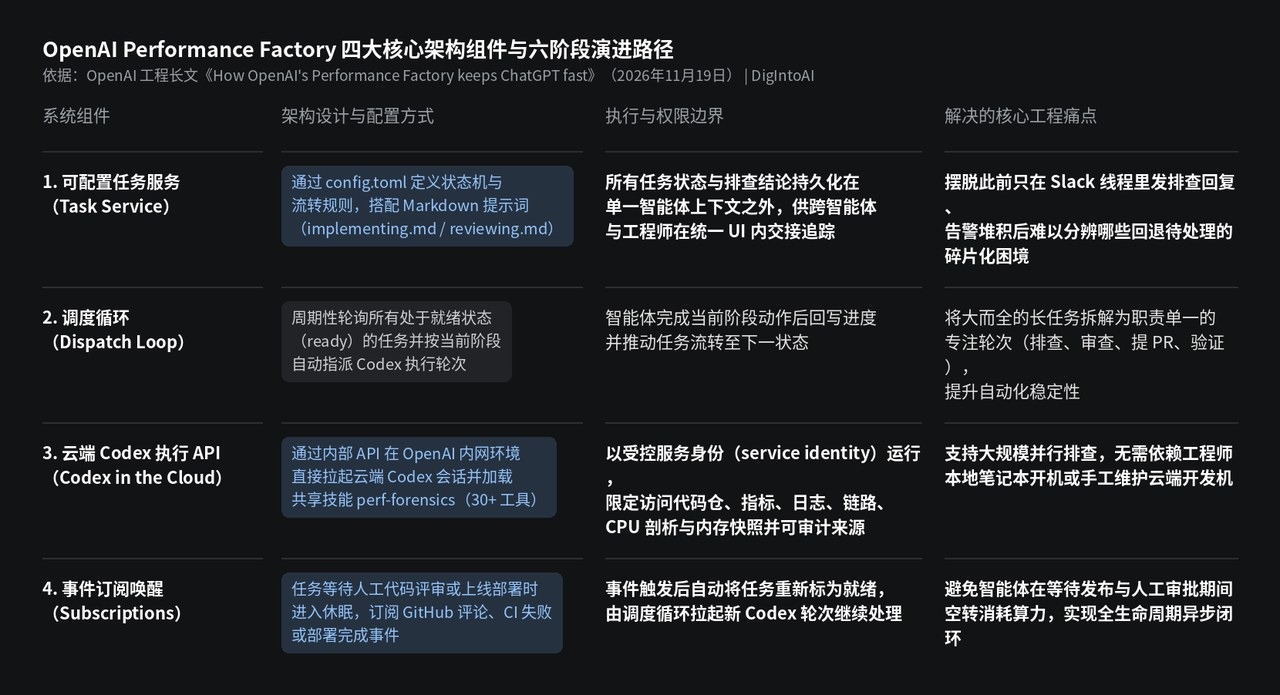
封装 30 余款内部工具为共享技能,摆脱 Slack 碎片化接力:OpenAI 坦诚梳理了团队引入 Codex 后的六个真实演进阶段:从最初纯手工积累 30 余款 CPU 与内存分配剖析工具,到工程师结对引导 Codex 查代码;随后团队把资深性能工程师的排查手册封装进共享技能 perf-forensics(指导 Codex 定位恶化起点、比对受影响请求群组、排查发布与特性开关变更,并用历史回退案例构建评测集持续打磨)。但很快团队发现自己沦为了告警系统与 Codex 之间的「人类传话筒」,即便把告警排查搬上云端自动发进 Slack,面对海量告警线程依然难以分清轻重缓急。为此,OpenAI 构建了端到端状态化编排系统 Performance Factory。
任务服务、调度循环、云端 Codex 与事件订阅闭环:整个工厂由四大核心模块构成:第一,可配置任务服务(Task Service),工程师通过 config.toml 定义状态流转与人工审批节点,并用 Markdown 文件(如 implementing.md 与 reviewing.md)编写各阶段智能体提示词,所有任务状态与中间发现持久化保存在单一智能体上下文之外;第二,调度循环(Dispatch Loop),周期性拉取就绪任务并按当前状态派发专注轮次;第三,云端 Codex 执行 API,在 OpenAI 内网环境以受控服务身份(service identity)启动会话,拥有可审计的代码库、日志、链路追踪、CPU 剖析与内存快照访问权限,彻底脱离工程师个人笔记本并行运转;第四,事件订阅唤醒(Subscriptions),当任务等待人工代码评审或版本部署时自动休眠,待 GitHub 评论、CI 失败或部署完成事件到达后再重新唤醒调度。
图片来源:DigIntoAI 根据 OpenAI 官方工程文章《How OpenAI's Performance Factory keeps ChatGPT fast》整理制作。
对抗式诊断审查与真实工程边界:为何「提修复」仍需人类拍板
独立 Codex 审查者「唱反调」,将草率归因拦在写代码之前:在回归工作流中,一项性能告警会依次经过「系统检测 → 智能体查根因 → 智能体提修复 → 工程师评审与部署 → 智能体验证恢复 → 闭环解决(若未恢复则打回重查)」六个阶段。OpenAI 透露,早期智能体经常停在第一个「看起来说得通」的解释上,导致归因失误;为此团队引入了对抗式诊断审查(Adversarial Review)——拉起一个独立的 Codex 会话专门试图推翻前序诊断,通过反事实检验核查未受影响流量是否健康、回滚后指标是否恢复。文中举例称,曾有智能体将对话报错归咎于文件定位服务故障,但审查会话发现定位服务早已恢复而图片下载仍在失败,从而及时驳回并重启排查。在 OpenAI 人工抽检的 100 份根因建议中,70% 被评定为准确,其余 30% 仍需进一步细化或因果链条尚不完整。
保护工程师注意力与架构权衡的人工底线:OpenAI 强调,相比定位根因,真正困难的是修复回退:许多性能优化涉及深层架构权衡(例如引入缓存虽能降低延迟,但可能带来数据过期一致性风险),必须由熟悉业务上下文的人类工程师决定是否合入上线;目前团队正引入合成性能测试,让智能体在提交人工审阅前先量化验证补丁效果。此外,Performance Factory 还会自动归并由同一回退引发的跨渠道重复告警并按核心指标影响排序,同时让智能体对反复阻塞自身的工具链故障提交自修复 PR,为所有计划建设生产级 Agent 工作流的工程团队提供了极具参考价值的落地产物与安全边界。
图片来源:DigIntoAI 根据 OpenAI 官方工程文章整理制作。