
2026 年 11 月 19 日,OpenAI 技術團隊成員 Okay Zed 與 Cyrus Forbes 發表工程長文《How OpenAI's Performance Factory keeps ChatGPT fast》,首次完整揭秘 OpenAI 內部用於保障 ChatGPT 響應速度的自主效能工程系統——Performance Factory。隨著 AI 輔助開發大幅加快程式碼迭代節奏,傳統依賴資深工程師人工翻看監控、查鏈路、讀源碼排查效能回退的模式已難以為繼。OpenAI 披露,其首個投入生產的「回歸工作流(Regression Workflow)」在三個多月內已追蹤超 1,700 次效能排查、成功定位超 600 例根因,折合日均執行約 17 次自動化排查。
從「人類傳話筒」到智能體工廠:四大核心元件架構
封裝 30 餘款內部工具為共享技能,擺脫 Slack 碎片化接力:OpenAI 坦誠梳理了團隊引入 Codex 後的六個真實演進階段:從最初純手工累積 30 餘款 CPU 與記憶體分配剖析工具,到工程師結對引導 Codex 查程式碼;隨後團隊把資深效能工程師的排查手冊封裝進共享技能 perf-forensics(指導 Codex 定位惡化起點、比對受影響請求群組、排查推出與特性開關變更,並用歷史回退案例構建評測集持續打磨)。但很快團隊發現自己淪為了告警系統與 Codex 之間的「人類傳話筒」,即便把告警排查搬上雲端自動發進 Slack,面對海量告警討論串依然難以分清輕重緩急。為此,OpenAI 構建了端到端狀態化編排系統 Performance Factory。
任務服務、調度循環、雲端 Codex 與事件訂閱閉環:整個工廠由四大核心模組構成:第一,可設定任務服務(Task Service),工程師透過 config.toml 定義狀態流轉與人工審批節點,並用 Markdown 檔案(如 implementing.md 與 reviewing.md)編寫各階段智能體提示詞,所有任務狀態與中間發現持久化儲存在單一智能體上下文之外;第二,調度循環(Dispatch Loop),週期性輪詢就緒任務並按當前狀態派發專注輪次;第三,雲端 Codex 執行 API,在 OpenAI 內網環境以受控服務身分(service identity)啟動會話,擁有可審計的程式碼庫、日誌、鏈路追蹤、CPU 剖析與記憶體快照訪問權限,徹底脫離工程師個人筆電並行運轉;第四,事件訂閱喚醒(Subscriptions),當任務等待人工程式碼評審或版本部署時自動休眠,待 GitHub 評論、CI 失敗或部署完成事件到達後再重新喚醒調度。
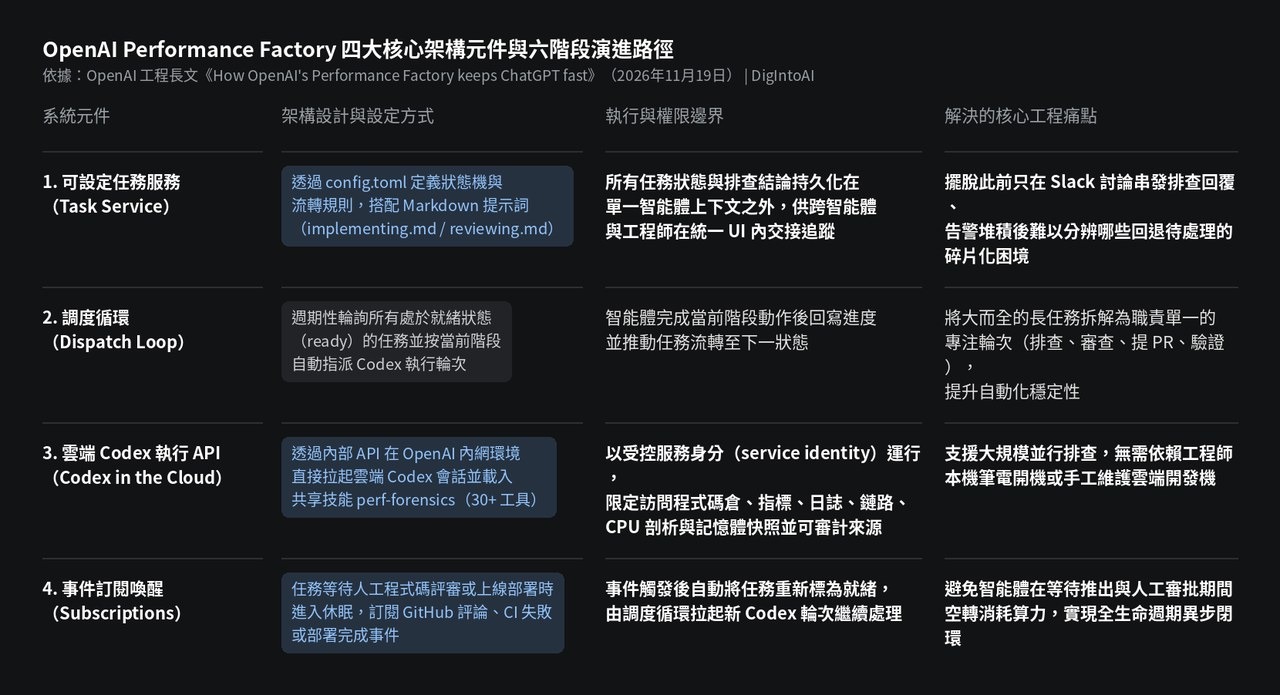
圖片來源:DigIntoAI 根據 OpenAI 官方工程文章《How OpenAI's Performance Factory keeps ChatGPT fast》整理製作。
對抗式診斷審查與真實工程邊界:為何「提修復」仍需人類拍板
獨立 Codex 審查者「唱反調」,將草率歸因攔在寫程式碼之前:在回歸工作流中,一項效能告警會依次經過「系統檢測 → 智能體查根因 → 智能體提修復 → 工程師評審與部署 → 智能體驗證恢復 → 閉環解決(若未恢復則打回重查)」六個階段。OpenAI 透露,早期智能體經常停在第一個「看起來說得通」的解釋上,導致歸因失誤;為此團隊引入了對抗式診斷審查(Adversarial Review)——拉起一個獨立的 Codex 會話專門試圖推翻前序診斷,透過反事實檢驗核查未受影響流量是否健康、回滾後指標是否恢復。文中舉例稱,曾有智能體將對話報錯歸咎於檔案定位服務故障,但審查會話發現定位服務早已恢復而圖片載入仍在失敗,從而及時駁回並重啟排查。在 OpenAI 人工抽檢的 100 份根因建議中,70% 被評定為準確,其餘 30% 仍需進一步細化或因果鏈條尚不完整。
保護工程師注意力與架構權衡的人工底線:OpenAI 強調,相比定位根因,真正困難的是修復回退:許多效能優化涉及深層架構權衡(例如引入快取雖能降低延遲,但可能帶來資料過期一致性風險),必須由熟悉業務上下文的人類工程師決定是否合入上線;目前團隊正引入合成效能測試,讓智能體在提交人工審閱前先量化驗證補丁效果。此外,Performance Factory 還會自動歸併由同一回退引發的跨渠道重複告警並按核心指標影響排序,同時讓智能體對反覆阻塞自身的工具鏈故障提交自修復 PR,為所有計劃建設生產級 Agent 工作流的工程團隊提供了極具參考價值的落地產物與安全邊界。
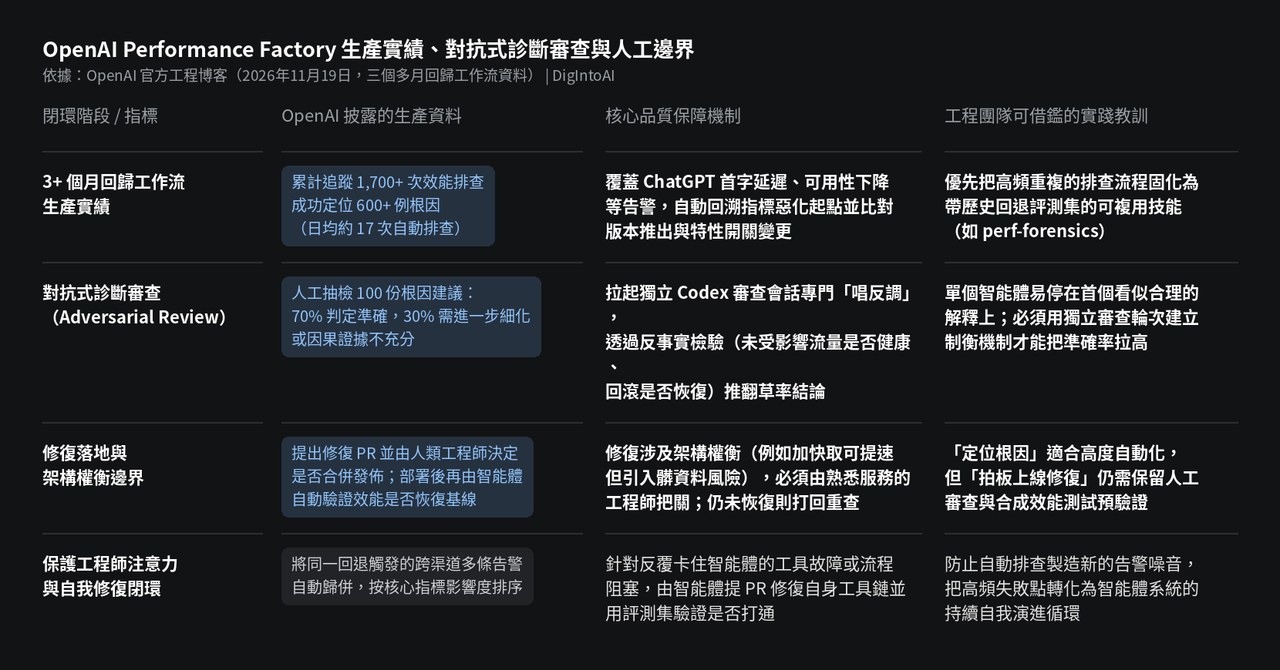
圖片來源:DigIntoAI 根據 OpenAI 官方工程文章整理製作。