
本文目錄
人工智能研究機構 Zyphra 近期在 Hugging Face 與 GitHub 同步公開了新一代多語言文本轉語音(TTS)模型 ZONOS3-Mini。需要提前說明的是,其 Hugging Face 技術文章頁面頂部標註的發布日期為 2026 年 11 月 12 日,而正文作者欄署期為 11 月 11 日,官方主頁與代碼提交記錄亦跨越 11 月 9 日至 12 日;在官方進一步統一口徑前,本文暫不將其中任一日期作為確定的首次上線時間,僅以當前公開的權重與代碼倉庫狀態為準。
在授權協議方面,ZONOS3-Mini 採用了對商業整合較為友好的雙許可拆分布局:模型權重(包含完整的 bf16 PyTorch 檢查點與量化後的 GGUF 檔案)以 Apache 2.0 協議發布,而配套的推理服務端、瀏覽器 WebGPU 構建腳本以及前端工作室介面(Zonos Voice Studio)則以 MIT 協議在 GitHub 開源。對於希望在私有環境或客戶端側整合本地語音合成的開發者而言,無需向模型方支付按字符或按分鐘計費的授權費用。
模型架構與 43 種語言支援範圍
上一代 Zonos 模型採用 8B 參數骨幹網絡配合 86 Hz 幀率音訊編解碼器,在瀏覽器與輕薄筆記型電腦上部署門檻較高。ZONOS3-Mini 透過重新設計音訊編解碼器與序列混合層,將模型壓縮至邊緣設備可即時運行的體量:
100M 激活參數的稀疏混合專家骨幹:模型主體由 11 層網絡構成(隱藏維度 1,024),總參數量為 800M,其中前饋層採用包含 64 個專家、每次路由激活前 2 個專家的 Latent MoE 結構,使單個 Token 的實際計算激活參數控制在約 100M。序列混合採用 3 比 1 的混合比例,由 9 層 Gated DeltaNet 循環層與 2 層全局分組查詢注意力(GQA)層交替組成,支援最長 32,768 位置的上下文視窗,單次連續生成最長可達 10 分鐘音訊。
15 Hz 雙編碼器 ZAC-1 與 44.1 kHz 輸出:Zyphra 同步開源了專用音訊編解碼器 Zyphra Audio Codec 1(ZAC-1)。它將 44.1 kHz 採樣率音訊壓縮為每秒僅 15 幀(15 Hz)的離散編碼,每幀包含 10 個碼本(第 0 號碼本蒸餾自 Wav2Vec2-BERT 2.0 的語義特徵,其餘 9 個碼本為聲學殘差向量量化)。解碼端採用因果多解析度逆短時傅立葉變換(iSTFT)頭,支援標準模式(full-mr)與精簡模式(keep2-plain,官方稱解碼速度可再提升約 3 倍),每生成一幀即可串流輸出音訊波形。
43 種支援語言與音色控制機制:模型卡列出的 43 種語言覆蓋東亞、東南亞、南亞、歐洲及中東地區,明確包含中文(Mandarin Chinese)、英文(English)與日文(Japanese)。其中文本前端內置了基於 Rust 移植的 NeMo 文本正則化模組(zyphra-textnorm),專門針對中文、英文、日文、韓文及五種歐洲主要語言的數字、日期與符號讀法做了規則處理(其餘語言按原文直通送入 8,192 詞表的 SuperBPE 分詞器)。音色方面支援上傳 5 至 60 秒參考音訊進行零樣本克隆,也可載入 192 維 MECT-B2 說話人向量調節年齡感、音色明亮度、語速、響度與情緒傾向。
如何在瀏覽器與本地設備上部署運行?
根據 GitHub 倉庫的運行說明,所有本地與服務端後端均共享同一套 HTTP 介面協議(兼容 OpenAI 的 /v1/audio/speech 端點以及原生的 /v2/generate 端點)和同一套 Zonos Voice Studio 網頁交互介面。開發者可以根據目標硬體選擇以下四條運行路徑:
路徑一:瀏覽器 WebGPU 零安裝純前端運行(servers/web):這是門檻最低的體驗與端側整合方式。藉助 WebGPU 與 Web Worker 技術,ZONOS3-Mini 可以直接在用戶的 Chrome、Edge 或 Safari 瀏覽器內調用本地顯示卡完成推理,整個過程不需要安裝 Python 環境,也不需要搭建後端推理伺服器。用戶打開官方提供的 WebGPU 交互頁面(或本地構建後在地址後附加 ?api=web 參數)時,瀏覽器會在首次訪問時自動下載並快取分片權重,後續再次打開即可離線調用。
路徑二:Apple Silicon Mac 原生 MLX 服務(servers/mlx):針對搭載 M1、M2、M3 或更新晶片的 Mac 設備,倉庫提供了基於蘋果 MLX 框架的原生服務端。配置好 Python 3.12(透過 uv 管理依賴)與 Rust 編譯工具鏈(用於編譯文本正則化組件)後,只需從 Hugging Face 拉取 gguf 目錄下的量化權重檔案並執行啟動腳本,即可在本地 127.0.0.1:1919 連接埠啟動帶可視化介面的語音服務。Zyphra 在技術報告中披露,該模型在 M3 MacBook Air 上的首包音訊延遲(TTFA)低於 150 ms,在 Pixel 9 手機瀏覽器上的 WebGPU 首包延遲低於 570 ms。
路徑三:跨平台 C++ 與 ggml 獨立命令行/服務(servers/ggml):對於 Windows 筆記型電腦、無獨立顯示卡的 Linux 主機,或者不希望在生產環境中引入 Python 依賴的桌面軟體,可以直接編譯倉庫內置的 C++ / ggml 後端。它支援 CPU、CUDA、Metal 與 Vulkan 多種硬體加速,直接載入 GGUF 權重與內置的 27 種多語言預設音色檔案即可運行。
路徑四:NVIDIA 顯示卡高併發服務端與離線 Python 介面(servers/sgl):在配備 NVIDIA 顯示卡(如 A100 或 H100)及 CUDA 12.8 工具鏈的 Linux 伺服器上,可透過整合的 Mini-SGLang 後端(或直接安裝 SGLang-Omni)啟動高併發服務,首次運行會自動下載約 9 GB 的完整 PyTorch 權重。官方給出的測試數據顯示,在單張 H100 80GB 顯示卡、8 路併發請求下,其中位首包延遲為 80 ms,峰值吞吐達到即時播放速度的 457 倍。
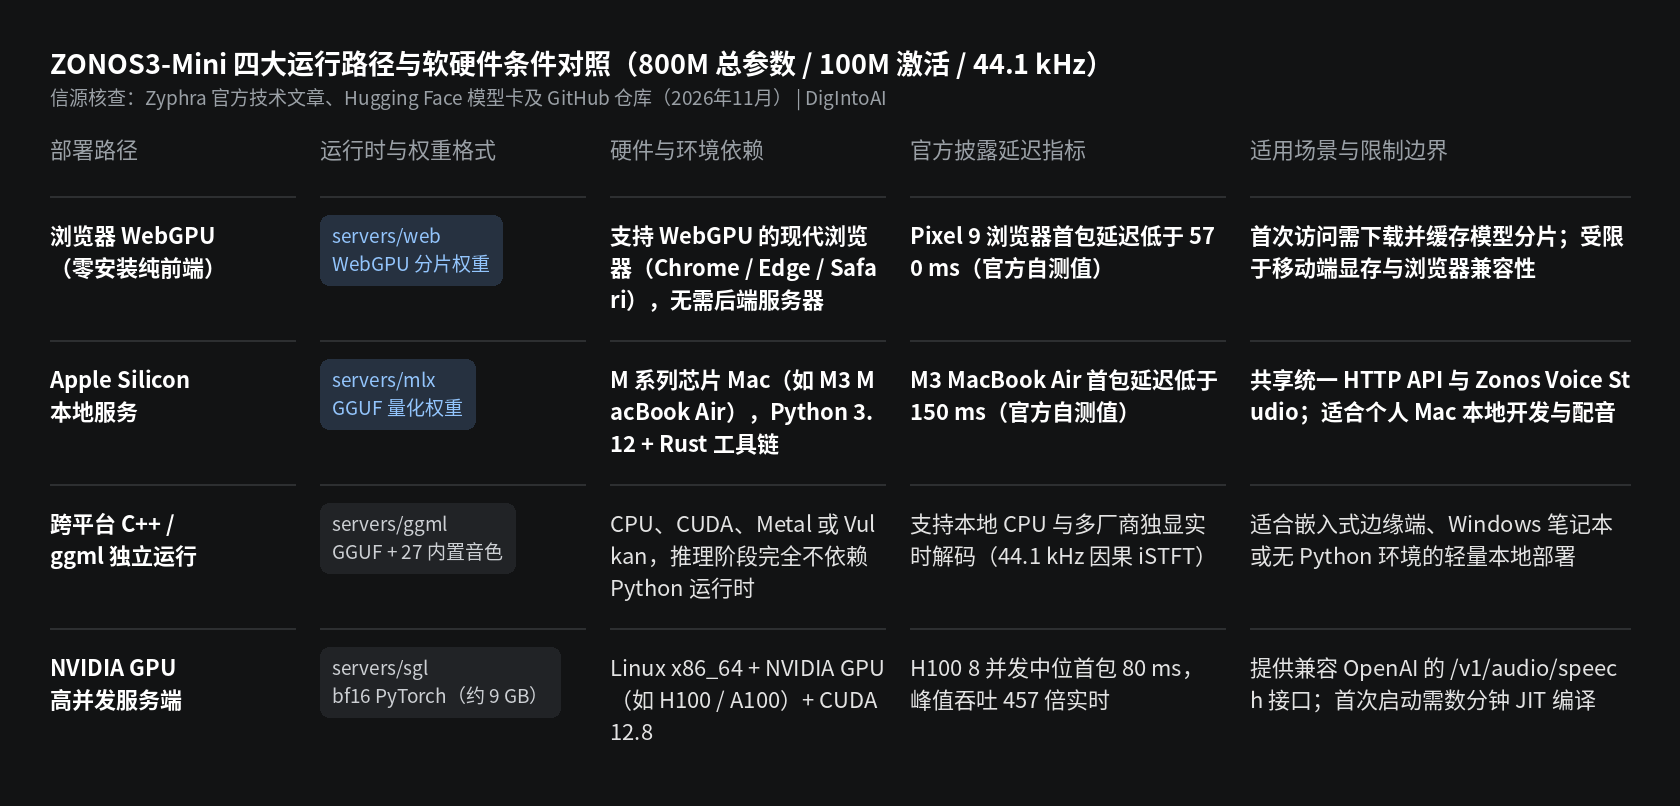
圖片來源:DigIntoAI 根據 Zyphra 技術文章、Hugging Face 模型卡及 GitHub 倉庫說明整理製作。
與雲端語音 API 的成本及工程邊界對比
在決定採用 ZONOS3-Mini 自建還是直接調用商業雲端語音介面時,中、英、日開發者可以從三筆賬來衡量差異:
邊際調用費用與基礎設施賬本:商業雲端服務通常按字符或生成時長計費。以 2026 年 11 月公開的 API 價格為例,OpenAI 的 tts-1 標價為每百萬字符 15 美元,高清版 tts-1-hd 為每百萬字符 30 美元,gpt-4o-mini-tts 折合每分鐘音訊約 0.015 美元;ElevenLabs 的 Flash v2.5 與 v4 Turbo 介面為每千字符 0.04 美元(即每百萬字符 40 美元),標準多語言模型 Eleven v4 為每千字符 0.08 美元(每百萬字符 80 美元)。相比之下,ZONOS3-Mini 的權重與代碼完全免費商用——如果採用瀏覽器 WebGPU 模式,推理算力全部由終端用戶的本地顯示卡承擔,開發者服務端幾乎只需要支付靜態模型分片的 CDN 分發流量費用;如果部署在自有 GPU 伺服器上,則轉化為固定的顯示卡折舊或雲主機租金,在有聲書批量製作、遊戲 NPC 即時對話或高頻語音助手場景下,一旦日均生成量跨越固定算力成本線,單分鐘邊際成本將顯著低於雲端按量計費。
數據隱私與離線可用性:調用雲端語音介面必須將合成文本與參考人聲樣本上傳至第三方伺服器;而透過 WebGPU 或本地 ggml / MLX 部署時,所有文本輸入與參考音訊均留在本地設備或企業內網中,不僅滿足金融、醫療等行業的敏感數據隔離要求,也能在斷網或弱網環境下穩定工作。
聲線克隆自由度與附加組件邊界:主流標準雲端介面(如 OpenAI TTS)通常僅提供 9 至 13 種固定預設音色,不支援透過常規介面傳入任意參考音訊做零樣本克隆;商業克隆介面則往往按訂閱套餐限制可保存的音色槽位數量。ZONOS3-Mini 在基礎模型中直接內置了參考音訊克隆與詞級韻律控制,但需要留意的是,其進階的「語音局部編輯(Speech Editing)」與「音素級發音指定」功能並非開箱即用,而是需要額外載入獨立的編輯 LoRA 權重、強制對齊模型 FuseAlign(檢查點約 1.34 GB)以及語音識別模型 Qwen3-ASR-1.7B。
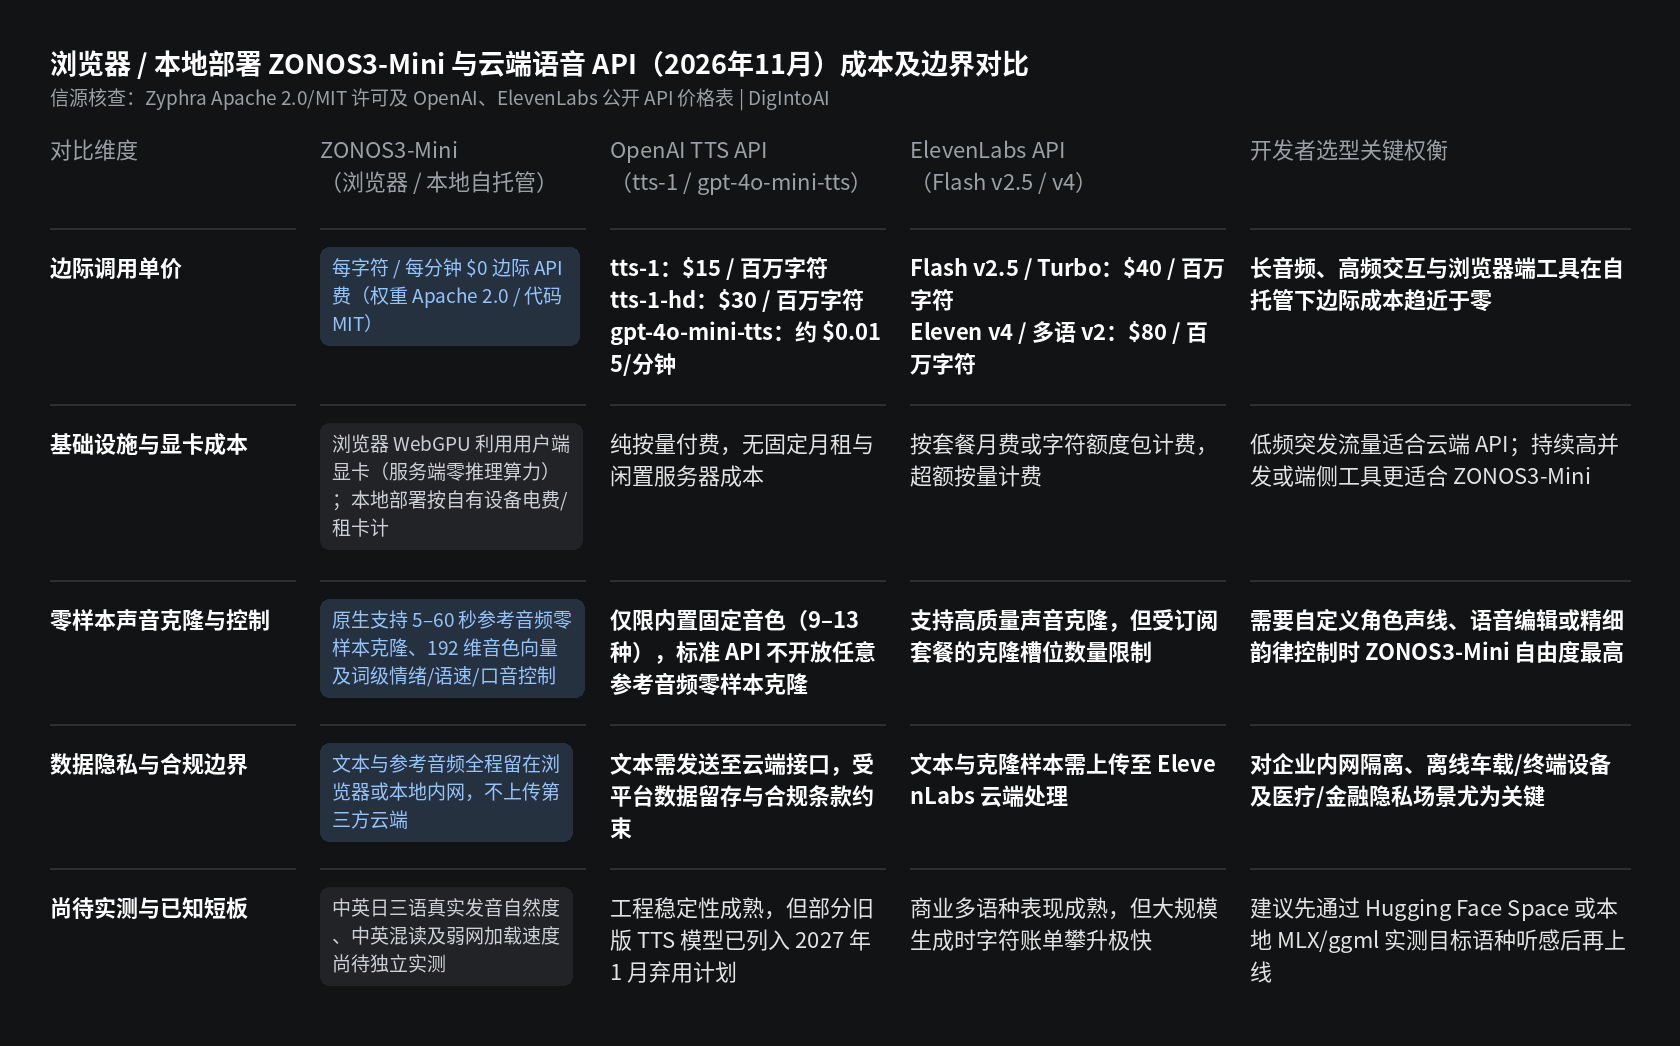
圖片來源:DigIntoAI 根據 Zyphra 開源許可條款及 OpenAI、ElevenLabs 公開 API 定價整理製作。
排除說明與待實測項
並非通用對話大模型:ZONOS3-Mini 是專注於文本轉語音與聲音克隆的專用音訊生成模型,雖然內部採用了混合專家語言模型骨幹來預測音訊離散碼本,但它不能作為通用聊天機器人回答開放式文本問題。
瀏覽器端存在首屏下載與顯存門檻:零安裝並不等於零資源消耗。瀏覽器 WebGPU 首次運行需要拉取數百兆級別的量化分片權重,在行動網絡或低配內顯設備上可能會遇到首屏載入耗時較長、顯存不足或部分瀏覽器預設未開啟 WebGPU 特性開關的情況。
多語言真實聽感與推理速度尚待獨立實測:前文提及的 80 ms、150 ms 與 570 ms 延遲數據以及開源排行榜第一的評測結果(ZTTS2-Eval)均引自 Zyphra 官方披露。至於 ZONOS3-Mini 在中文四聲調自然度、日語高低音重音(Pitch Accent)、中英日混讀斷句以及不同消費級顯示卡上的實際生成倍速,我們將在後續實機測試後單獨發布評測報告。