
本文目錄
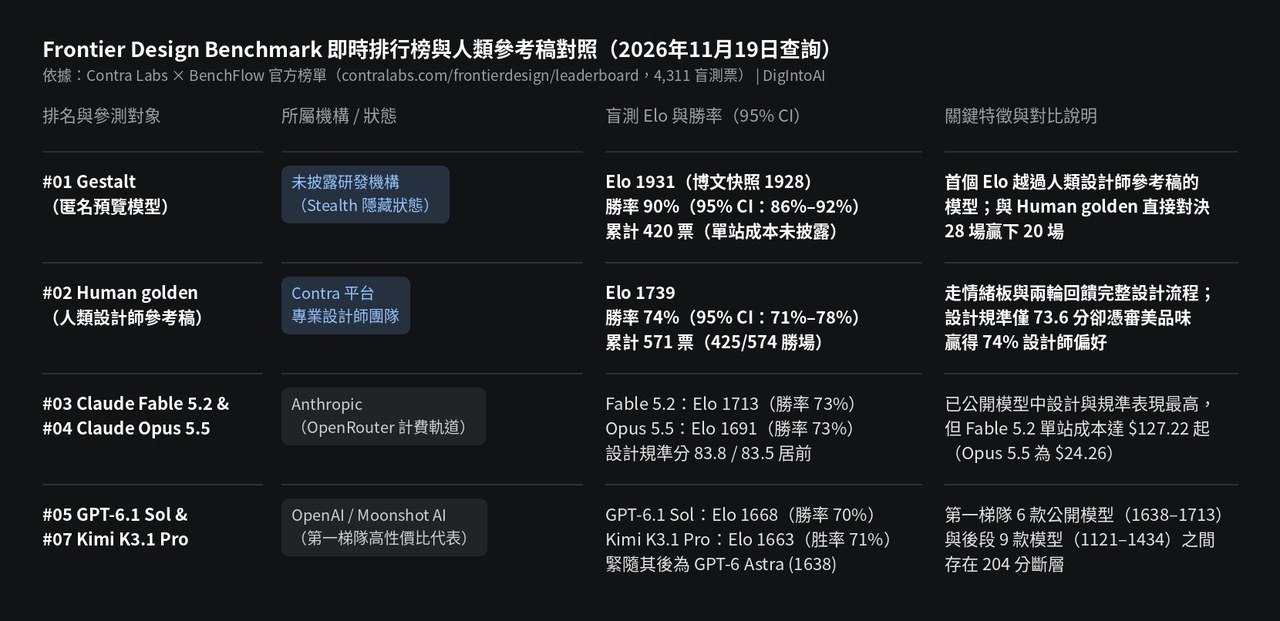
2026 年 11 月 18 日(台北時間 11 月 19 日凌晨),自由職業設計平台 Contra Labs 與評測基礎設施團隊 BenchFlow 聯合推出網頁與產品設計基準 Frontier Design Benchmark。在官方公布的 17 個參測對象(16 個 AI 模型與 1 組人類設計師參考稿)中,一個標註為隱藏身分(stealth)的未公開模型 Gestalt 引發業界高度關注——在 11 月 19 日查詢的官方即時排行榜上,Gestalt 以 1931 Elo 分、90% 盲測勝率登頂榜首,將人類專業設計師參考稿(1739 分)與已公開最強模型 Claude Fable 5.2(1713 分)甩在身後。
榜單數據全覽:Gestalt 越過人類基準,公開模型出現 204 分斷層
兩個官方時間快照的精確對齊:引用該榜單時需注意官方文章與即時看板的數據快照差異:在 11 月 18 日刊出博文正文的統計快照中,Gestalt 記錄為 1,928 Elo 分(89% 勝率,423 場贏下 378 場),Claude Fable 5.2 為 1,714 分;而在 11 月 19 日查詢的即時排行榜頁面上,隨著票數累計至 4,311 票,Gestalt 更新為 1931 Elo 分(90% 勝率,95% 信賴區間 86%–92%,420 票),人類設計師參考稿(Human golden)位列第二,為 1739 分(74% 勝率,95% 信賴區間 71%–78%,571 票)——Gestalt 的 95% 信賴區間下限完全高於人類參考稿上限,且在 28 場與人類參考稿的直接盲測對決中被設計師選中 20 次。
第一梯隊 6 款公開模型與後段 9 款模型的明顯斷層:在已公開身分的 16 款商用與開源模型中,排名前六的型號緊密聚集在 1638 至 1713 Elo 之間,包括 Anthropic 的 Claude Fable 5.2(1713 分,單站生成成本 $127.22 起)、Claude Opus 5.5(1691 分,單站 $24.26)、OpenAI 的 GPT-6.1 Sol(1668 分,單站 $1.31)、Anthropic 的 Claude Sonnet 5.5(1667 分,單站 $20.49)、月之暗面的 Kimi K3.1 Pro(1663 分,單站 $1.91)以及 OpenAI 的 GPT-6 Astra(1638 分,單站 $7.33)。自第九名阿里 Qwen3.8 Max(1434 分)起,後續 9 款模型(含 Kimi K3、GLM-5.3 Prime、Gemini 4 Carbon、Meta Muse Spark 1.3 與 Muse Wonder、Grok 4.7、Gemini 4 Argon 及墊底的 DeepSeek V4 Pro 1121 分)均落在 1434 分以下,與第一梯隊拉開 204 分的明顯差距。
圖片來源:DigIntoAI 根據 Contra Labs × BenchFlow 官方排行榜數據整理製作。
不只是「咖啡館落地頁」:真實客戶需求與三維制衡評測
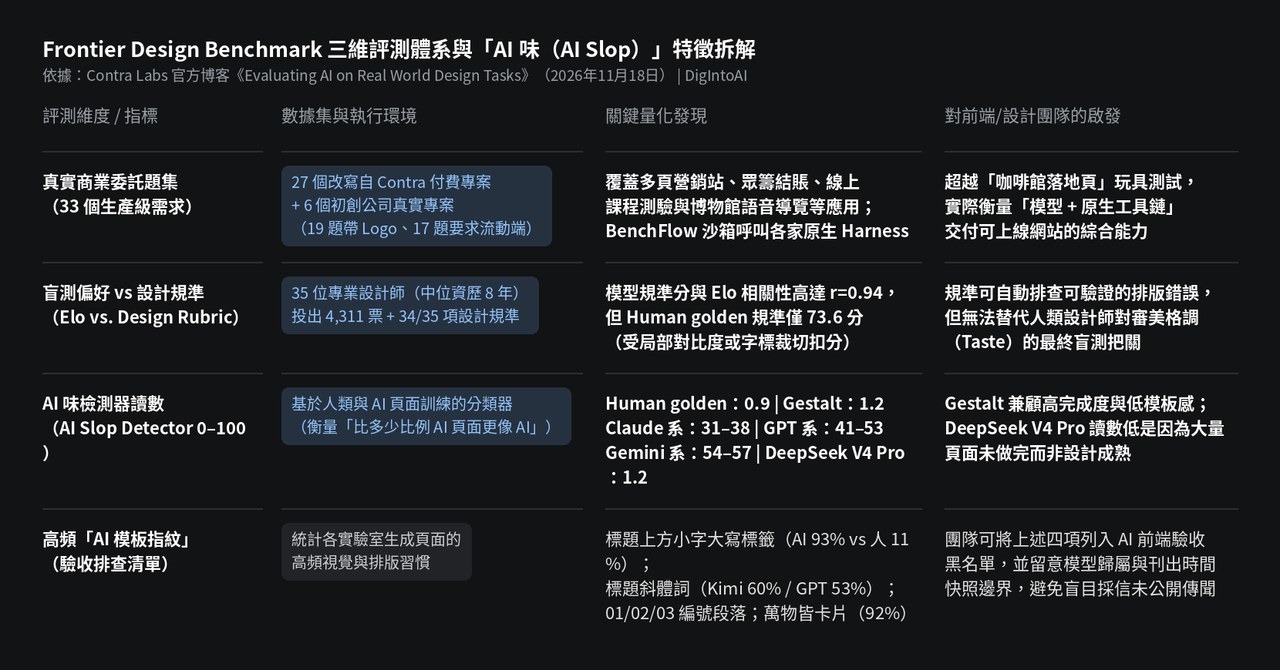
33 個真實商業委託題與原廠 Harness 執行:Contra Labs 分析了平台過去一年 4,600 個網站訂單後發現,真實客戶需求書中位數達 138 個英文詞、預算中位數 $1,050,且 75% 疊加了品牌資產、目標客群或互動流程約束。因此,Frontier Design Benchmark 選取了 27 個改寫自 Contra 付費專案的需求書與 6 個初創公司真實專案(其中 19 題提供客戶原始 Logo,17 題要求流動端適配,涵蓋票務營銷站、眾籌結賬、線上課程測驗與博物館語音導覽等完整可運行應用)。評測時,BenchFlow 在沙箱中透過 OpenRouter 呼叫模型,並盡可能讓每個模型運行在各自實驗室的原生 Agent Harness 中,因此榜單反映的是「基座模型 + 原生工具鏈」的綜合交付水準。
設計規準與人類審美投票的分歧點:除 35 位專業設計師(中位從業年資 8 年,首頁宣傳橫幅提及 68 位網絡設計師)的盲測投票外,團隊還引入了 34/35 項設計維度規準(Design Rubric)與 0–100 分的「AI 味檢測器(AI Slop Detector)」。有趣的是,設計規準雖然與模型 Elo 排名高度正相關(r = 0.94),卻把人類參考稿排在第六名(73.6 分,低於 Claude 與 GPT 五款模型),原因是人類參考稿存在按鈕文字對比度偏低或局部字標裁切等可指出的執行瑕疵;但盲測投票中設計師仍把 74% 的選票(425/574)投給了人類參考稿,印證了自動化規準只能排查規則錯誤,無法替代人類的整體審美格調(Taste)。而在 AI 味檢測器中,人類參考稿讀數為 0.9,Gestalt 僅為 1.2(兼具高完成度與極低的「標題上方小字大寫標籤、標題斜體詞、01/02/03 編號段落、萬物皆卡片」等典型 AI 模板痕跡)。
圖片來源:DigIntoAI 根據 Contra Labs 官方博客方法學與評測結果整理製作。
Gestalt 身分與適用範圍的三條事實邊界
官方嚴格保留匿名狀態,切勿採信無實證的廠商猜測:Contra Labs 與 BenchFlow 在官方博客與排行榜中僅將 Gestalt 定位為「目前處於隱藏階段的高品質設計模型」(currently in stealth),既未披露其背後的研發機構或模型參數,也未公布生成成本與公開上線時間表(其餘 16 款模型均走 OpenRouter 計費軌道,唯獨 Gestalt 成本欄留空)。報導與引用時需明確三條邊界:第一,該榜單衡量的是商業網頁與前端應用設計能力,而非通用推理或後端演算法全能榜;第二,成績包含模型所屬實驗室原生工具鏈的加成效果;第三,在官方或模型研發方正式認領前,不應將任何未公開的傳聞型號直接等同於 Gestalt,亦不應將其與 2026 年 9 月學術界發表的同名視覺理解模型論文混淆。