
本文目錄
2026 年 11 月 13 日,由 Georgi Gerganov 領銜的 ggml-org 團隊正式發布了 llama.cpp v1.0.0 與底層張量庫 ggml v1.0.0。在過去三年半裡,這個從單文件 CPU 推理原型成長起來的項目已經支援超過 150 種模型架構變體,成為 Ollama、LM Studio、Jan、LocalAI 以及無數移動端與桌面端應用的核心推理底座,但在此之前它一直採用按提交遞增的構建編號(直至 b12374),沒有引入正式的語義化版本號。
邁入 v1.0.0 的真正意義,不在於單次功能列表的堆砌,而在於項目治理契約的轉變:ggml-org 正式將 llama.cpp/include/ 與 ggml/include/ 下的公共頭文件確立為受語義化版本保護的穩定契約,明確承諾今後只有主版本號遞增(MAJOR)才會引入公共 C API 與二進制介面(ABI)的破壞性變更。
為什麼本地 AI 生態急需 C API 與 ABI 穩定性契約?
在本地推理早期階段,新模型架構幾乎每週都在湧現,快速迭代的代價是下游整合方承受著極高的適配摩擦成本。在無大版本號的 bXXXX 時代,上游一次常規重構就可能刪除某個舊初始化函數、修改上下文參數結構體的記憶體布局,或者調整後端回調簽名。對於直接調用動態連結庫(libllama 與 libggml)的下游軟件而言,這帶來了兩類痛點:
第一,語言綁定與桌面應用的「鎖哈希困境」:諸如 llama-cpp-python、Rust 綁定、Go 綁定以及各類跨平台 GUI 啟動器,過去往往不敢直接追蹤上游主幹分支,只能把依賴鎖死在某個特定的 commit 哈希上,每隔幾週再集中做一次痛苦的適配移植。一旦需要緊急接入某個剛發布的新模型架構,下游團隊往往被迫在「手動向後移植模型代碼」與「全量重寫膠水層介面」之間二選一。
第二,動態硬體後端插件的二進制兼容性需求:隨著 ggml 將計算後端拆分為可在運行時按需載入的動態庫(覆蓋 NVIDIA CUDA、AMD ROCm、Apple Metal、Vulkan、OpenVINO、SYCL 以及高通 Hexagon NPU),如果底層張量庫的 ABI 頻繁變動,不同硬體廠商維護的動態後端插件就無法在不重新編譯主程序的情況下獨立升級。
v1.0.0 確立語義化版本後,下游工程團隊終於可以把依賴策略從「按特定構建哈希鎖死」切換為標準的「主版本鎖定(如 ^1.0.0)」:在所有 1.x.y 生命週期內,次版本升級(MINOR)只會以向後兼容的方式增加新模型支援、新硬體後端或擴展介面,修訂版本(PATCH)則僅包含零介面變動的缺陷與安全修復。
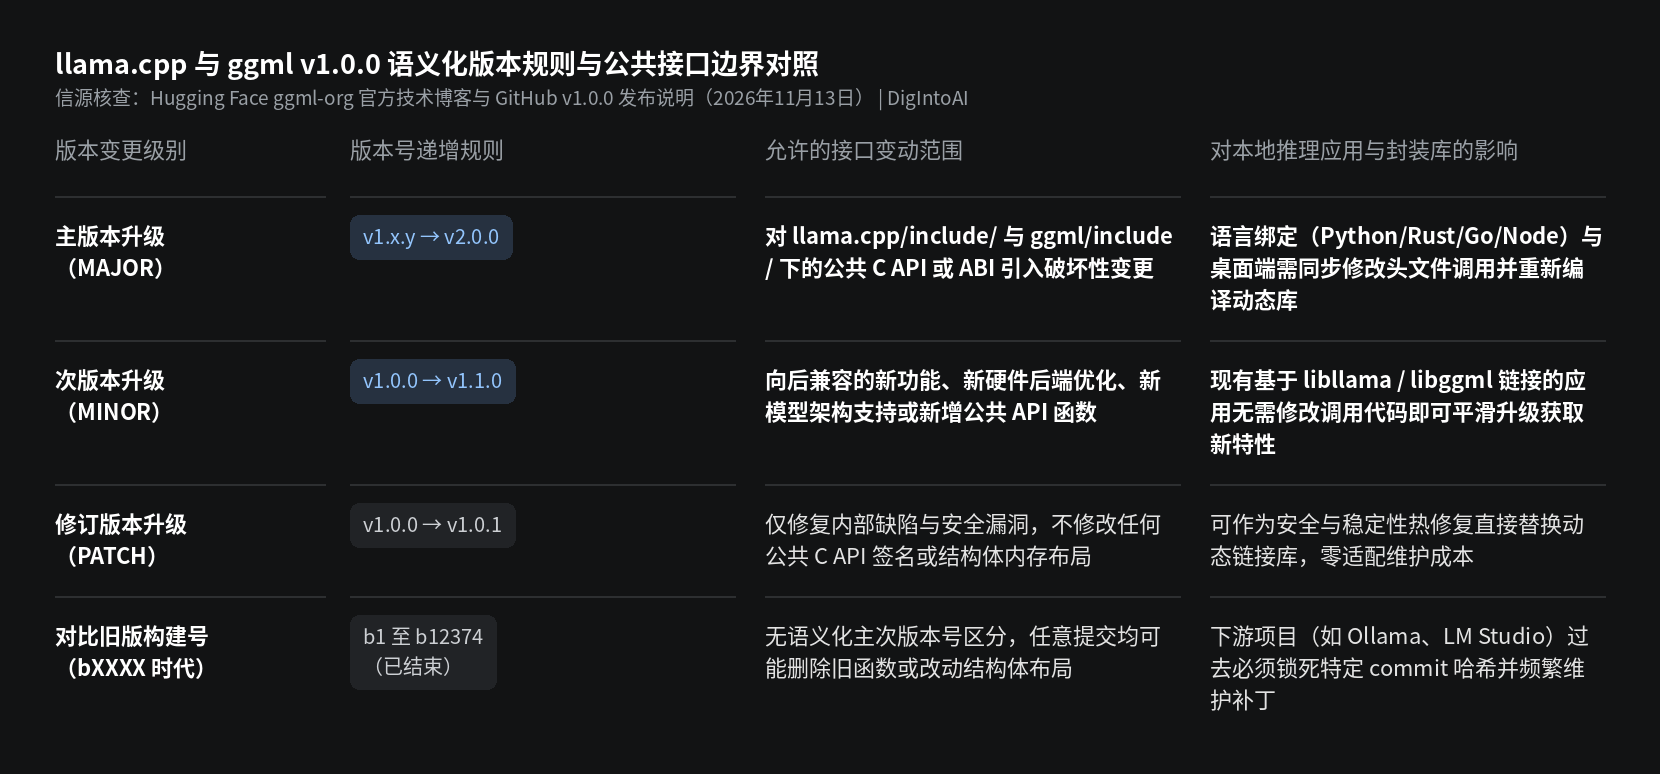
圖片來源:DigIntoAI 根據 ggml-org 官方發布博客及 GitHub 版本說明整理製作。
v1.0.0 升級實操:哪些破壞性變更必須先清理?
在享受 1.x 系列向後兼容承諾之前,v1.0.0 本身是一次集中清理歷史技術債的「斷代升級」。開發者在將現有項目從 b12374 或更早版本遷入 v1.0.0 時,重點需要核查四類變化:
清理 35 個已棄用公共符號與結構體調整:v1.0.0 在 llama.h 中正式移除了 llama_set_warmup 等 35 個長期標記為棄用的公共函數,同時刪除了 defrag_thold 欄位及對應的命令行參數。原本位於實驗頭文件 llama-ext.h 中的 NextN 投機解碼介面被正式晉升進公共頭文件 llama.h,狀態設置函數則統一重命名為 llama_set_ctx_state_src。多模態側也移除了舊的 clip.h,將視覺與音訊子上下文基礎設施全部收攏進統一的 mtmd 模組。
利用官方多渠道發行包簡化分發管線:伴隨 v1.0.0 發布,ggml-org 同步規範了跨平台官方分發矩陣,覆蓋 Linux/macOS/Windows/Android/iOS 預編譯包、Docker 鏡像、Debian 軟件源、Homebrew、conda-forge、MacPorts、Windows Winget 以及面向蘋果生態的 XCFramework。對於桌面端或移動端 App 開發者,不再需要自行從源碼交叉編譯全套工具鏈,可直接對接標準包管理器或預編譯動態庫。
排查 llama-server 預設安全策略收緊帶來的連接攔截:v1.0.0 對內置 HTTP 服務端做了大幅安全加固,預設修復了 CORS 代理 SSRF、DNS 重綁定以及子實例越權訪問隱患,並將環境變數中的 HF_TOKEN 嚴格限定僅向 huggingface.co 域名發送。如果你的本地工作流依賴未經認證的本地工具調用,升級後需要顯式傳入 --allow-unauthenticated-tools 參數,否則服務端會預設拒絕執行。
把新特性納入 1.x 漸進式升級路徑:完成 1.0.0 基線對齊後,開發者可以直接在現有調用代碼上漸進啟用本次同步落地的新特性——例如透過參數開啟 OCP FP8 KV 緩存壓縮長上下文顯存占用,或為大尺寸稀疏 MoE 模型配置主機記憶體專家緩存比例(moe_cache_cpu_share),而無需擔心下個月升級 v1.1.0 時再次推翻介面封裝。
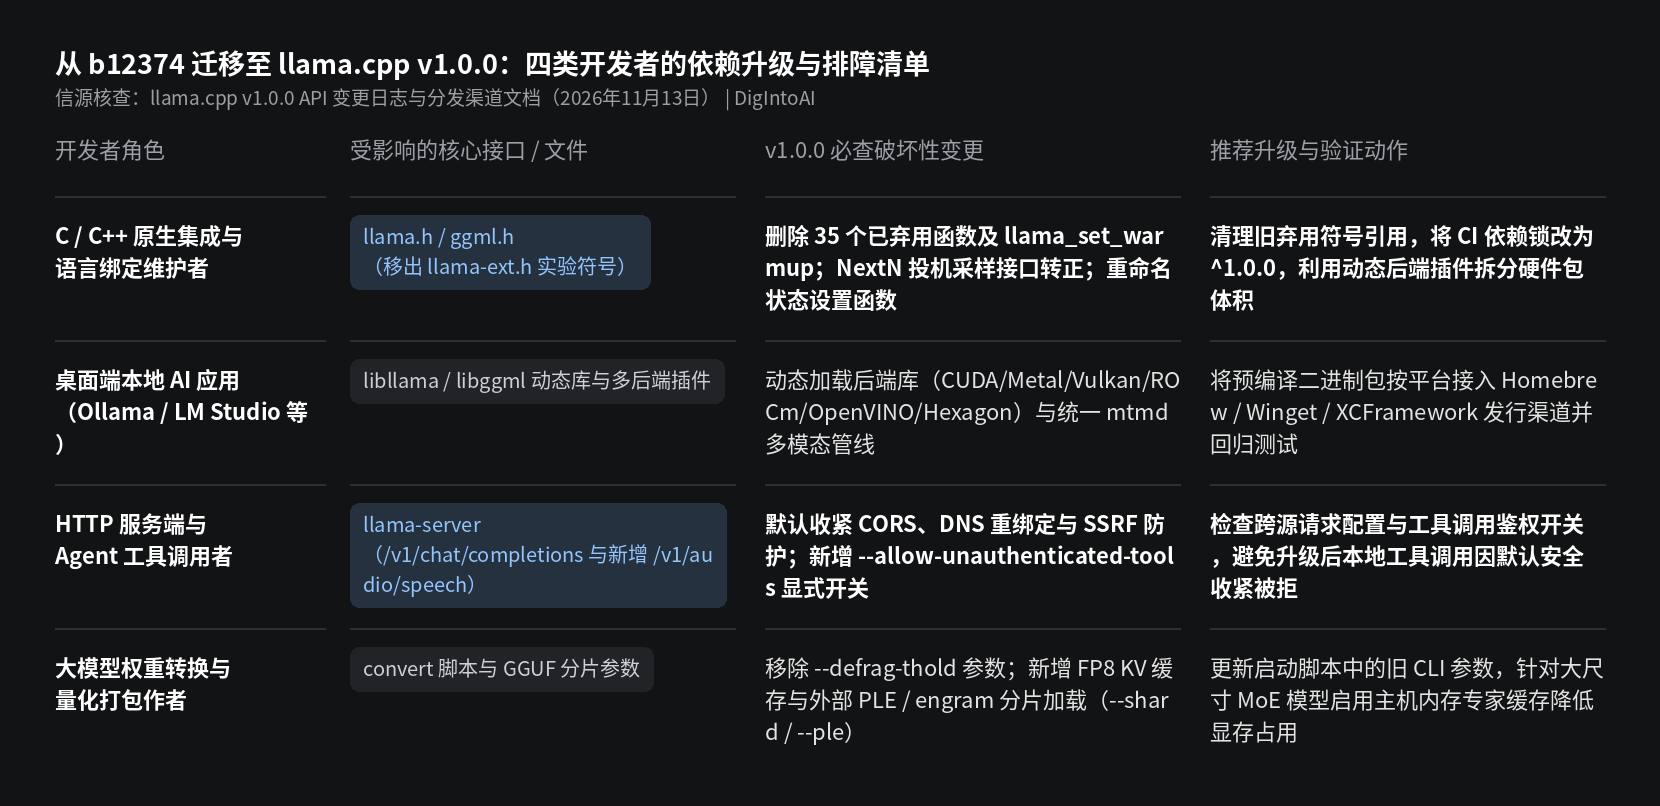
圖片來源:DigIntoAI 根據 llama.cpp v1.0.0 公共頭文件變更日誌整理製作。
邊界說明與工程建議
在評估 llama.cpp v1.0.0 的穩定性承諾時,仍有兩項工程邊界需要保持清醒:
穩定的是公共 C API 與 ABI,而非內部實驗實現與 CLI 交互細節:語義化版本契約嚴格覆蓋公共頭文件(llama.h 與 ggml.h)中聲明的 C 介面與二進制布局;如果項目直接引用了內部未導出頭文件、底層算子私有結構,或者依賴終端 CLI 輸出文本的正則解析,仍可能在次版本更新中遇到變動。因此,生產級封裝應嚴格收斂在官方公共 C API 或兼容 OpenAI 的 HTTP 端點(/v1/chat/completions 與新增的 /v1/audio/speech)之上。
未獨立實測項:本文中關於語義化版本維護規則與發行渠道的梳理均基於 ggml-org 官方發布文檔與 GitHub v1.0.0 變更記錄,我們尚未在多硬體平台上對跨次版本的動態後端二進制替換做獨立壓測。