
本文目錄
2026 年 11 月 12 日,OpenAI 同步發布了 Python SDK v3.50.0(提交哈希 f44c1ec,對應 PR 4268)與 Node SDK v7.56.0(對應 PR 3145),在 Responses API 的返回對象(包含正式版 Response 與測試版 BetaResponse)中正式暴露了 input_transformations 可選欄位。在此之前,開發者在無狀態模式(store 設為 False)或手動管理多輪對話歷史時,如果因為改寫上下文導致歷史加密推理記錄(Reasoning items)被服務端悄悄丟棄,幾乎只能透過異常飆升的推理 Token 賬單和響應延遲間接猜測;現在,藉助這一新欄位可以直接定位具體哪一條推理記錄被移除以及背後的觸發原因。
input_transformations 欄位結構與五類移除原因
需要注意的是,input_transformations 屬於服務端返回的可讀診斷欄位,而不是請求側傳入的參數。當請求傳入的 input 數組中包含從前序輪次保留下來的加密推理條目,且部分條目在進入模型推理前被服務端過濾攔截時,response.input_transformations 會按照輸入順序返回被移除條目的清單,每個對象固定包含四個屬性:type(恆為 reasoning)、id(被移除的原始推理條目 ID)、action(恆為 removed)以及 reason(五選一枚舉值):
第一,prefix_mismatch(前綴歷史不匹配,日常開發最高頻):對於新一代前沿推理模型(如 GPT-6 系列),Responses API 會校驗回傳的每一個推理條目之前的所有前置對話歷史(即該推理條目的 Prefix)。只要你在該推理條目之前編輯了歷史訊息、截短了工具返回結果、重排了條目順序,或者在中間插入了新的指令訊息,該推理條目就會被判定為前綴失效並被移除。
第二,turn_boundary(跨輪次策略邊界):所選模型或請求參數中的 reasoning.context 設定(例如 auto 與 all_turns 的不同策略)不允許跨當前輪次邊界繼續沿用該推理條目。
第三,model_mismatch(模型切換不匹配):當前續接請求切換到了不同的模型 ID,或者切換到了無法解密、不兼容前序加密推理密文的模型架構。
第四,organization_mismatch(組織歸屬不匹配):當前 API 請求所使用的 OpenAI 組織 ID 與當初生成該加密推理條目時的組織 ID 不一致,常見於多租戶代理閘道動態切換組織憑證的場景。
第五,end_user_mismatch(終端用戶標識變更):請求中傳入的 user 或 safety_identifier 欄位值與生成該推理條目時所綁定的終端用戶標識不一致,觸發了安全與狀態隔離校驗。
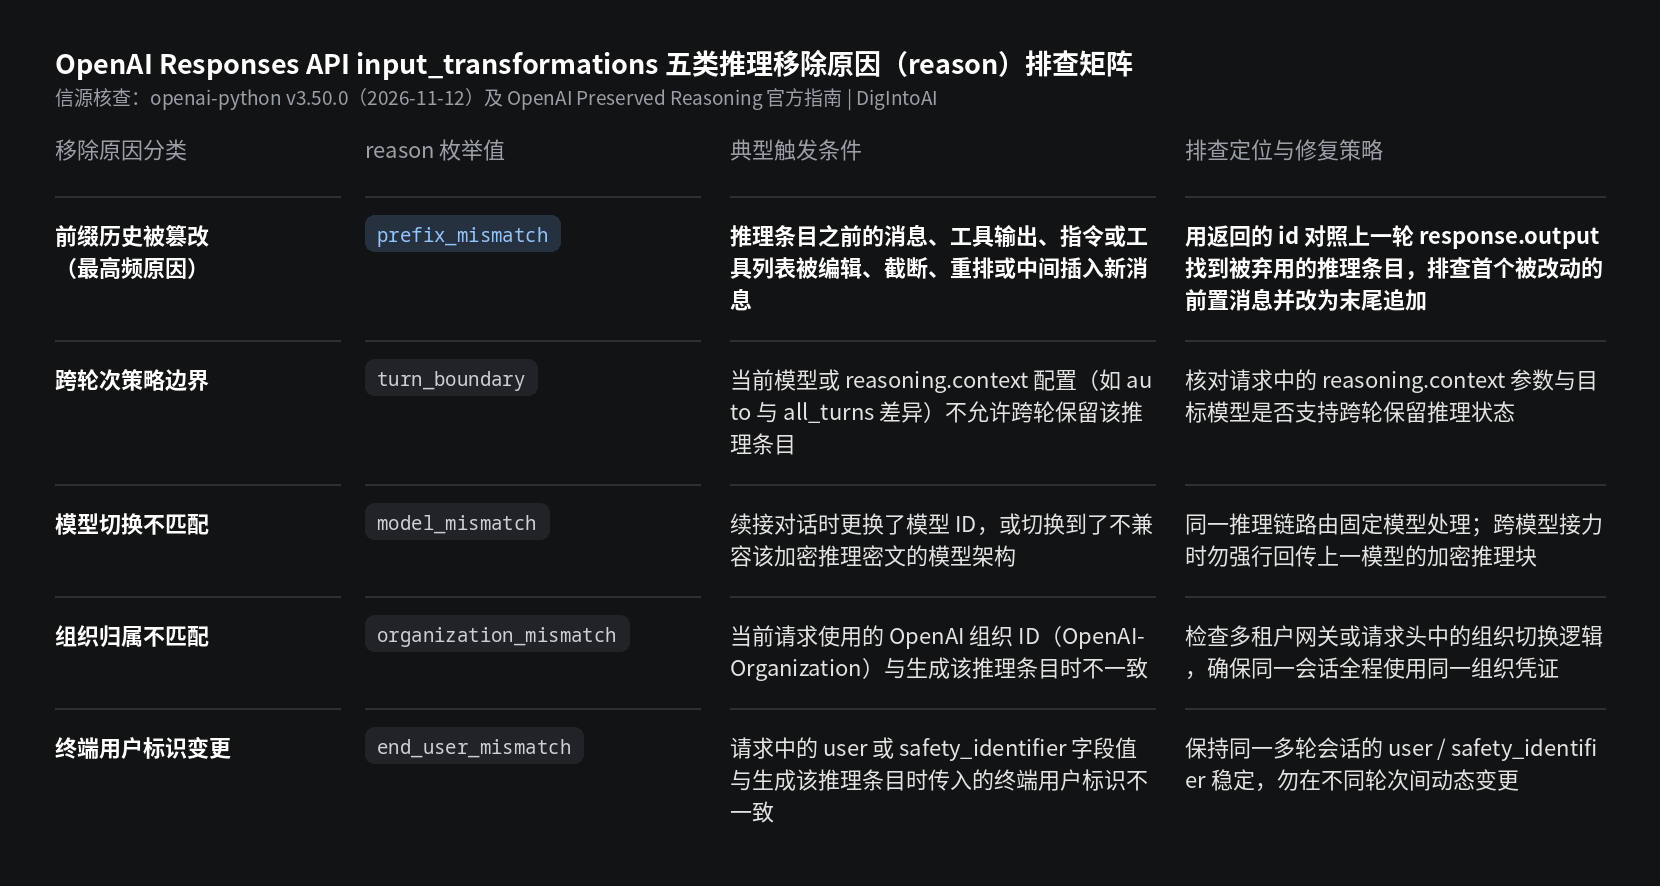
圖片來源:DigIntoAI 根據 openai-python v3.50.0 類型定義及 OpenAI API 官方文檔整理製作。
靜默移除機制與 prefix_mismatch 實戰排查四步法
在排查 Responses API 推理失效時,首先要認清一個關鍵行為邊界:當觸發 prefix_mismatch 時,OpenAI Responses API 並不會像部分第三方介面那樣直接拋出 HTTP 400 報錯中斷請求,而是靜默移除(action 為 removed)受影響的推理條目,繼續執行剩餘對話,並讓模型在後台重新從零生成新的推理過程。這正是許多 Agent 應用在多輪運行後突然出現響應變慢、推理 Token 消耗翻倍卻沒有任何報錯日誌的根源。
官方技術文檔用賬本查詢場景演示了「部分保留」規則:假設首輪對話依次包含用戶提問、推理條目 A、調用查詢工具、工具返回多行原始明細、以及基於明細得出的推理條目 B;如果在下一輪中,你的應用為了省 Token 把歷史裡的多行明細替換成了一行匯總數字,那麼位於修改點之前的推理條目 A 因為前置歷史完全一致仍可繼續復用,但位於修改點之後的推理條目 B 即使原封不動回傳,也會因為前綴被改動而被列入 input_transformations 並遭到移除。
升級到 openai-python v3.50.0 及以上版本後,建議按以下四步建立排查流程:
第一步:記錄並檢查 response.input_transformations:在每次調用 client.responses.create 後檢查返回對象的 input_transformations 屬性。如果該列表非空,直接打印每個條目的 id 與 reason。
第二步:用條目 ID 精準回溯上一輪響應:拿到 reason 為 prefix_mismatch 的推理條目 id 後,去日誌中對照生成該條目的那一輪 response.output,定位它在原始序列中的準確位置。
第三步:逐項比對前置序列尋找首個改動點:將當前請求傳入的 input 列表與原始對話序列從頭開始逐條比對,找出該推理條目 ID 之前第一處發生增、刪、改、重排的條目(常見元兇包括截短舊的 function_call_output、修改頂層 instructions、或動態增減 tools 數組)。
第四步:改用「只追加、不改寫」的官方遷移模式:如果因為工具輸出過大需要精簡,應在首次發送 function_call_output 之前就完成欄位過濾,而不是等模型看過了再回頭改寫歷史;如果後續數據發生變化,應在對話末尾追加一條新的更正訊息或發起新的工具調用。如果需要在切換 Agent 模式時調整工具權限,應保持已知 tools 定義穩定,改用 tool_choice 中的 allowed_tools 限制調用範圍,或在末尾追加 additional_tools 開發者條目。如果需要進行長上下文壓縮,應調用 OpenAI 原生壓縮端點並基於其返回的新上下文續寫,而不要在自行生成文本摘要後繼續回傳摘要之前的舊推理塊。
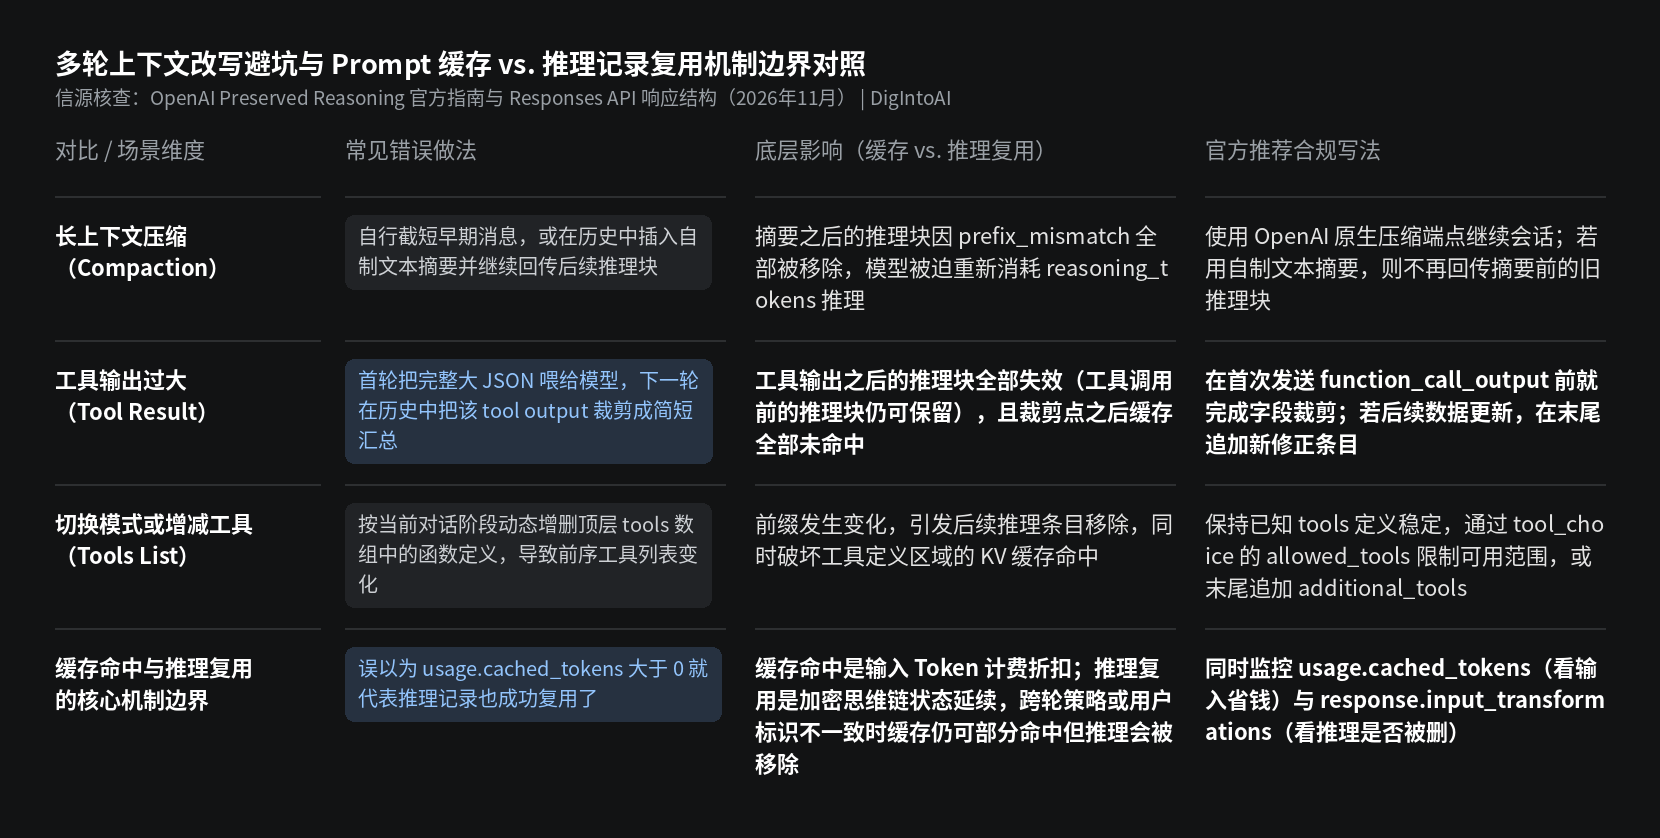
圖片來源:DigIntoAI 根據 OpenAI Preserved reasoning 官方指南及 Responses API 響應規範整理製作。
為什麼 Prompt 快取命中不能與推理復用畫等號?
不少開發者在優化成本時容易把兩套機制混為一談,誤以為只要賬單裡的 usage.input_tokens_details.cached_tokens 大於 0,就說明歷史推理記錄也成功復用了。實際上,二者在底層分屬完全不同的兩道管線:
Prompt 快取(Prompt Caching)作用於輸入 Token 的鍵值(KV)快取與計費折扣層,只要請求開頭的系統提示詞和前幾輪對話文本沒有變化,服務端就能對重複輸入的 Token 給予快取命中折扣(開發者也可透過響應中的 prompt_cache_diagnostics 欄位查看未命中原因)。而保留推理(Preserved Reasoning)作用於加密思維鏈狀態的連續性恢復層,受限於嚴格的端到端前綴完整性、模型譜系、組織歸屬、終端用戶標識以及 reasoning.context 輪次策略。
這意味著在真實生產環境中完全可能出現「快取部分命中、但推理全部被移除」的交叉現象:例如,當你在多輪對話中跨過了 turn_boundary 策略限制,或者多租戶閘道在請求頭裡意外變更了 end_user_mismatch 對應的用戶標識時,前序系統提示詞與早期對話文本依然可以命中 Prompt 快取並享受輸入折扣,但 input_transformations 仍會將加密推理條目移除,迫使模型重新耗費大量輸出 reasoning_tokens 進行二次推導。因此,上線多輪推理 Agent 時,必須同時監控 usage.cached_tokens(衡量輸入計費折扣)與 response.input_transformations(衡量推理狀態是否真正存活)。