
2026 年 11 月 20 日,Thinking Machines Lab 正式推出並開源新一代端側多模態模型 Inkling 2 Mini(Apache 2.0 協議,同步登陸 Hugging Face 與自家微調推理平台 Tinker)。區別於常規單向堆疊層數的開源小模型,Inkling 2 Mini 引入了循環 Transformer(Looped Transformer)與原生混合低位元訓練路線,以約 20 GB 的單檔案體積支援 1M(1,024K)上下文與文本、圖像雙模態輸入,讓開發者能夠在斷網的消費級筆電或單台桌面 AI 主機上運行長程編程與多智能體任務。
24 層權重跑出 48 層深度:循環 MoE 與原生 NVFP4 零損部署
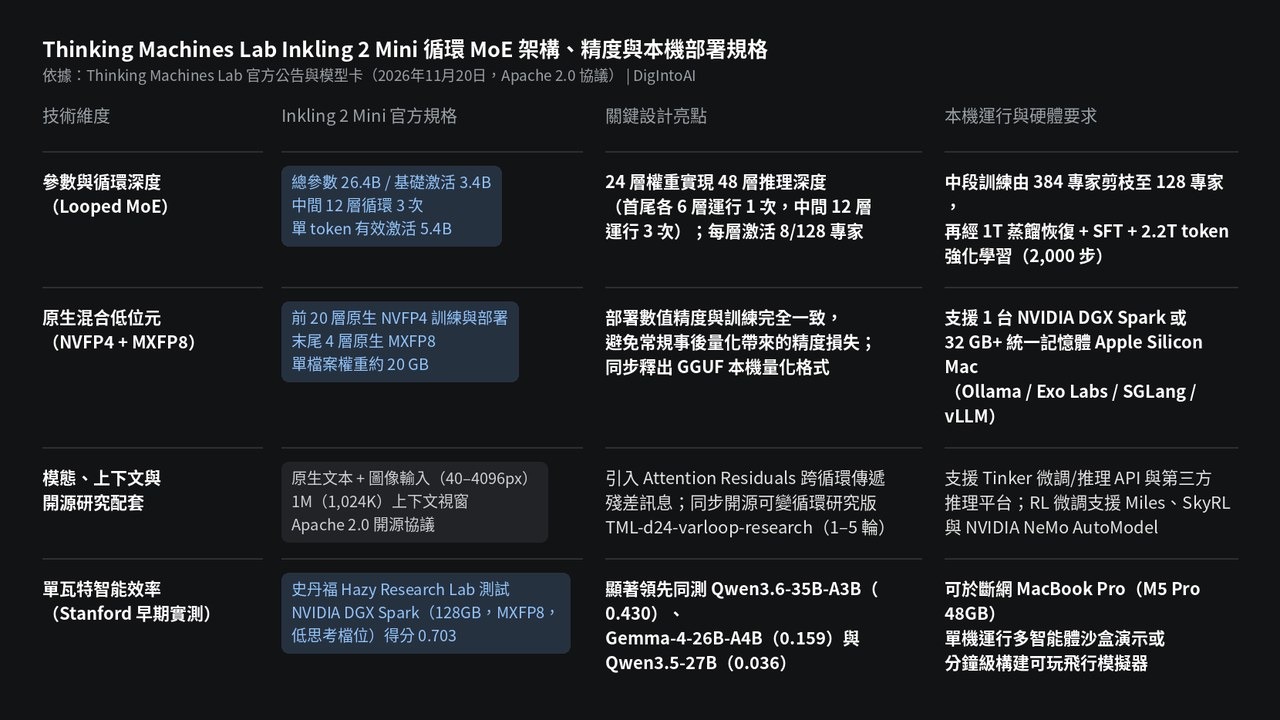
中段 12 層共享權重循環三次,配合專家剪枝與注意力殘差:根據官方模型卡,Inkling 2 Mini 採用 24 層解碼器稀疏 MoE 架構,劃分為四個 6 層區塊:首尾兩個區塊各運行一次,中間 12 層(第 7 至 18 層)共享權重連續運行三次,使每個 token 在不增加磁碟權重的前提下獲得 48 層計算深度。模型總參數量為 26.4B,單次前向基礎激活 3.4B,每增加一輪循環額外帶來約 1.0B 有效計算激活,因此三輪循環下的單 token 有效激活參數為 5.4B(每層從 128 個專家中路由激活 8 個)。訓練配方上,團隊先在 384 個專家稀疏度下啟動訓練,中段一次性剪枝掉三分之二專家保留最高頻的 128 個,再透過 1T tokens 內部大模型蒸餾恢復效能,並疊加 SFT 與總計 2.2T tokens(2,000 步)的強化學習;同時借鑑 Attention Residuals 機制並引入可學習門控,穩定地將上一輪循環輸出傳遞至下一輪。
原生 NVFP4 + MXFP8 零轉換損失,32 GB 記憶體 Mac 離線可跑:數值精度方面,Inkling 2 Mini 在從預訓練到強化學習的全流程前向計算中,前 20 層專家層原生採用 4-bit NVFP4(依託 NVIDIA GB300 硬體加速),末尾 4 層採用 8-bit MXFP8,最終以完全相同的混合精度釋出約 20 GB 的單個檢查點檔案,消除了傳統事後量化帶來的精度跌落。官方支援在單台 NVIDIA DGX Spark、配備 32 GB 及以上統一記憶體的 Apple Silicon Mac(可透過 Ollama 與 Exo Labs 運行)或 32 GB+ 顯存顯示卡(支援 SGLang、vLLM、Unsloth 及 llama.cpp GGUF)上本機推理。在史丹福 Hazy Research Lab 與 Scaling Intelligence Lab 的早期能效測試中,Inkling 2 Mini 在 128 GB DGX Spark(MXFP8、低思考檔位)上取得 0.703 的單瓦特智能分(Intelligence per Watt),大幅高於同測的 Qwen3.6-35B-A3B(0.430)、Gemma-4-26B-A4B(0.159)與 Qwen3.5-27B(0.036)。
圖片來源:DigIntoAI 根據 Thinking Machines Lab 官方公告與模型卡整理製作。
百億級以下編碼領跑、循環可監控性實驗與坦承短板
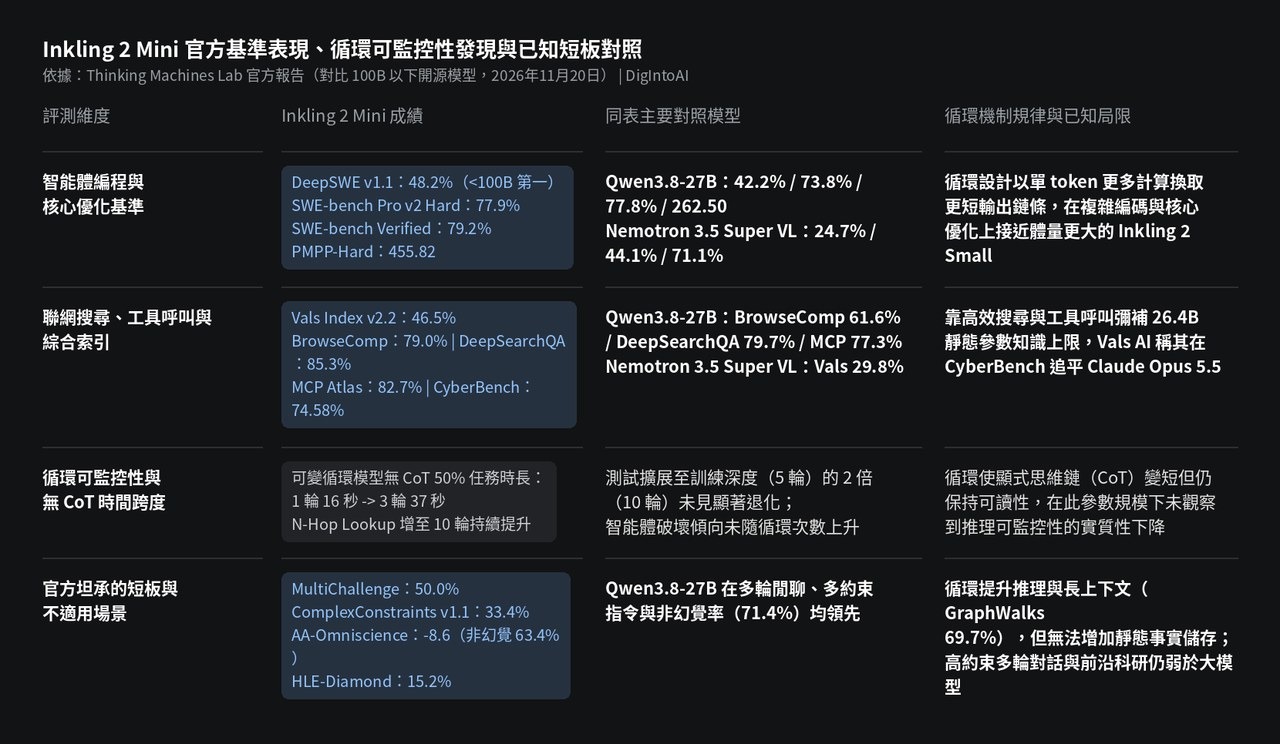
編程與工具檢索領跑同尺寸開源,彌補靜態知識上限:在官方披露的 100B 以下開源模型橫向對比中,Inkling 2 Mini 在 DeepSWE v1.1(48.2%)、Vals Index v2.2(46.5%)、SWE-bench Pro v2 Hard(77.9%)、SWE-bench Verified(79.2%)以及 GPU 核心優化基準 PMPP-Hard(455.82)上均居前列;在依賴聯網搜尋與工具呼叫的 BrowseComp(79.0%)、DeepSearchQA(85.3%)與 MCP Atlas(82.7%)上同樣領先同體量模型(第三方評測平台 Vals AI 亦指出其在 CyberBench 取得 74.58%)。官方在文中明確解釋了循環的邊界:增加循環次數能顯著提升複雜推理與長上下文定位(GraphWalks BFS 256K 達 69.7%、MRCR v2 達 46.4%),但無法突破 26.4B 總參數量的靜態事實記憶上限,因此需結合搜尋與工具呼叫發揮實戰優勢。
同步開源可變循環研究模型與明確的能力短板:針對學界擔憂「循環層在不寫明思維鏈(CoT)的情況下完成內部推理會降低安全可監控性」,Thinking Machines Lab 同步在 Hugging Face 開源了支援 1 至 5 輪可變循環的研究權重 TML-d24-varloop-research。實驗顯示,該研究模型的無 CoT 50% 任務時長跨度從 1 輪循環的 16 秒提升至 3 輪的 37 秒,在串行推理任務 N-Hop Lookup 中擴展至 10 輪循環(訓練最大深度的兩倍)仍持續提升;隨著循環增加,模型顯式寫出的 CoT 變短但仍保持可讀,且內部智能體破壞測試未呈上升趨勢。與此同時,官方也坦承了 Inkling 2 Mini 的明顯短板:其在多輪對話(MultiChallenge 50.0%)、多約束複雜指令(ComplexConstraints v1.1 33.4%)以及非幻覺率(AA-Omniscience 63.4%)上均落後於 Qwen3.8-27B,在 HLE-Diamond(15.2%)與 CritPt v2 等重度前沿推理題上也仍與大參數旗艦存在差距。
圖片來源:DigIntoAI 根據 Thinking Machines Lab 報告及 Vals AI 公開資料整理製作。