
本文目录
2026 年 11 月 13 日晚间,DeepSeek 发布官方公告,宣布将此前仅存在于 DeepSeek App 与网页版中的全套应用层交互能力开放给第三方开发者。围绕主力模型 deepseek-flash(底层对应 DeepSeek-V4.1-Flash-1017,支持 1M 上下文与最高 384K 输出),开发者既可以直接在对话请求中打开参数开关由服务端自动完成搜索、读链接、文件解析与安全风控,也可以按需单独调用 Search、Fetch、OCR、语音识别(ASR)与语音合成(TTS)五个底层独立接口。
为演示这套接口的实际装配方式,DeepSeek 同步上线并开源了轻量级前端项目 chat-demo(在线体验位于 cdn.deepseek.com/chat-demo,源码托管于 github.com/deepseek-ai/chat-demo)。该项目采用纯浏览器本地存储保存 API Key 与图片,支持直接导入从 DeepSeek 网页端导出的历史对话继续上下文,完整覆盖了深度思考搜索、文件上传、Mermaid 图表渲染以及语音朗读与语音输入。
哪些功能由服务端自动处理?哪些需要组合独立接口?
在接入设计上,DeepSeek 把应用能力切分成了“对话内服务端托管”和“独立工具 API 自由组合”两层,目前已在 Anthropic 兼容的 Messages API(/anthropic/v1/messages)、OpenAI Responses API(/responses)以及 Chat Completions API(/chat/completions)三条协议上同步提供:
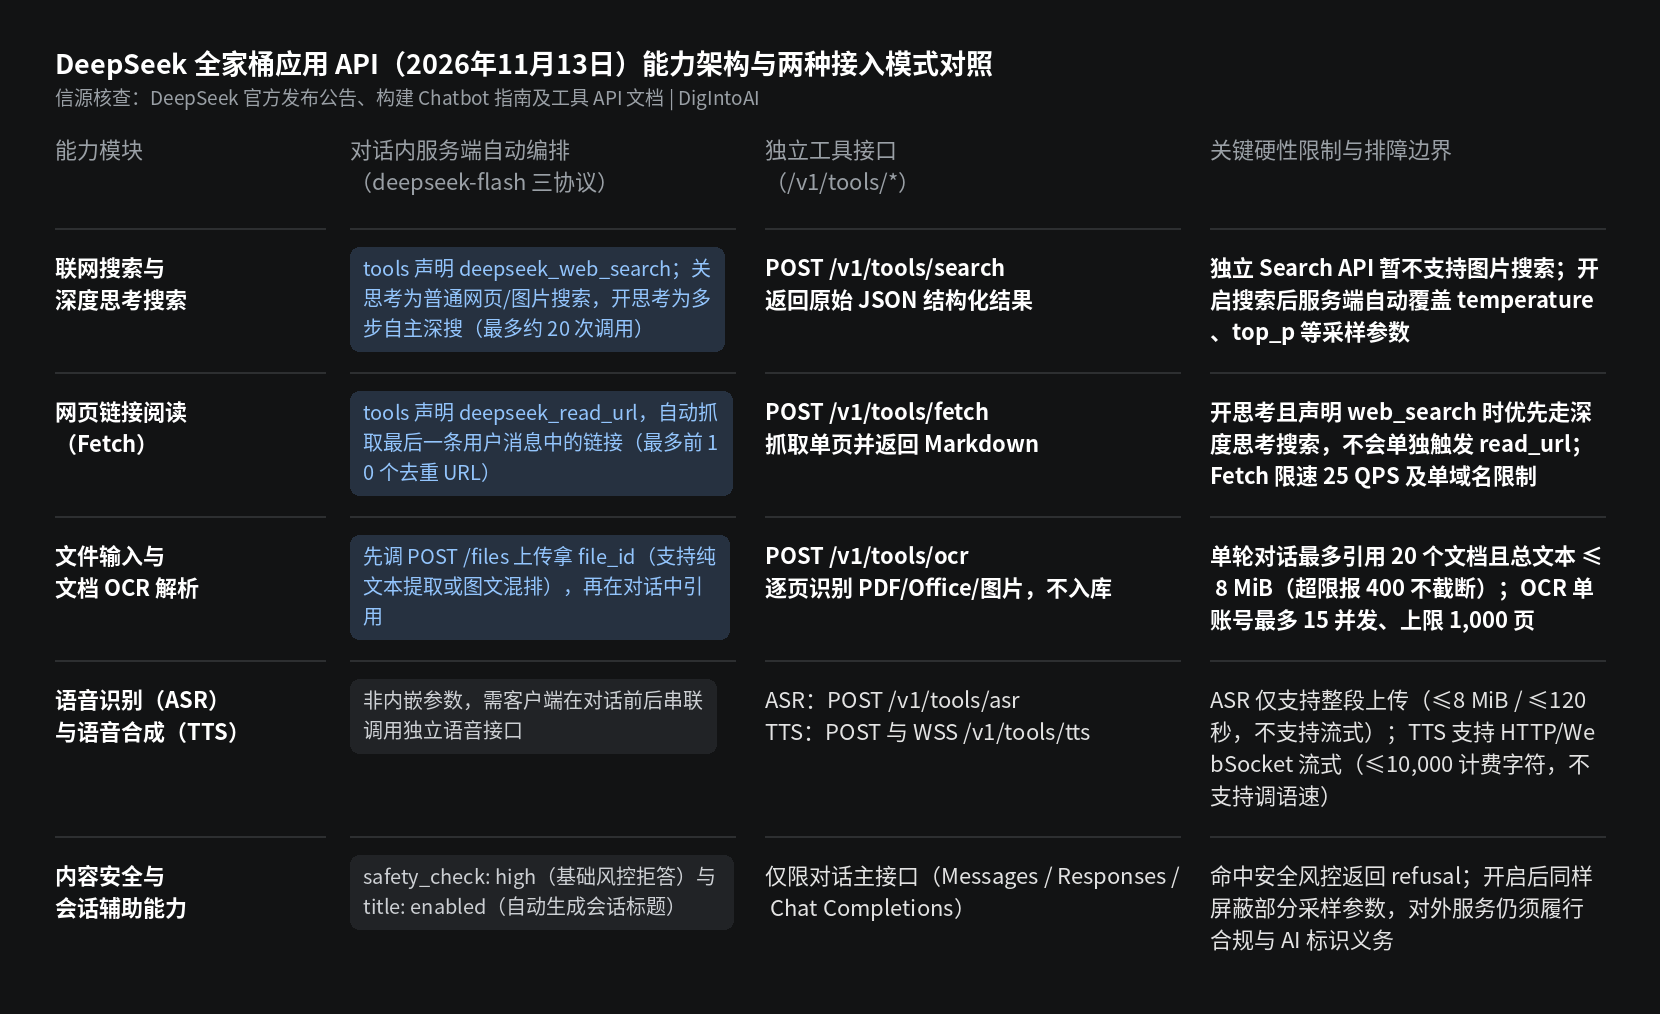
第一,由服务端全自动执行的对话内扩展能力:当你在请求中声明 deepseek_web_search 工具时,若关闭思考模式,服务端会根据提问自动触发普通网页搜索或图片搜索并返回引用角标;若开启思考模式,则会进入多步“深度思考搜索”,由模型在推理过程中自主发起多次搜索、打开页面并检索片段(单轮最多约 20 次工具调用)。若声明 deepseek_read_url 工具,服务端会自动提取最后一条用户消息中的前 10 个去重链接,抓取页面内容并以加密 signature 块拼入上下文。客户端无需自己部署爬虫或搜索代理,只需在前端渲染返回的内容块,并在下一轮对话中原样回传这些内容块即可。
第二,文件输入的两步托管流程(Files API + 对话引用):对于 PDF、Word(DOC/DOCX)、PowerPoint(PPT/PPTX)以及常见图片格式,开发者先调用 POST /files 接口上传文件,通过 purpose 参数选择纯文本提取(text_recognition,不含图片的 Word 与 PPT 会直接提取文本而不走 OCR)或图文混排识别(rich_layout_recognition,逐页解析图表与版面)。拿到返回的 file_id 后,只需在对话消息中引用该 ID,服务端就会将解析后的内容拼入上下文。对于纯文本、代码文件(txt/md/csv/json)以及电子表格(xlsx/xls)和电子书(epub/mobi),上传时将 purpose 设为 user_data 即可由服务端免费转换为 Markdown。
第三,需要开发者自行串联组合的独立工具接口(/v1/tools/):如果业务场景不是通用聊天机器人,而是定制化工作流,可以直接调用五个独立的 REST 或 WebSocket 接口——包括网页搜索(POST /v1/tools/search,支持 site: 与 -site: 语法,但暂不支持图片搜索)、单页抓取(POST /v1/tools/fetch,返回 Markdown)、文档逐页识别(POST /v1/tools/ocr,不存入 Files 存储也不直接送入对话模型)、语音识别(POST /v1/tools/asr,支持含中、粤、英、日、韩在内的 21 种语言自动识别)以及语音合成(支持 POST /v1/tools/tts 整段流式返回与 wss://api.deepseek.com/v1/tools/tts 分段流式合成,内置海星女声 stella 与暗潮男声 tide,自动识别中英日等 10 种语言)。例如,语音助手可按“前端录音 → ASR 接口转文字 → deepseek-flash 流式生成文本 → WebSocket TTS 边生成边播报”的管线自由组装。
图片来源:DigIntoAI 根据 DeepSeek 官方发布公告及 API 开发者文档整理制作。
调用一次有哪些费用?完整成本账本拆解
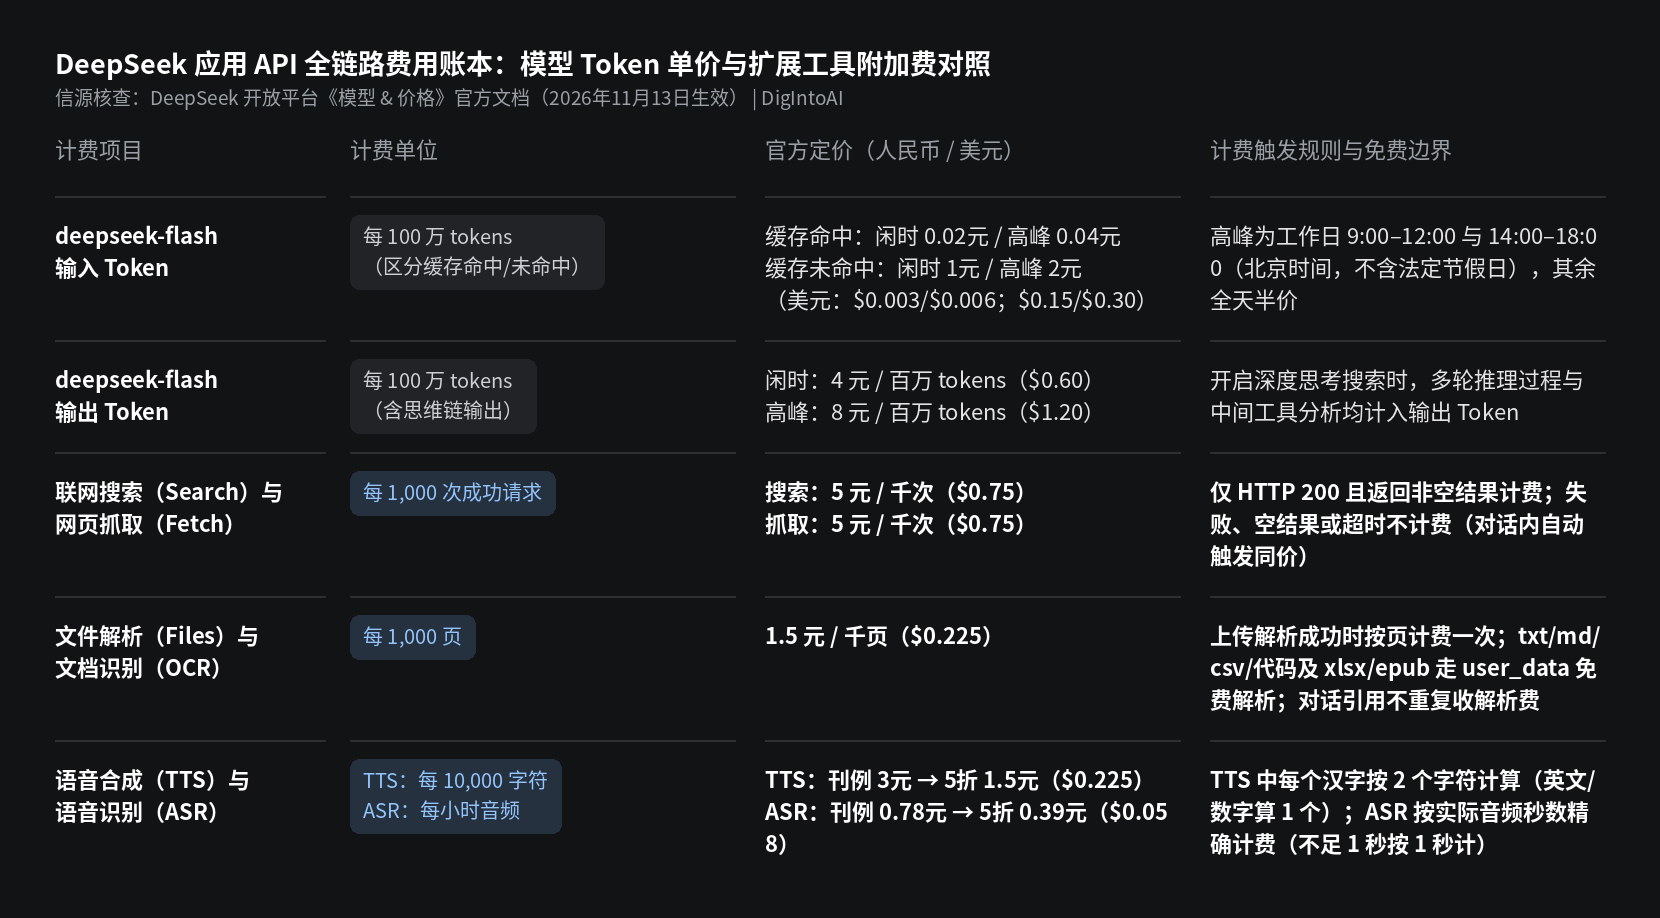
DeepSeek 在公告中明确提示,使用应用 API 扩展能力时,总费用由“模型输入输出 Token 费用”与“扩展工具调用费用”两部分叠加构成,扣费时优先消耗账户赠送余额:
基础模型 Token 费用(deepseek-flash):延续分时定价策略——北京时间周一至周五(不含中国法定节假日)9:00–12:00 与 14:00–18:00 为高峰时段,其余时段及周末节假日全天为半价空闲时段。空闲时段输入缓存命中仅需 0.02 元/百万 tokens(高峰 0.04 元),缓存未命中 1 元/百万 tokens(高峰 2 元),输出 4 元/百万 tokens(高峰 8 元)。需要注意的是,开启深度思考搜索时,多轮检索与分析产生的思维链和最终回答均计入输出 Token。
联网搜索(Search)与网页抓取(Fetch)按次计费:无论是对话内模型自动调用,还是直接请求独立接口,搜索(含网页与图片搜索)和网页抓取均按每 1,000 次 5 元(英文价目表为 0.75 美元/千次)计费。官方设定了严格的成功计费边界:仅当服务端返回 HTTP 200 且产生有效结果(搜索返回非空结果数组、抓取返回页面正文)时才扣费,超时、报错或空结果均不计费。
文件解析(Files)与 OCR 按页计费:按每 1,000 页 1.5 元(0.225 美元/千页)计费,且仅在上传解析成功时一次性扣费;走 user_data 上传的纯文本、代码、Excel 表格与电子书不收解析费;后续多轮对话中重复引用同一个 file_id 也不会再次收取解析费,仅按实际进入上下文的输入 Token 计费。
语音合成(TTS)与语音识别(ASR)当前享 5 折优惠:TTS 刊例价为每 10,000 字符 3 元,当前限时 5 折为 1.5 元(0.225 美元),计费规则上每个汉字按 2 个字符计算,英文字母、数字与空格按 1 个字符计算;ASR 刊例价为每小时音频 0.78 元,限时 5 折为 0.39 元(0.058 美元),按音频实际时长精确到秒计费(不足 1 秒按 1 秒计)。
图片来源:DigIntoAI 根据 DeepSeek 开放平台《模型 & 价格》官方文档整理制作。
接入限制与高频排障边界(上线前必查)
根据《构建 Chatbot》与各工具接入指南,开发者在迁移或上线时容易遇到以下五处硬性边界:
模型范围限制:上述对话内嵌应用能力目前仅在 deepseek-flash(2,500 并发上限)上开放,旗舰模型 deepseek-v4-pro 暂不支持图像理解及该套应用套件。
参数覆盖与静默忽略规则:只要请求中声明了 deepseek_web_search、deepseek_read_url,或开启了 safety_check(设为 high)与会话标题生成(title.enabled),服务端就会接管采样策略,并静默忽略请求中传入的 temperature、top_p、top_k(Messages)、frequency_penalty / presence_penalty(Chat Completions)以及 preserve_thinking 等参数。此外,max_tokens(Responses API 为 max_output_tokens)限制的是单轮中每一步推理的最大输出长度,而非整轮多步搜索的总输出长度。
工具触发互斥与链接数量上限:开启 deepseek_read_url 时,服务端仅检查最后一条用户消息中的前 10 个去重 URL;如果同时开启了思考模式与 deepseek_web_search,该轮会直接走深度思考搜索流程,不会单独触发 read_url。
文件引用上限与非截断报错:单轮对话请求最多引用 20 个文档,且所有引用文档的提取文本总大小不得超过 8 MiB;多轮对话中已引用的文档完整文本会持续保留在上下文里,一旦总长度超出 1M 上下文上限,接口会直接返回 HTTP 400 错误,而不会在后台静默截断文档内容。
语音接口的流式与功能边界:独立 ASR 接口目前不支持流式语音识别,单次请求必须发送完整的 16 位 PCM WAV 或 Ogg Opus 文件(最大 8 MiB、最长 120 秒,双声道仅识别左声道);TTS 接口单次上限 10,000 计费字符(最长 30 分钟音频),暂不支持调节语速或断线续传,且音频流中途断开必须视为合成失败重试。另外,对外提供公众服务的开发者必须开启 safety_check 参数,并自行履行内容安全审核、大模型登记及 AI 生成内容标识等法定合规义务。