
本文目录
2026 年 11 月 18 日(北京时间 11 月 19 日凌晨),自由职业设计平台 Contra Labs 与评测基础设施团队 BenchFlow 联合发布网页与产品设计基准 Frontier Design Benchmark。在官方公布的 17 个参测对象(16 个 AI 模型与 1 组人类设计师参考稿)中,一个标注为隐藏身份(stealth)的未公开模型 Gestalt 引发业界高度关注——在 11 月 19 日查询的官方实时排行榜上,Gestalt 以 1931 Elo 分、90% 盲测胜率登顶榜首,将人类专业设计师参考稿(1739 分)与已公开最强模型 Claude Fable 5.2(1713 分)甩在身后。
榜单数据全览:Gestalt 越过人类基准,公开模型出现 204 分断层
两个官方时间快照的精确对齐:引用该榜单时需注意官方文章与实时看板的数据快照差异:在 11 月 18 日发布博文正文的统计快照中,Gestalt 记录为 1,928 Elo 分(89% 胜率,423 场赢下 378 场),Claude Fable 5.2 为 1,714 分;而在 11 月 19 日查询的实时排行榜页面上,随着票数累计至 4,311 票,Gestalt 更新为 1931 Elo 分(90% 胜率,95% 置信区间 86%–92%,420 票),人类设计师参考稿(Human golden)位列第二,为 1739 分(74% 胜率,95% 置信区间 71%–78%,571 票)——Gestalt 的 95% 置信区间下限完全高于人类参考稿上限,且在 28 场与人类参考稿的直接盲测对决中被设计师选中 20 次。
第一梯队 6 款公开模型与后段 9 款模型的明显断层:在已公开身份的 16 款商用与开源模型中,排名前六的型号紧密聚集在 1638 至 1713 Elo 之间,包括 Anthropic 的 Claude Fable 5.2(1713 分,单站生成成本 $127.22 起)、Claude Opus 5.5(1691 分,单站 $24.26)、OpenAI 的 GPT-6.1 Sol(1668 分,单站 $1.31)、Anthropic 的 Claude Sonnet 5.5(1667 分,单站 $20.49)、月之暗面的 Kimi K3.1 Pro(1663 分,单站 $1.91)以及 OpenAI 的 GPT-6 Astra(1638 分,单站 $7.33)。自第九名阿里 Qwen3.8 Max(1434 分)起,后续 9 款模型(含 Kimi K3、GLM-5.3 Prime、Gemini 4 Carbon、Meta Muse Spark 1.3 与 Muse Wonder、Grok 4.7、Gemini 4 Argon 及垫底的 DeepSeek V4 Pro 1121 分)均落在 1434 分以下,与第一梯队拉开 204 分的明显差距。
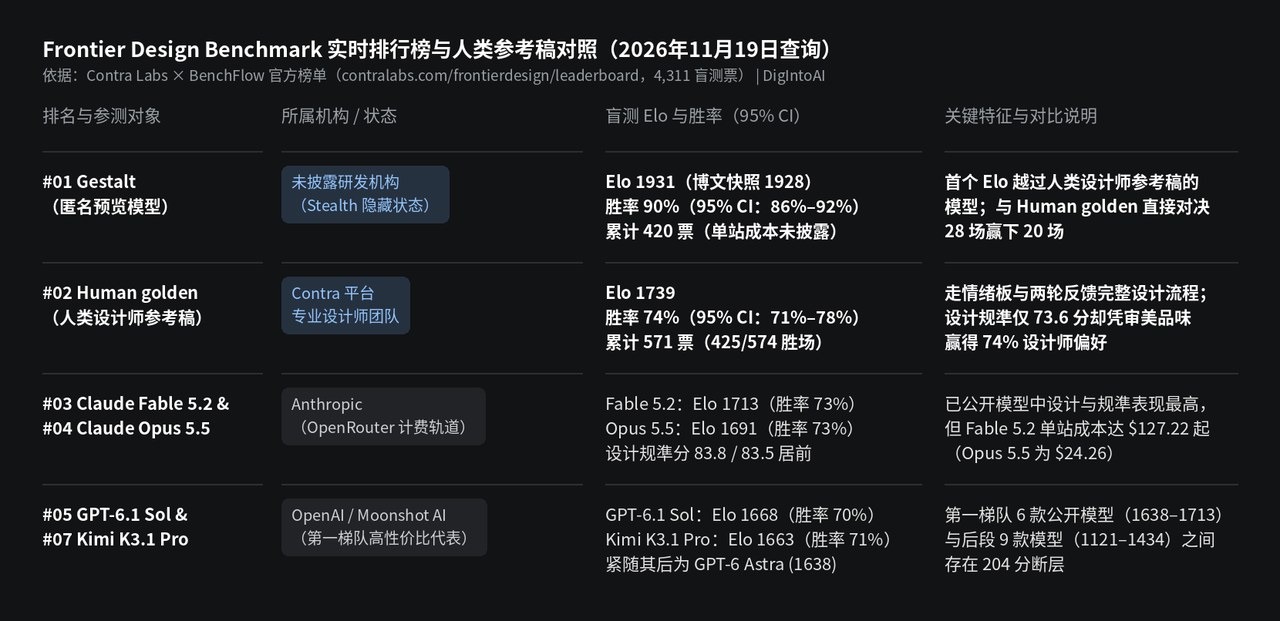
图片来源:DigIntoAI 根据 Contra Labs × BenchFlow 官方排行榜数据整理制作。
不只是「咖啡馆落地页」:真实客户需求与三维制衡评测
33 个真实商业委托题与原厂 Harness 执行:Contra Labs 分析了平台过去一年 4,600 个网站订单后发现,真实客户需求书中位数达 138 个英文词、预算中位数 $1,050,且 75% 叠加了品牌资产、目标客群或交互流程约束。因此,Frontier Design Benchmark 选取了 27 个改写自 Contra 付费项目的需求书与 6 个初创公司真实项目(其中 19 题提供客户原始 Logo,17 题要求移动端适配,涵盖票务营销站、众筹结账、在线课程测验与博物馆语音导览等完整可运行应用)。评测时,BenchFlow 在沙箱中通过 OpenRouter 调用模型,并尽可能让每个模型运行在各自实验室的原生 Agent Harness 中,因此榜单反映的是「基座模型 + 原生工具链」的综合交付水准。
设计规准与人类审美投票的分歧点:除 35 位专业设计师(中位从业年资 8 年,首页宣传横幅提及 68 位网络设计师)的盲测投票外,团队还引入了 34/35 项设计维度规准(Design Rubric)与 0–100 分的「AI 味检测器(AI Slop Detector)」。有趣的是,设计规准虽然与模型 Elo 排名高度正相关(r = 0.94),却把人类参考稿排在第六名(73.6 分,低于 Claude 与 GPT 五款模型),原因是人类参考稿存在按钮文字对比度偏低或局部字标裁切等可指出的执行瑕疵;但盲测投票中设计师仍把 74% 的选票(425/574)投给了人类参考稿,印证了自动化规准只能排查规则错误,无法替代人类的整体审美格调(Taste)。而在 AI 味检测器中,人类参考稿读数为 0.9,Gestalt 仅为 1.2(兼具高完成度与极低的「标题上方小字大写标签、标题斜体词、01/02/03 编号段落、万物皆卡片」等典型 AI 模板痕迹)。
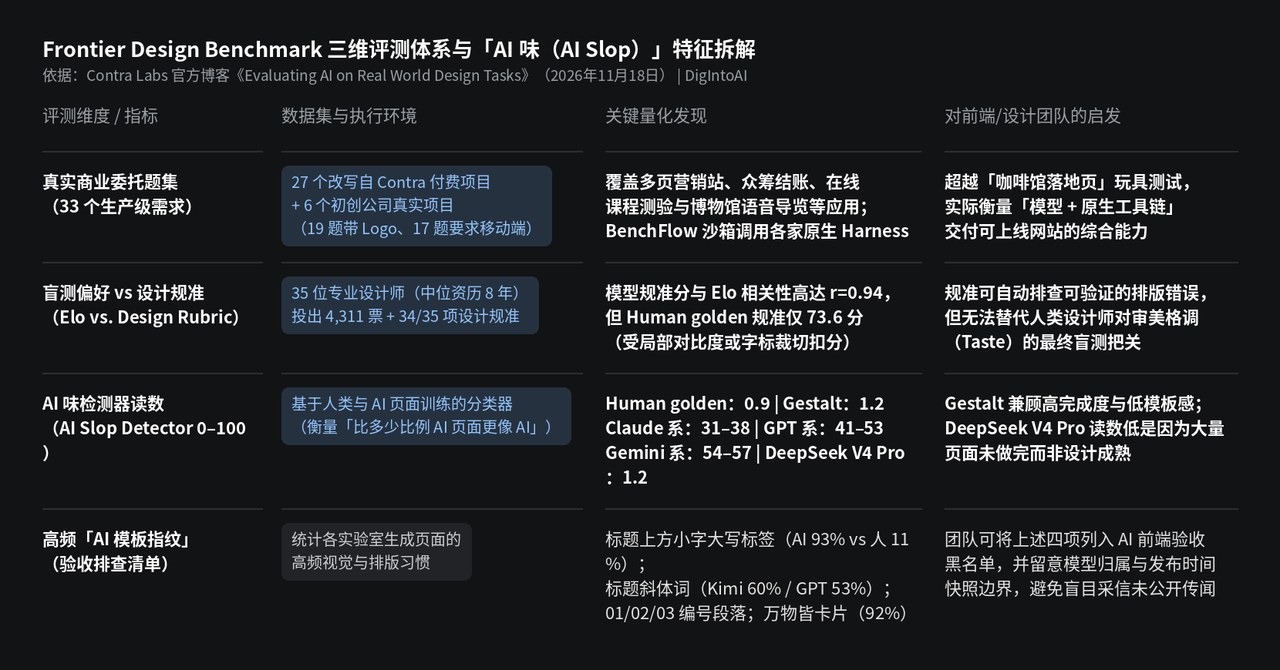
图片来源:DigIntoAI 根据 Contra Labs 官方博客方法学与评测结果整理制作。
Gestalt 身份与适用范围的三条事实边界
官方严格保留匿名状态,切勿采信无实证的厂商猜测:Contra Labs 与 BenchFlow 在官方博客与排行榜中仅将 Gestalt 定位为「目前处于隐藏阶段的高品质设计模型」(currently in stealth),既未披露其背后的研发机构或模型参数,也未公布生成成本与公开上线时间表(其余 16 款模型均走 OpenRouter 计费轨道,唯独 Gestalt 成本栏留空)。报道与引用时需明确三条边界:第一,该榜单衡量的是商业网页与前端应用设计能力,而非通用推理或后端算法全能榜;第二,成绩包含模型所属实验室原生工具链的加成效果;第三,在官方或模型研发方正式认领前,不应将任何未发布的传闻型号直接等同于 Gestalt,亦不应将其与 2026 年 9 月学术界发表的同名视觉理解模型论文混淆。