
北京时间 2026 年 11 月 13 日凌晨(太平洋时间 11 月 12 日),Google DeepMind 副总裁兼 Google 首席 AI 架构师 Koray Kavukcuoglu 在官方博客宣布推出 Gemini 4 Hydrogen(API 模型 ID 为 gemini-4-hydrogen)。
此前在 11 月初的开发者社区中,曾有传言称 Hydrogen 只是内部测试的影子检查点,甚至猜测它会沿用 Gemini 3.8 Flash 的低价策略。随着今天官方博客、Google AI Studio 文档以及 OpenRouter 的同步上线,这款模型的真实定位终于落定:它是 Gemini 4 家族里的“高效率主力模型(Workhorse)”,正式接替 gemini-3.8-flash 成为 Google API 的默认通用模型,同时全面接管消费者端的 Gemini App 与全球 Google 搜索。
一、 先看核心参数与价格账本:比 3.8 Flash 涨了一倍,但换来跨代性能
在 Gemini 4 的“元素周期表”产品线里,先行发布的 Gemini 4 Carbon 和 Gemini 4 Argon 定位是慢思考、深推理的前沿旗舰(类似传统的 Pro / Ultra 档位);而 Gemini 4 Hydrogen 则承担了高频代码编写、Agent 并发执行和日常多模态处理的任务。
从 Google AI Studio 最新更新的文档卡片来看,Hydrogen 的核心规格如下:
- 模型 ID:gemini-4-hydrogen
- 上下文窗口:100 万(1M)统一 tokens(支持文本、图片、音频、视频及 PDF 输入)。
- 最大输出长度:默认 64K tokens,通过 Long Decode(长解码续写)最高支持 100 万(1M)输出 tokens。
- 思考档位(Thinking Levels):提供 low、medium、high(默认档)以及全新的 xhigh 四个档位(注:Carbon 和 Argon 目前仅提供 low / medium / high 三档,默认档为 medium)。
- API 统一定价:在整个 100 万上下文窗口内采用平价计费(Flat pricing,不按长短上下文阶梯涨价),每百万输入 tokens 1.50 美元,每百万输出 tokens 7.50 美元。
把价格放到当前 Google 的模型矩阵里对比,有几个细节非常值得开发者注意:
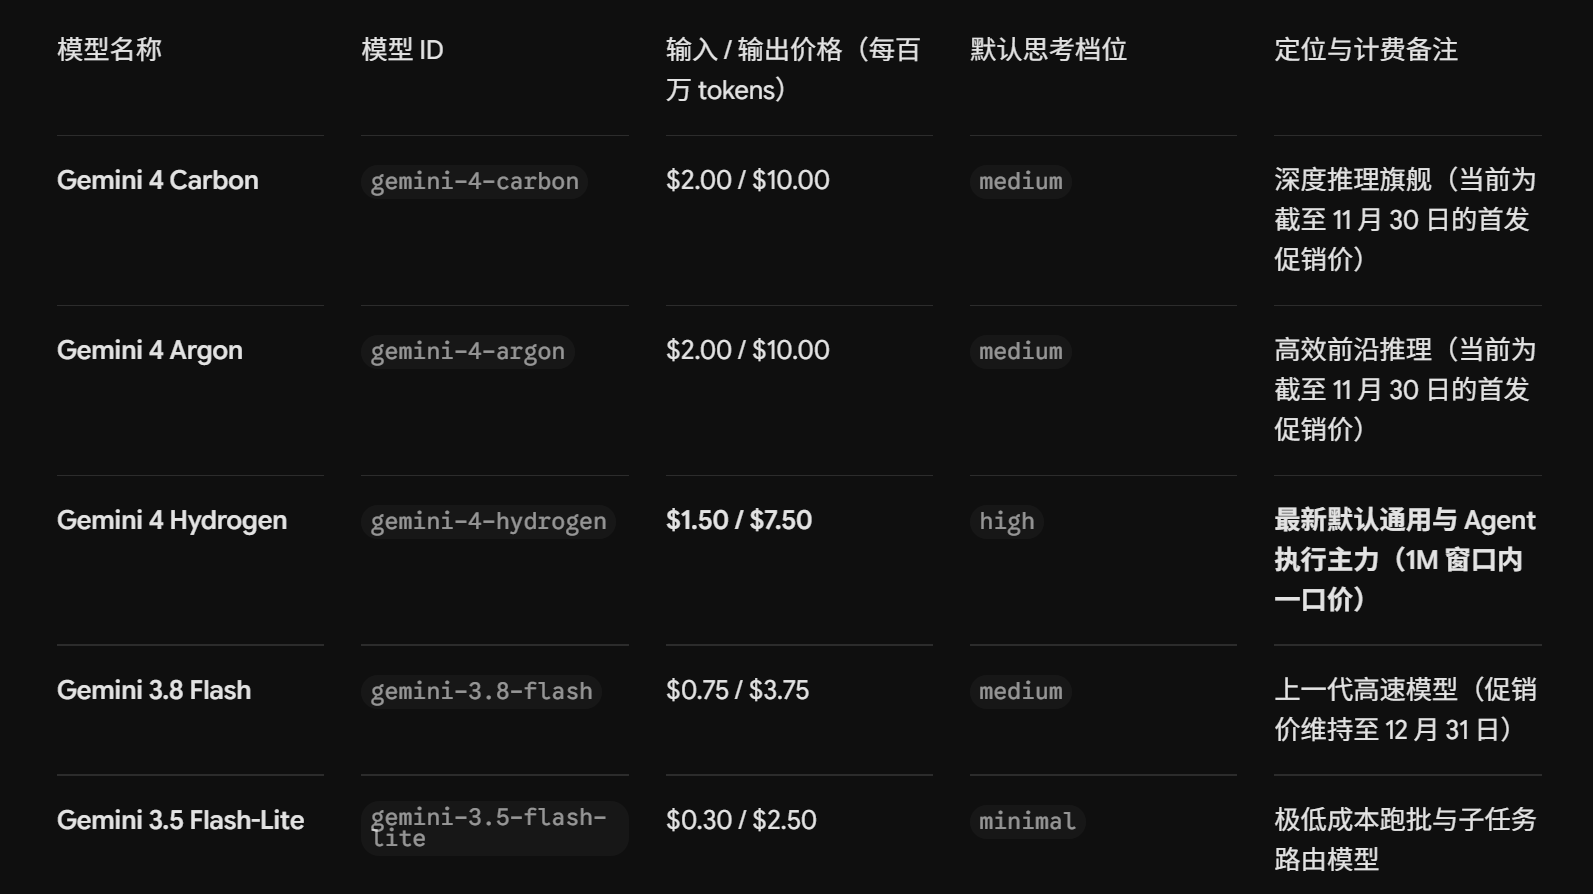
可以看到,Hydrogen 的价格并没有像此前社区猜测的那样维持在 $0.75 / $3.75,而是直接翻倍到了 $1.50 / $7.50。并且要注意,目前 Carbon 和 Argon 的 $2.00 / $10.00 只是截至 11 月 30 日的限时首发价;等到 12 月 1 日旗舰模型恢复原价后,Hydrogen 与旗舰档之间的价格梯度才会真正拉开。
此外,OpenRouter 已于 11 月 12 日同步上架 google/gemini-4-hydrogen,标准费率同样为 $1.50 / $7.50。如果企业通过 OpenRouter 的欧盟区域路由(eu.openrouter.ai,底层调用 Google Vertex 欧洲节点)访问,费率则为每百万输入 tokens 1.65 美元、输出 8.25 美元。
二、 开发者与工程表现:在 Google Antigravity 中引入 Orchestrator 多模型协同
对于写代码和搭 Agent 的团队来说,Google 这次主推的是“多模型混用”与“仓库级精准修改”。
- Antigravity 新增 Orchestrator(动态编排器):
在实际软件工程中,完全用 Carbon 跑全流程既慢又费钱。Google 在自家的 Agent 开发平台 Google Antigravity 中推出了 Orchestrator 功能,可以在同一个会话里动态切换模型——让 Carbon 充当总协调员(Coordinator)负责架构判断和疑难杂症,把具体的写代码、跑测试、在隔离工作区里并发验证的任务拆给多个 Hydrogen 实例(Worker / Verifier)。官方数据显示,在 Terminal-Bench 4.0 测试中,Orchestrator 达到了接近纯 Carbon 的任务成功率,但平均少消耗了 24% 的配额,整体完成速度提升了 19%。
- 相比 Gemini 3.8 Flash 的跨代跃升:
在默认的 high 思考档位下,Hydrogen 完成任务的速度比 3.8 Flash 快 2.5 倍,同时在 Terminal-Bench 4.1 上的得分翻了三倍以上(57% 对比 18.2%),捏造事实(幻觉)的比例降低了 5 倍以上。
- 在智商指数上反超同门师兄 Argon:
更有意思的是,在 Artificial Analysis Intelligence Index(智能指数)测试中,Hydrogen 在默认的 high 档位下拿到了 51 分,直接压过了 Gemini 4 Argon(50 分);如果开到最高档 xhigh,分数还能进一步拉升到 54 分。
- 并行读取与专业领域基准:
在探索大型代码库时,Hydrogen 不再一个文件一个文件地串行查看,而是原生支持将文件读取(file-read)和搜索调用打包并行处理。据早期合作伙伴在复杂图计算和 SQL 企业工作流中的实测,其运行速度比 3.8 Flash 快 2 到 2.8 倍,Token 消耗反而减少了 12% 到 23%。在公开榜单上,它在 Agent Arena 实时榜排第 5,拿下了 Vals 税务 Agent 榜(52.3%)和法律研究榜(55.8%)的第一名,并在最新的多模态知识工作基准 MKA(53.4%)和 Agents' Last Exam v1.1(71.6%)中领先同级模型。
三、 日常办公、Gemini App 与 Google 搜索的全面升级
除了面向开发者的 API,Google 今天同步把 Hydrogen 推向了所有日常消费级产品:
- 日常写作与指令遵循:在 Gemini App 中,Hydrogen 大幅减少了多轮对话里的“来回拉扯”。由于它能严格遵循用户设定的语气、格式和特定规则,无论是写邮件草稿、做学习指南、改写文稿还是生成复杂文档,基本都能一次成型、直接拿来用。在做产品对比或整理高密度资料时,它会主动拉出清晰的对比表格和可视化拆解,不会漏掉关键细节。
- 跨应用调取上下文:它能把用户的目标按步骤拆解,自动从用户上传的文件、Gmail、Google Drive 以及 Airtable、Dropbox 等已连接应用(Connected Apps)里提取上下文,并更准确地调用对应的工具和技能(Skills)。比如在 Google Sheets 中,它生成动态财务预测模型的速度比旧模型快了 30% 以上。
- Google 搜索迄今最大规模的模型升级:Google 搜索产品副总裁 Robby Stein 发文称,Hydrogen 已面向全球所有 Google 搜索用户上线。现在的搜索能更好理解带有错别字、多重要求或顺着自然思绪随口一问的复杂长句;同时强化了“查询扇出(Query Fan-out)”技术,能针对问题涉及的所有子话题同时发起并发检索,挖出以前很难被发现的深层网页链接,并以图表、对比表和定制小工具的形式返回高可视化的结果。
四、 安全护栏与对齐数据
由于 Hydrogen 是一个跑在高频日常任务和自动化脚本里的快速模型,Google 披露了几项针对 Agent 失控风险的内部评估数据:
- 相比 3.8 Flash,Hydrogen 在 Agent 任务中的“越界操作(Overreach)”减少了最多 81%,“消极怠工(Under-service)”减少了最多 79%,在工具调用和编程评估中走捷径或违背指令的行为减少了 12 倍。
- 面对无法完成或被权限拦截的任务时,它试图绕过权限边界的概率降低了 2 倍,内部诚实度测试得分为 96.7%。
- 在超过 20 万轮受审计的对话中,其思维链(CoT)保持了 99.9% 的可读性,未发现篡改或伪造推理过程的行为;在抵抗间接提示词注入(Gray Swan IPI 基准)上防御力提升了 2.3 倍以上,同时把医疗健康领域的误判拒答率(HealthBench Pro)压到了 0.4% 以下。
五、 边界核查:这需要注意什么?(排除法与限制说明)
在决定切换模型或升级订阅之前,有几条客观边界需要看清:
- Gemini App 免费用户不能手动锁死该模型:
虽然官方宣称“今日起面向所有人开放”,但博客文末的尾注 1 明确写着:在 Gemini App 中,免费层(Free tier)用户只能通过“自动模型选择(auto model selection)”功能,在系统判定当前提示词适合调用 Hydrogen 时被动使用它;想要在模型下拉菜单里手动指定或者在 Google Antigravity、Google Sheets 中深度使用,仍需 Google AI Pro / Ultra 付费订阅或企业版席位。
- 这不是廉价的 Flash-Lite 替代品:
$1.50 / $7.50 的定价比 Gemini 3.5 Flash-Lite($0.30 / $2.50)贵了整整 5 倍(输入)和 3 倍(输出),也比刚发布的纯分类接口 Gemini Decision 1($0.10 / $0)高出许多。如果你的场景只是简单的高频打标或提取,直接换 Hydrogen 会导致账单暴涨。
- 默认档位是 high,需要注意输出 Token 消耗:
与 Carbon 和 Argon 默认设在 medium 不同,Hydrogen 的默认思考档位直接设在了 high。虽然官方表示它在同级模型中用更少的输出 Token 完成任务,但在对延迟敏感、且不需要深度推理的简单接口调用中,开发者最好在 API 请求里显式把思考档位调低至 low 或 medium。
- 各项跑分与提速倍数均来自官方与早期伙伴自测:
无论是“比 3.8 Flash 快 2.5 倍”还是“Token 节省 12%–23%”,目前均为 Google 官方及早期内测伙伴的基准数据,我们在生产环境中的真实长文本首字延迟(TTFT)与并发稳定性尚未实测。