
本文目录
2026 年 11 月 13 日,由 Georgi Gerganov 领衔的 ggml-org 团队正式发布了 llama.cpp v1.0.0 与底层张量库 ggml v1.0.0。在过去三年半里,这个从单文件 CPU 推理原型成长起来的项目已经支持超过 150 种模型架构变体,成为 Ollama、LM Studio、Jan、LocalAI 以及无数移动端与桌面端应用的核心推理底座,但在此之前它一直采用按提交递增的构建编号(直至 b12374),没有引入正式的语义化版本号。
迈入 v1.0.0 的真正意义,不在于单次功能列表的堆砌,而在于项目治理契约的转变:ggml-org 正式将 llama.cpp/include/ 与 ggml/include/ 下的公共头文件确立为受语义化版本保护的稳定契约,明确承诺今后只有主版本号递增(MAJOR)才会引入公共 C API 与二进制接口(ABI)的破坏性变更。
为什么本地 AI 生态急需 C API 与 ABI 稳定性契约?
在本地推理早期阶段,新模型架构几乎每周都在涌现,快速迭代的代价是下游集成方承受着极高的适配摩擦成本。在无大版本号的 bXXXX 时代,上游一次常规重构就可能删除某个旧初始化函数、修改上下文参数结构体的内存布局,或者调整后端回调签名。对于直接调用动态链接库(libllama 与 libggml)的下游软件而言,这带来了两类痛点:
第一,语言绑定与桌面应用的“锁哈希困境”:诸如 llama-cpp-python、Rust 绑定、Go 绑定以及各类跨平台 GUI 启动器,过去往往不敢直接追踪上游主干分支,只能把依赖锁死在某个特定的 commit 哈希上,每隔几周再集中做一次痛苦的适配移植。一旦需要紧急接入某个刚发布的新模型架构,下游团队往往被迫在“手动向后移植模型代码”与“全量重写胶水层接口”之间二选一。
第二,动态硬件后端插件的二进制兼容性需求:随着 ggml 将计算后端拆分为可在运行时按需加载的动态库(覆盖 NVIDIA CUDA、AMD ROCm、Apple Metal、Vulkan、OpenVINO、SYCL 以及高通 Hexagon NPU),如果底层张量库的 ABI 频繁变动,不同硬件厂商维护的动态后端插件就无法在不重新编译主程序的情况下独立升级。
v1.0.0 确立语义化版本后,下游工程团队终于可以把依赖策略从“按特定构建哈希锁死”切换为标准的“主版本锁定(如 ^1.0.0)”:在所有 1.x.y 生命周期内,次版本升级(MINOR)只会以向后兼容的方式增加新模型支持、新硬件后端或扩展接口,修订版本(PATCH)则仅包含零接口变动的缺陷与安全修复。
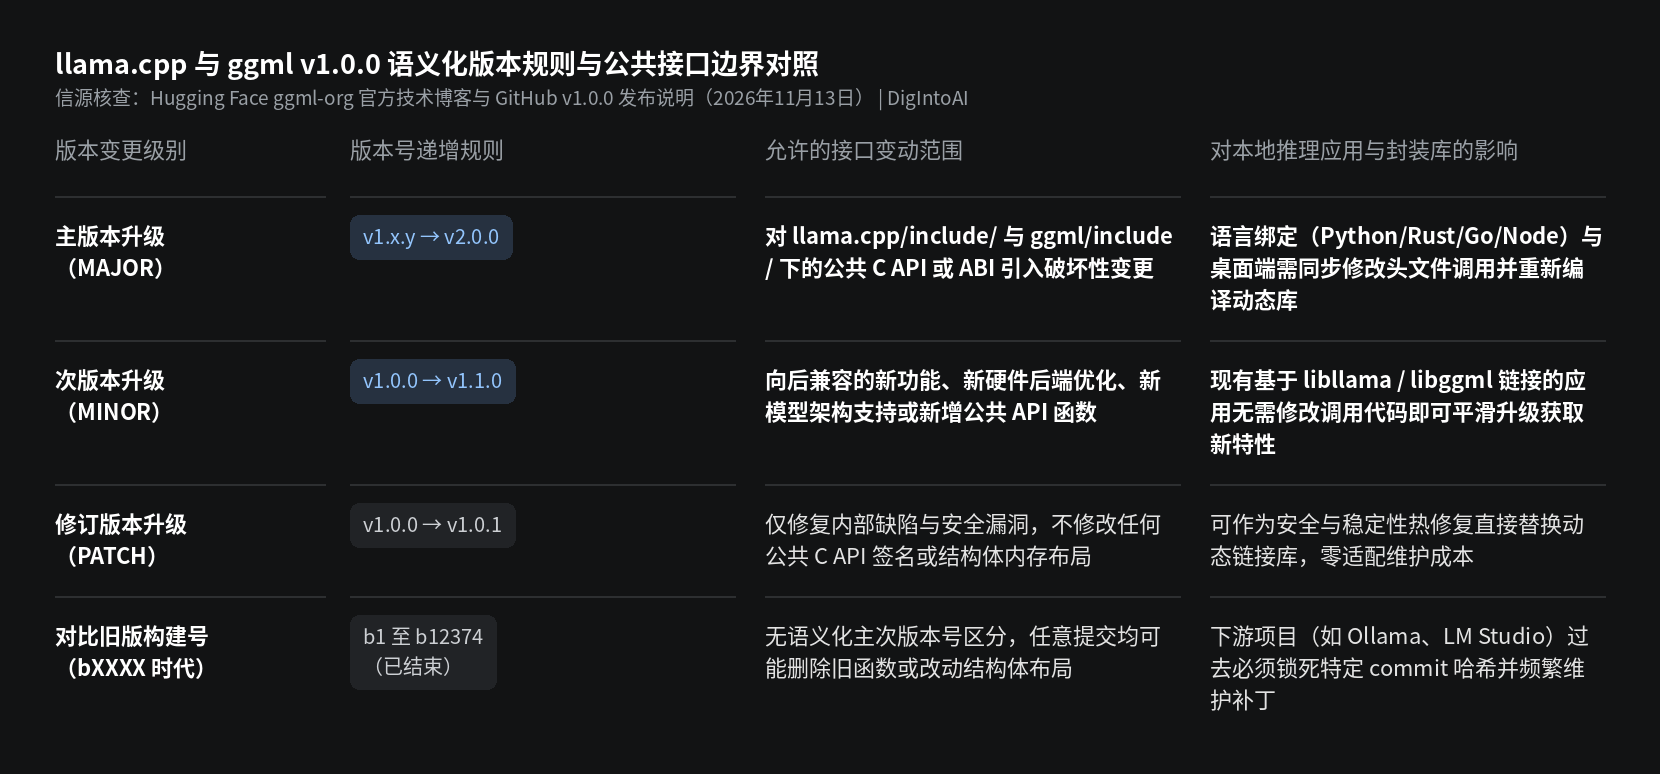
图片来源:DigIntoAI 根据 ggml-org 官方发布博客及 GitHub 版本说明整理制作。
v1.0.0 升级实操:哪些破坏性变更必须先清理?
在享受 1.x 系列向后兼容承诺之前,v1.0.0 本身是一次集中清理历史技术债的“断代升级”。开发者在将现有项目从 b12374 或更早版本迁入 v1.0.0 时,重点需要核查四类变化:
清理 35 个已弃用公共符号与结构体调整:v1.0.0 在 llama.h 中正式移除了 llama_set_warmup 等 35 个长期标记为弃用的公共函数,同时删除了 defrag_thold 字段及对应的命令行参数。原本位于实验头文件 llama-ext.h 中的 NextN 投机解码接口被正式晋升进公共头文件 llama.h,状态设置函数则统一重命名为 llama_set_ctx_state_src。多模态侧也移除了旧的 clip.h,将视觉与音频子上下文基础设施全部收拢进统一的 mtmd 模块。
利用官方多渠道发行包简化分发管线:伴随 v1.0.0 发布,ggml-org 同步规范了跨平台官方分发矩阵,覆盖 Linux/macOS/Windows/Android/iOS 预编译包、Docker 镜像、Debian 软件源、Homebrew、conda-forge、MacPorts、Windows Winget 以及面向苹果生态的 XCFramework。对于桌面端或移动端 App 开发者,不再需要自行从源码交叉编译全套工具链,可直接对接标准包管理器或预编译动态库。
排查 llama-server 默认安全策略收紧带来的连接拦截:v1.0.0 对内置 HTTP 服务端做了大幅安全加固,默认修复了 CORS 代理 SSRF、DNS 重绑定以及子实例越权访问隐患,并将环境变量中的 HF_TOKEN 严格限定仅向 huggingface.co 域名发送。如果你的本地工作流依赖未经认证的本地工具调用,升级后需要显式传入 --allow-unauthenticated-tools 参数,否则服务端会默认拒绝执行。
把新特性纳入 1.x 渐进式升级路径:完成 1.0.0 基线对齐后,开发者可以直接在现有调用代码上渐进启用本次同步落地的新特性——例如通过参数开启 OCP FP8 KV 缓存压缩长上下文显存占用,或为大尺寸稀疏 MoE 模型配置主机内存专家缓存比例(moe_cache_cpu_share),而无需担心下个月升级 v1.1.0 时再次推翻接口封装。
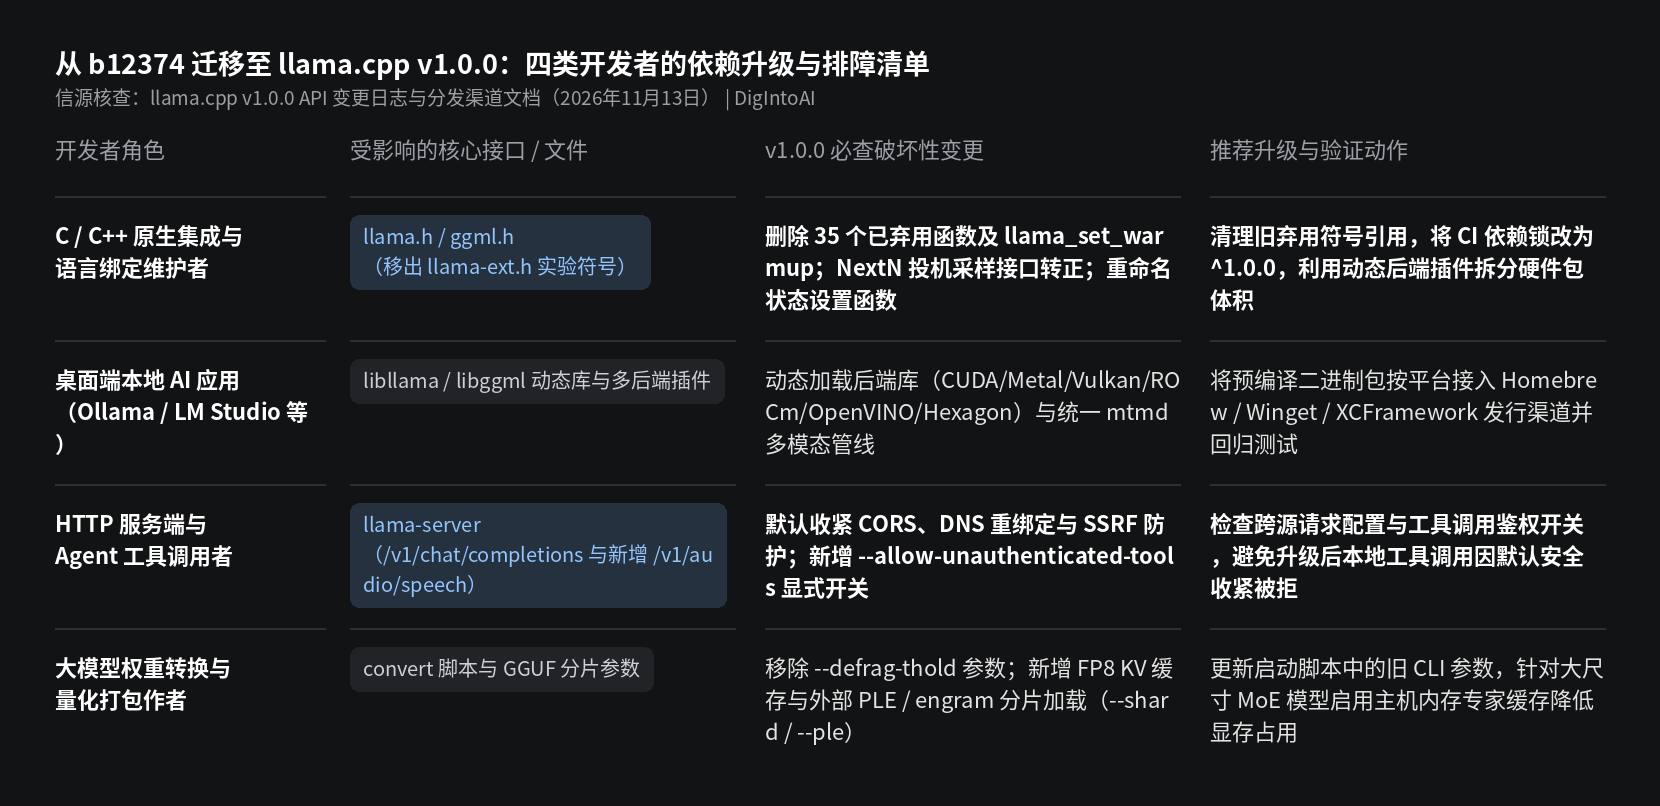
图片来源:DigIntoAI 根据 llama.cpp v1.0.0 公共头文件变更日志整理制作。
边界说明与工程建议
在评估 llama.cpp v1.0.0 的稳定性承诺时,仍有两项工程边界需要保持清醒:
稳定的是公共 C API 与 ABI,而非内部实验实现与 CLI 交互细节:语义化版本契约严格覆盖公共头文件(llama.h 与 ggml.h)中声明的 C 接口与二进制布局;如果项目直接引用了内部未导出头文件、底层算子私有结构,或者依赖终端 CLI 输出文本的正则解析,仍可能在次版本更新中遇到变动。因此,生产级封装应严格收敛在官方公共 C API 或兼容 OpenAI 的 HTTP 端点(/v1/chat/completions 与新增的 /v1/audio/speech)之上。
未独立实测项:本文中关于语义化版本维护规则与发行渠道的梳理均基于 ggml-org 官方发布文档与 GitHub v1.0.0 变更记录,我们尚未在多硬件平台上对跨次版本的动态后端二进制替换做独立压测。