
本文目录
2026 年 11 月 12 日,OpenAI 同步发布了 Python SDK v3.50.0(提交哈希 f44c1ec,对应 PR 4268)与 Node SDK v7.56.0(对应 PR 3145),在 Responses API 的返回对象(包含正式版 Response 与测试版 BetaResponse)中正式暴露了 input_transformations 可选字段。在此之前,开发者在无状态模式(store 设为 False)或手动管理多轮对话历史时,如果因为改写上下文导致历史加密推理记录(Reasoning items)被服务端悄悄丢弃,几乎只能通过异常飙升的推理 Token 账单和响应延迟间接猜测;现在,借助这一新字段可以直接定位具体哪一条推理记录被移除以及背后的触发原因。
input_transformations 字段结构与五类移除原因
需要注意的是,input_transformations 属于服务端返回的可读诊断字段,而不是请求侧传入的参数。当请求传入的 input 数组中包含从前序轮次保留下来的加密推理条目,且部分条目在进入模型推理前被服务端过滤拦截时,response.input_transformations 会按照输入顺序返回被移除条目的清单,每个对象固定包含四个属性:type(恒为 reasoning)、id(被移除的原始推理条目 ID)、action(恒为 removed)以及 reason(五选一枚举值):
第一,prefix_mismatch(前缀历史不匹配,日常开发最高频):对于新一代前沿推理模型(如 GPT-6 系列),Responses API 会校验回传的每一个推理条目之前的所有前置对话历史(即该推理条目的 Prefix)。只要你在该推理条目之前编辑了历史消息、截短了工具返回结果、重排了条目顺序,或者在中间插入了新的指令消息,该推理条目就会被判定为前缀失效并被移除。
第二,turn_boundary(跨轮次策略边界):所选模型或请求参数中的 reasoning.context 设置(例如 auto 与 all_turns 的不同策略)不允许跨当前轮次边界继续沿用该推理条目。
第三,model_mismatch(模型切换不匹配):当前续接请求切换到了不同的模型 ID,或者切换到了无法解密、不兼容前序加密推理密文的模型架构。
第四,organization_mismatch(组织归属不匹配):当前 API 请求所使用的 OpenAI 组织 ID 与当初生成该加密推理条目时的组织 ID 不一致,常见于多租户代理网关动态切换组织凭证的场景。
第五,end_user_mismatch(终端用户标识变更):请求中传入的 user 或 safety_identifier 字段值与生成该推理条目时所绑定的终端用户标识不一致,触发了安全与状态隔离校验。
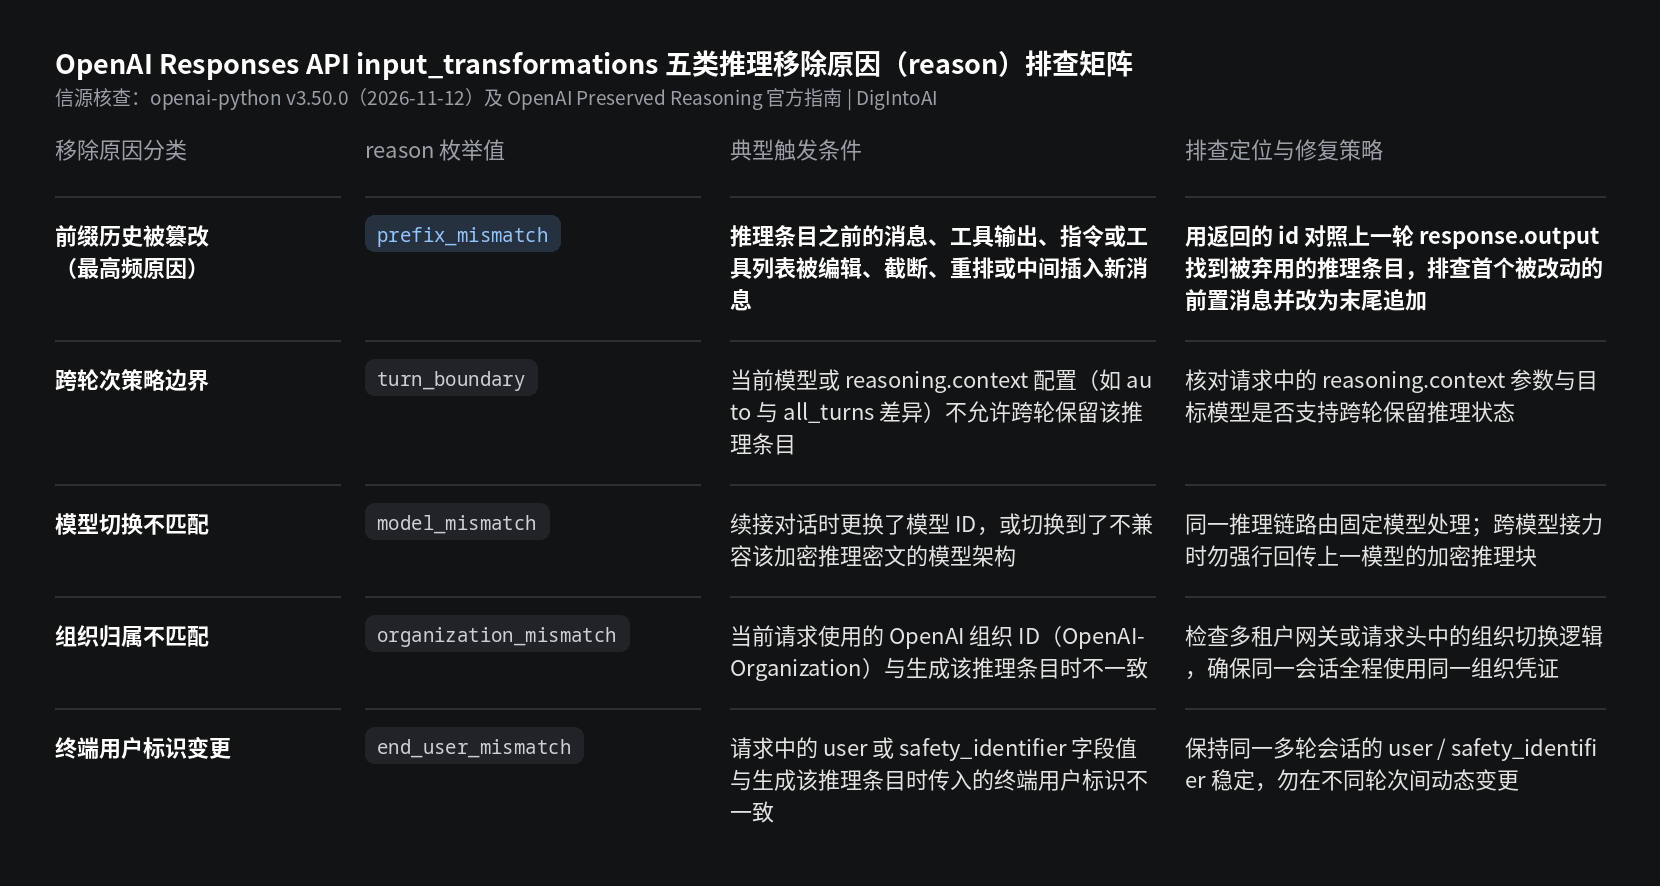
图片来源:DigIntoAI 根据 openai-python v3.50.0 类型定义及 OpenAI API 官方文档整理制作。
静默移除机制与 prefix_mismatch 实战排查四步法
在排查 Responses API 推理失效时,首先要认清一个关键行为边界:当触发 prefix_mismatch 时,OpenAI Responses API 并不会像部分第三方接口那样直接抛出 HTTP 400 报错中断请求,而是静默移除(action 为 removed)受影响的推理条目,继续执行剩余对话,并让模型在后台重新从零生成新的推理过程。这正是许多 Agent 应用在多轮运行后突然出现响应变慢、推理 Token 消耗翻倍却没有任何报错日志的根源。
官方技术文档用账本查询场景演示了“部分保留”规则:假设首轮对话依次包含用户提问、推理条目 A、调用查询工具、工具返回多行原始明细、以及基于明细得出的推理条目 B;如果在下一轮中,你的应用为了省 Token 把历史里的多行明细替换成了一行汇总数字,那么位于修改点之前的推理条目 A 因为前置历史完全一致仍可继续复用,但位于修改点之后的推理条目 B 即使原封不动回传,也会因为前缀被改动而被列入 input_transformations 并遭到移除。
升级到 openai-python v3.50.0 及以上版本后,建议按以下四步建立排查流程:
第一步:记录并检查 response.input_transformations:在每次调用 client.responses.create 后检查返回对象的 input_transformations 属性。如果该列表非空,直接打印每个条目的 id 与 reason。
第二步:用条目 ID 精准回溯上一轮响应:拿到 reason 为 prefix_mismatch 的推理条目 id 后,去日志中对照生成该条目的那一轮 response.output,定位它在原始序列中的准确位置。
第三步:逐项比对前置序列寻找首个改动点:将当前请求传入的 input 列表与原始对话序列从头开始逐条比对,找出该推理条目 ID 之前第一处发生增、删、改、重排的条目(常见元凶包括截短旧的 function_call_output、修改顶层 instructions、或动态增减 tools 数组)。
第四步:改用“只追加、不改写”的官方迁移模式:如果因为工具输出过大需要精简,应在首次发送 function_call_output 之前就完成字段过滤,而不是等模型看过了再回头改写历史;如果后续数据发生变化,应在对话末尾追加一条新的更正消息或发起新的工具调用。如果需要在切换 Agent 模式时调整工具权限,应保持已知 tools 定义稳定,改用 tool_choice 中的 allowed_tools 限制调用范围,或在末尾追加 additional_tools 开发者条目。如果需要进行长上下文压缩,应调用 OpenAI 原生压缩端点并基于其返回的新上下文续写,而不要在自行生成文本摘要后继续回传摘要之前的旧推理块。
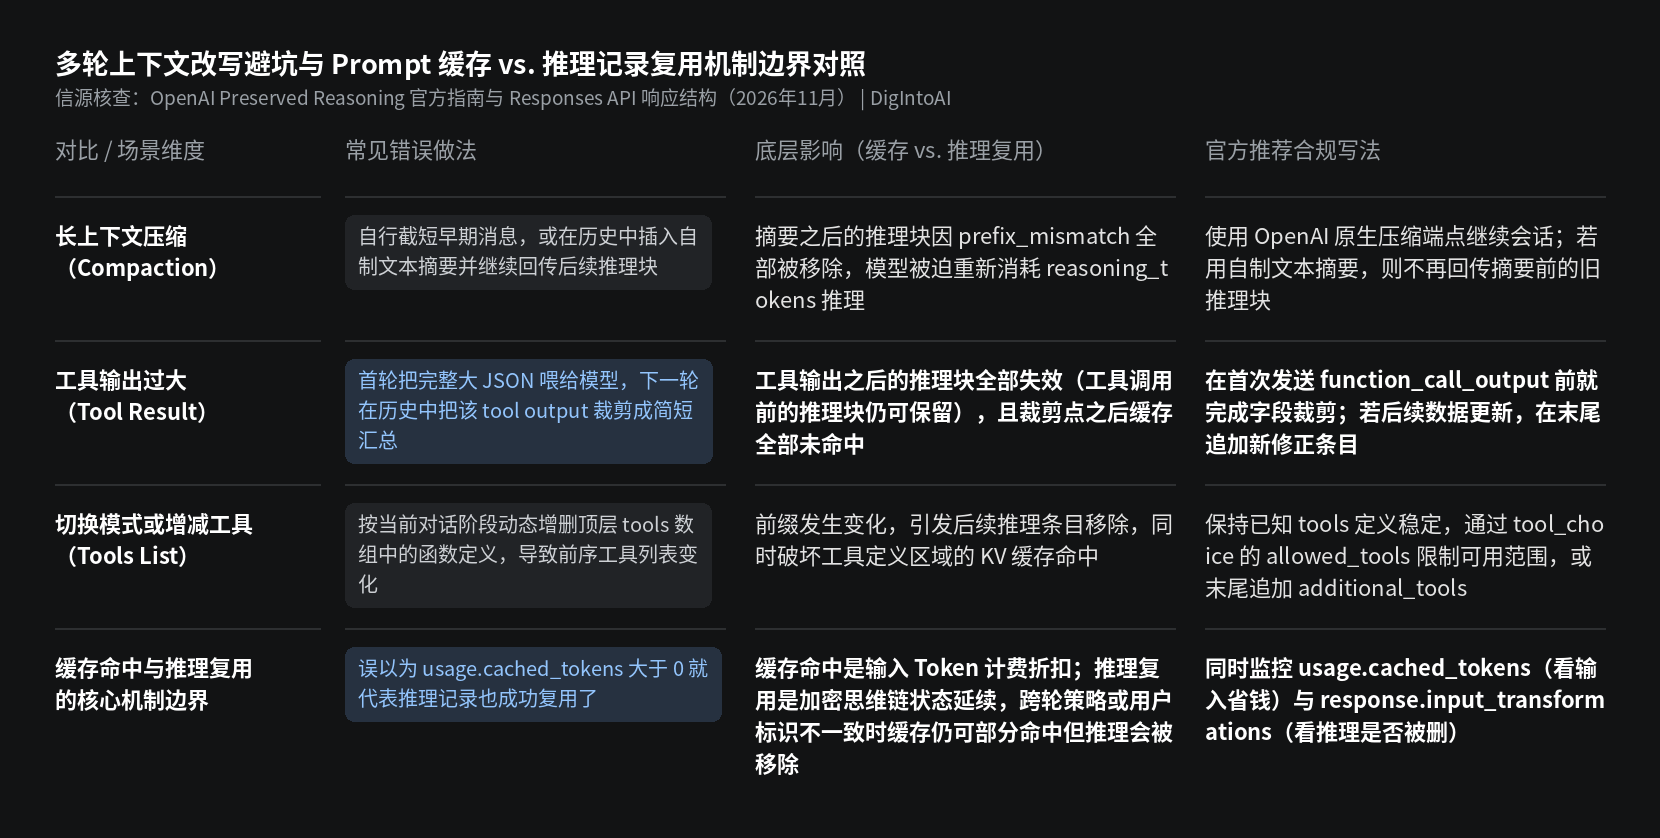
图片来源:DigIntoAI 根据 OpenAI Preserved reasoning 官方指南及 Responses API 响应规范整理制作。
为什么 Prompt 缓存命中不能与推理复用画等号?
不少开发者在优化成本时容易把两套机制混为一谈,误以为只要账单里的 usage.input_tokens_details.cached_tokens 大于 0,就说明历史推理记录也成功复用了。实际上,二者在底层分属完全不同的两道管线:
Prompt 缓存(Prompt Caching)作用于输入 Token 的键值(KV)缓存与计费折扣层,只要请求开头的系统提示词和前几轮对话文本没有变化,服务端就能对重复输入的 Token 给予缓存命中折扣(开发者也可通过响应中的 prompt_cache_diagnostics 字段查看未命中原因)。而保留推理(Preserved Reasoning)作用于加密思维链状态的连续性恢复层,受限于严格的端到端前缀完整性、模型谱系、组织归属、终端用户标识以及 reasoning.context 轮次策略。
这意味着在真实生产环境中完全可能出现“缓存部分命中、但推理全部被移除”的交叉现象:例如,当你在多轮对话中跨过了 turn_boundary 策略限制,或者多租户网关在请求头里意外变更了 end_user_mismatch 对应的用户标识时,前序系统提示词与早期对话文本依然可以命中 Prompt 缓存并享受输入折扣,但 input_transformations 仍会将加密推理条目移除,迫使模型重新耗费大量输出 reasoning_tokens 进行二次推导。因此,上线多轮推理 Agent 时,必须同时监控 usage.cached_tokens(衡量输入计费折扣)与 response.input_transformations(衡量推理状态是否真正存活)。