
本文目录
2026 年 11 月 16 日 10:01(北京时间),通义千问官方账号(Alibaba_Qwen)正式宣布旗舰模型 Qwen4-Max 开放正式调用 ID qwen4-max,现已在 QwenCloud 平台提供按量付费 API 与 Token Plan(Personal / Team)订阅接入,并同步支持在 QwenWork、Qoder 与 QwenStudio 中使用。
开发者需要把本次上线的 qwen4-max 与 2026 年 11 月 11 日发布的限时预览模型 qwen4-max-preview 明确区分:根据 QwenCloud 最新模型文档与 Token Plan 更新页,独立的 qwen4-max-preview 及其预览期规则(2026 年 11 月 11 日 10:00 至 11 月 25 日 24:00 UTC+8)仍然单独保留,且官方博客对本次正式 ID 的状态表述为现已可用(now available)。
全新 Qwen4 架构、官方自测表现与上下文输出上限
在底层模型设计上,Qwen4-Max 采用全新 Qwen4 稀疏混合专家(MoE)架构,拥有 2.4T 骨干参数(每个 Token 激活 71B 参数),并额外配备 328B 参数的 N-gram Embedding 层:
核心架构组件:采用 GDN 与 Qwen Sparse Attention(QSA)混合序列结构(每 3 层 Gated DeltaNet 将历史压缩为固定大小状态,配合轻量级索引器按微块粒度检索上下文)、四分支动态读写门控残差(Gated Residual)以及第二层的上下文 N-gram Embedding 查表机制;官方披露其在 2.4T 规模预训练全程未出现 loss spike。此外,官方博客明确表示 Max 只是 Qwen4 系列的首发型号,同系列较小尺寸模型即将以开源形式发布(目前尚未上线开源仓库)。
官方内部评测与效率数据:在官方自建工作场景框架 Work360(涵盖 26 个一级领域、182 个二级子领域与 721 个三级专业方向)中,Qwen4-Max 取得 52.69 分(高于 Qwen3.8-Max 的 47.74 分,提升约 10%),单任务平均成本从 4.43 美元降至 1.67 美元(降幅 62%),Token 消耗在 Xhigh 与 High 思考档位下分别减少约 24% 与 35%;在 Terminal-Bench 4.0 上,Xhigh 与 High 档位 Token 消耗分别减少约 48% 与 49%。官方博客同时引用了 JobBench(基于更新后数据集 commit d43a66575635da0d3f6cb9a20976dc1a60f3ffc9 与评测代码 commit 660b33a86ed032559df0b2fdc1ad38cf7ceb83f3)、APEX-Agents v1.1、AA-Briefcase v1.1、AutomationBench-AA、CodeArena、AgentArena、HLAB-Vals-1.1、Agents' Last Exam v1.1 以及 ChartoGraphy(在 min_pixels=4096×32×32 设置下评测)的官方对比数据。
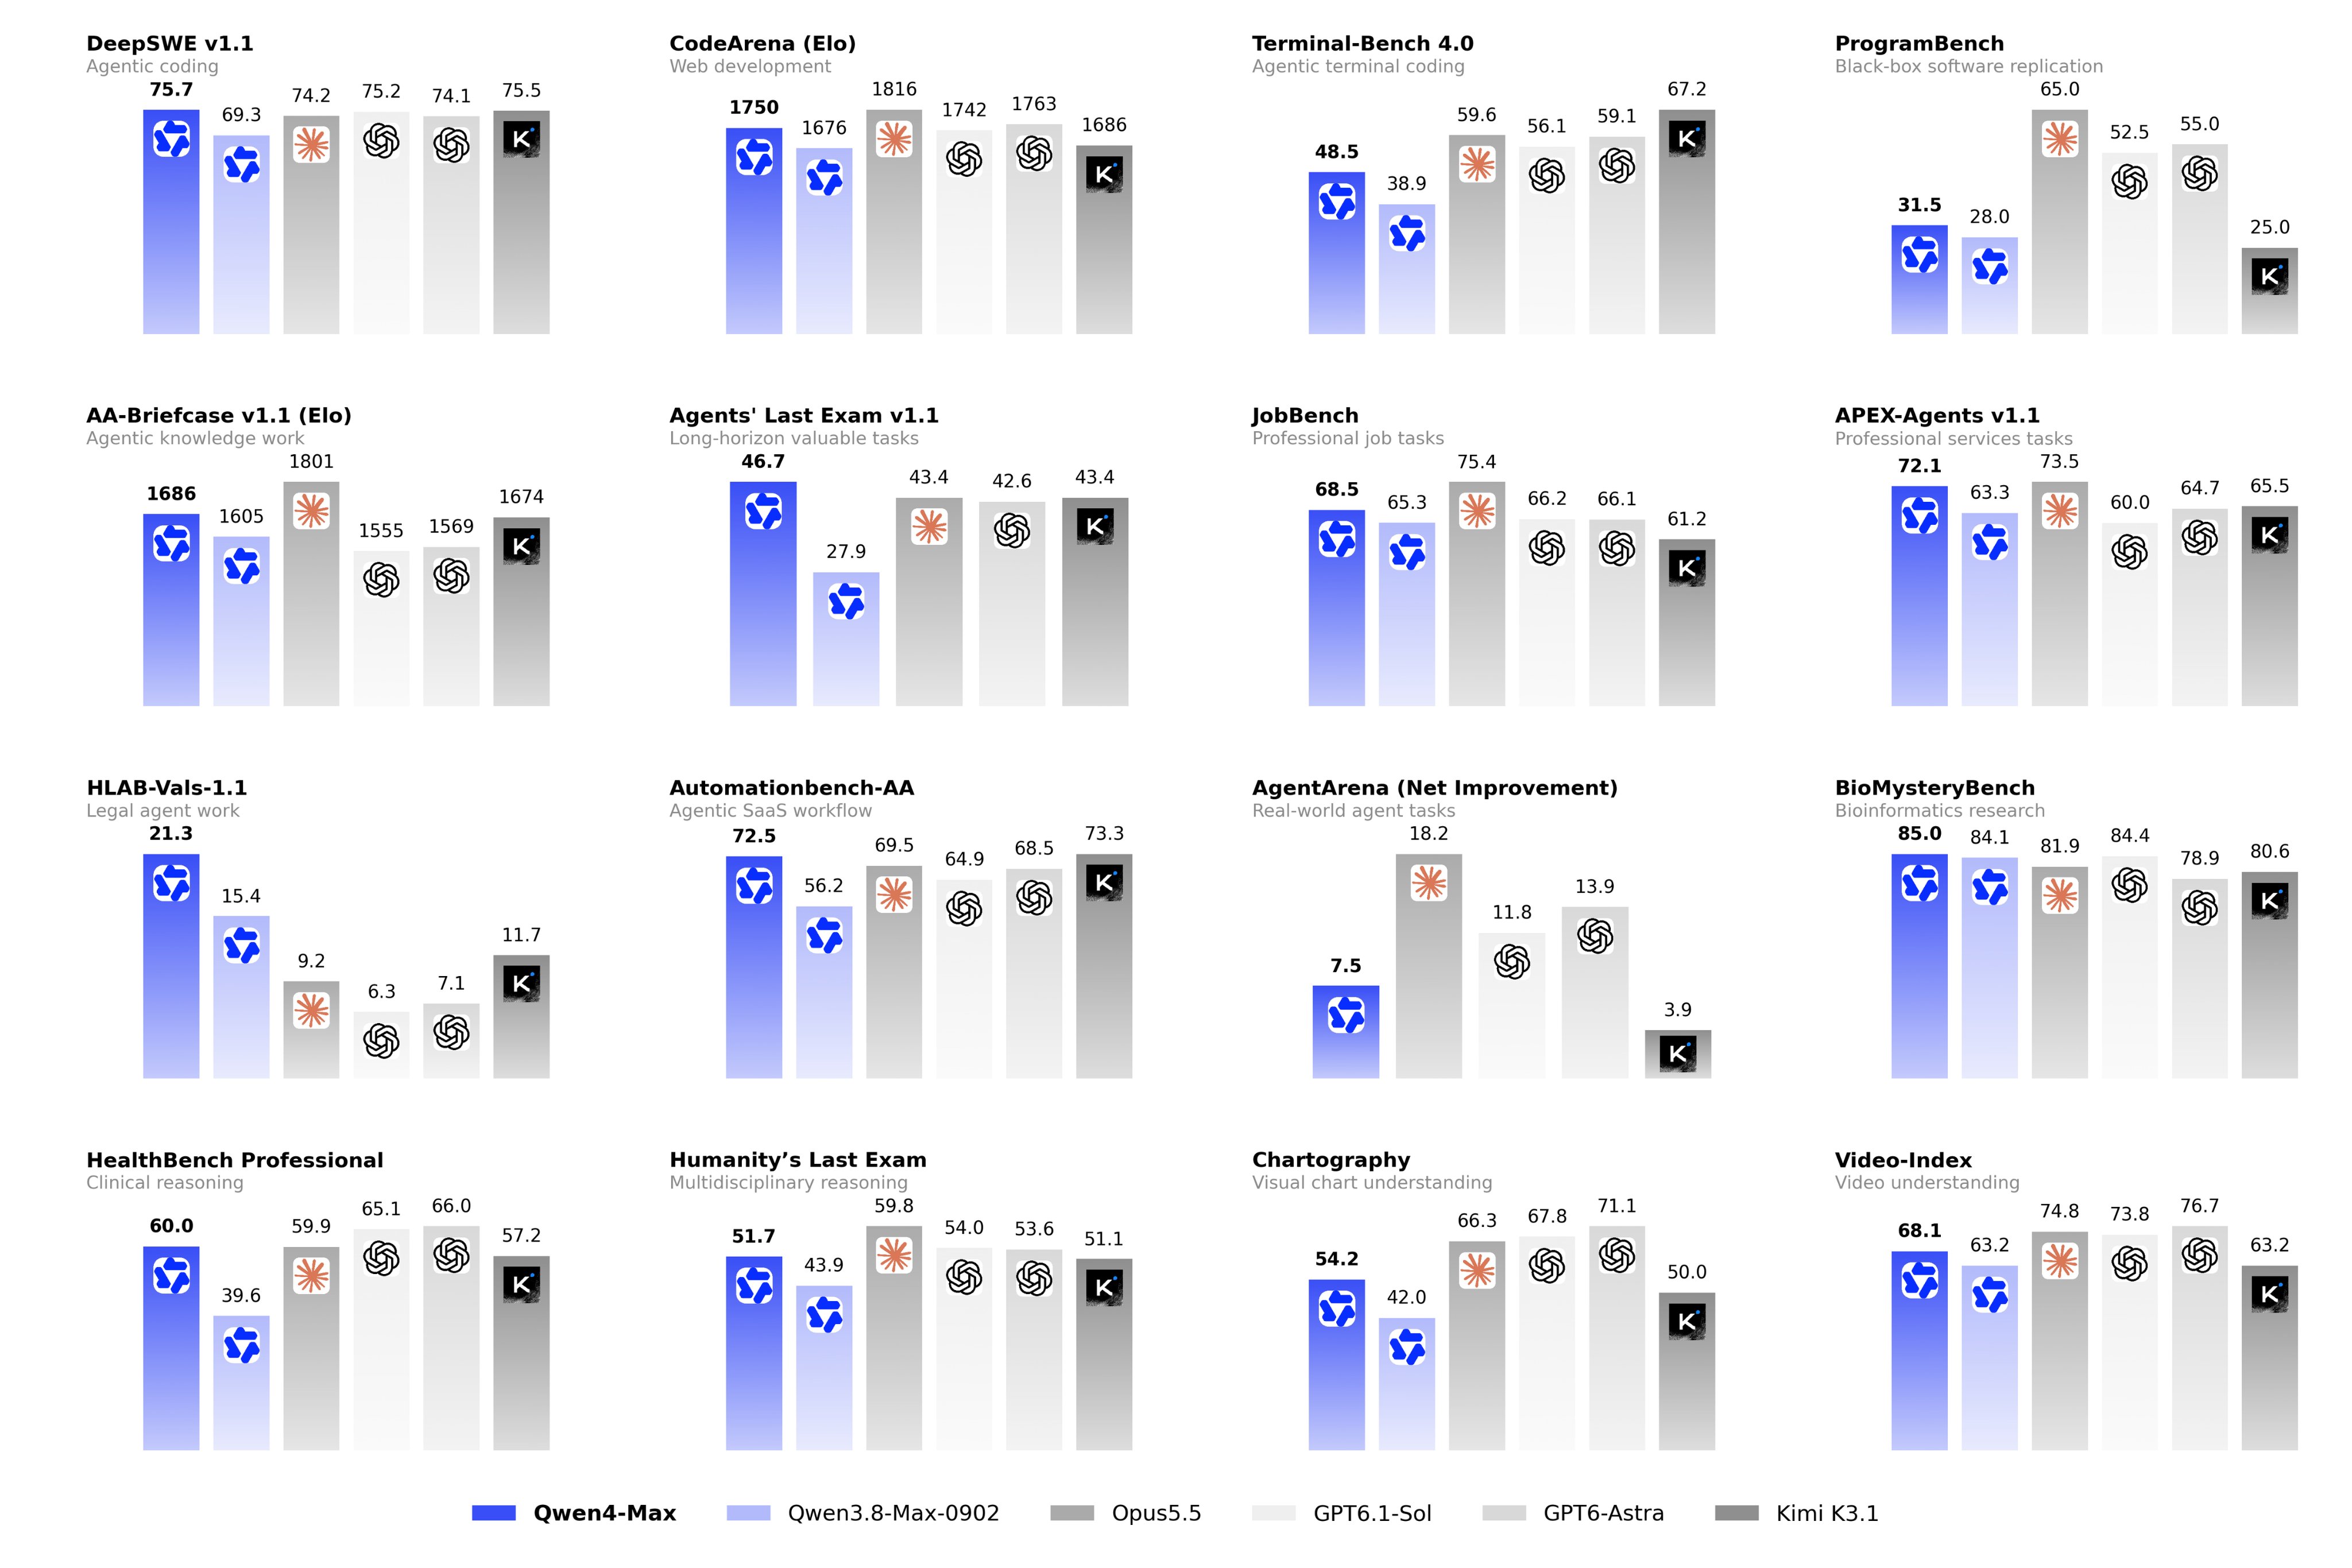
图片来源:通义千问官方博客《Qwen4-Max: Your New Teammate Has Arrived》(官方原图等比例缩小)。官方内部评测,口径见该博文 Footnotes。
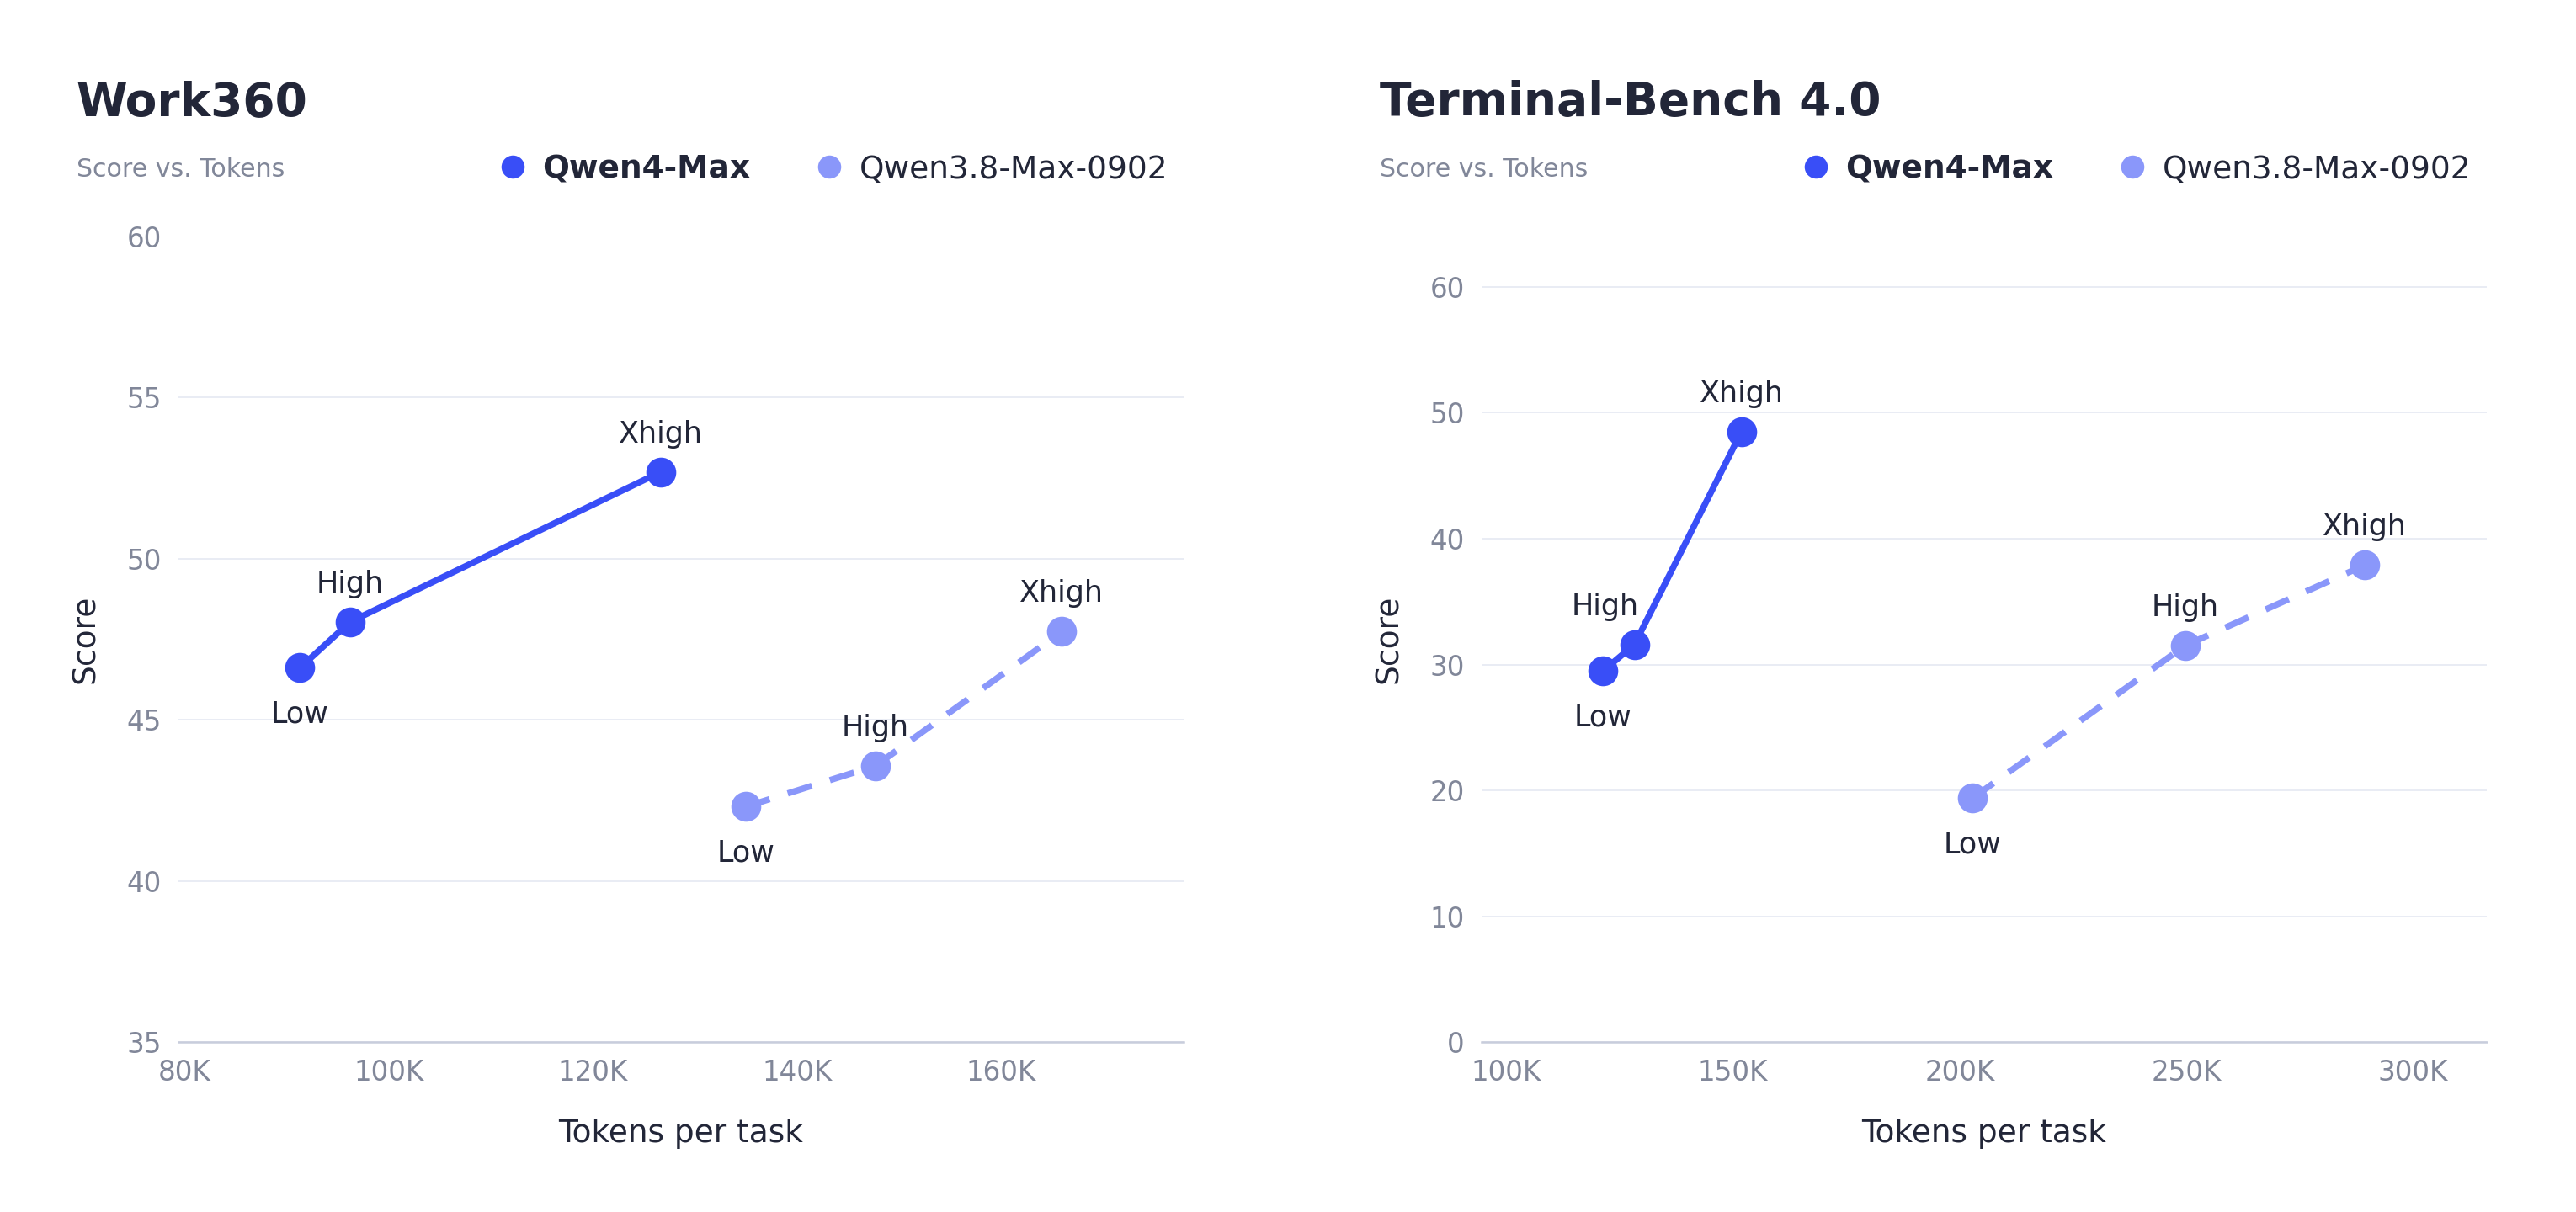
图片来源:通义千问官方博客《Qwen4-Max: Your New Teammate Has Arrived》。官方内部评测,口径见该博文 Footnotes。
上下文与输出 Token 上限(需留意两处官方口径差异):QwenCloud 最新开发者文档与中国站帮助页均列出:上下文长度 1,000,000 tokens,非思考模式最大输出 131,072 tokens(最大输入 991,808 tokens),思考模式下思考过程与最终回答共享最大 262,144 tokens(默认思考预算 131,072 tokens,最大输入 983,616 tokens)。模型默认开启思考(默认强度 high,支持 low / high / xhigh 三档)并默认开启 preserve_thinking。需要提醒的是,QwenCloud 网页端产品详情页目前仍显示最大输出为 393K(思考与非思考均为 393K,最大推理 262K),两处页面尚未完全统一,实际接入建议以开发者文档的 131,072 / 262,144 上限为准进行预算规划。
支持功能与不支持项:支持文本、图像与视频输入及文本输出,支持函数调用、结构化输出、网页搜索、PDF 理解、MCP、显式与隐式缓存以及需开启思考的代码解释器,兼容 OpenAI Chat Completions、Responses、Anthropic Messages 与 DashScope 接口(纯文本输入亦走 DashScope 多模态端点)。根据最新模型文档能力表,当前不支持微调(Fine-tuning)、模型部署(Model deployment)与批量推理(Batch inference,注:价格页仍有通用批量半价说明,模型级支持状态以最新模型文档为准)。
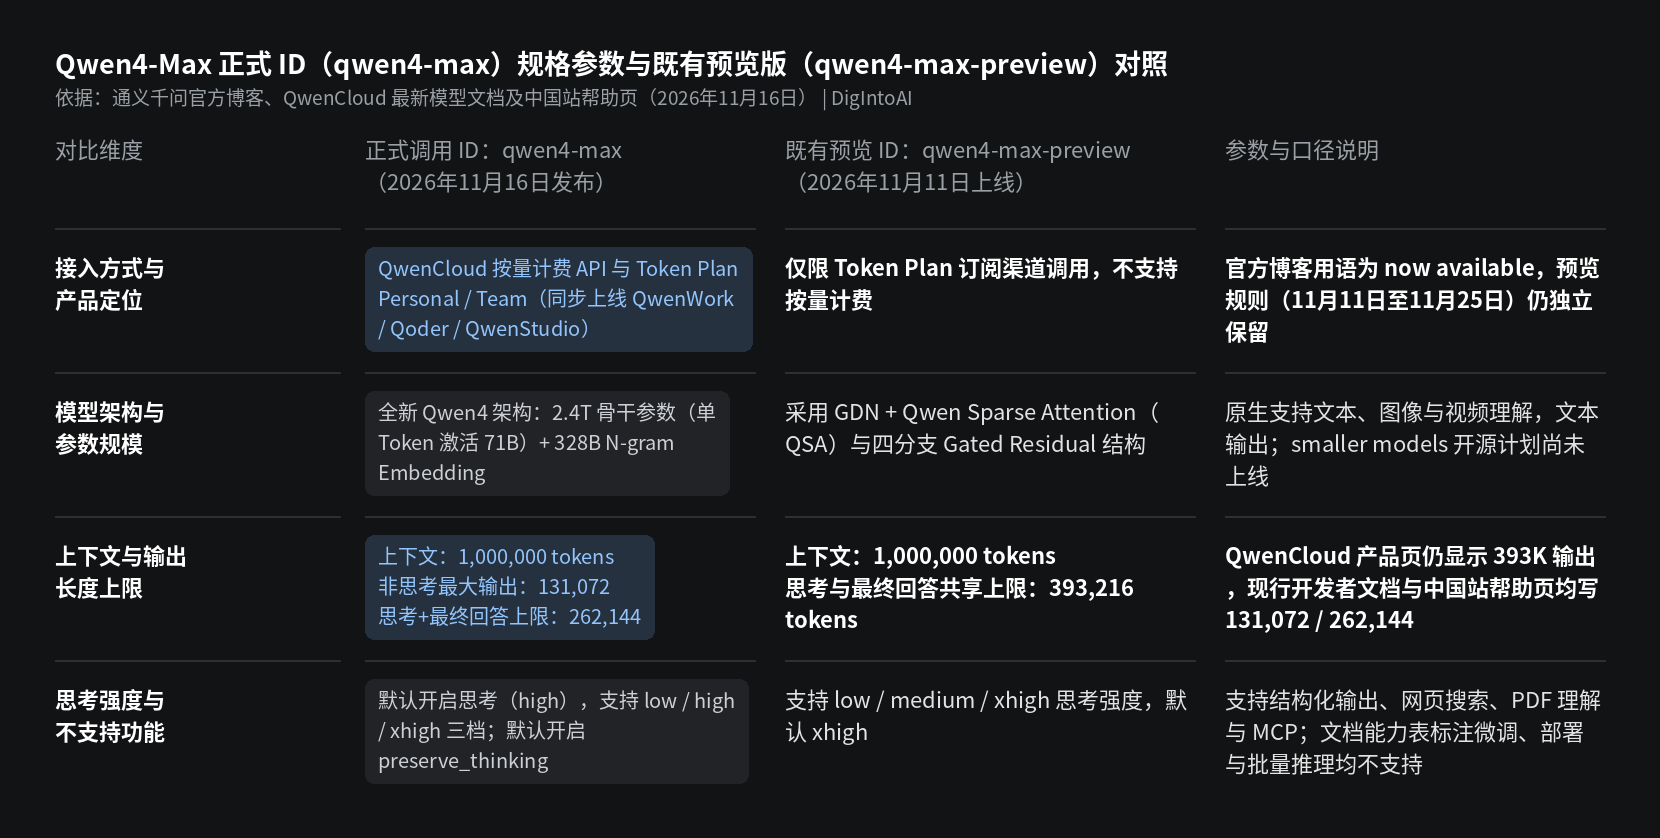
图片来源:DigIntoAI 根据通义千问官方博客、QwenCloud 最新模型文档及中国站帮助页整理制作。
分区美元定价、免费额度资格与第三方渠道上架
QwenCloud 全区域均以美元(USD)计价,思考与非思考模式同价,且不按输入长度分段加价,但不同部署区域单价略有差异:
新加坡(International)区域定价与 100 万免费额度:输入 $1.50 / 百万 tokens,输出(含思考过程与最终回答)$4.50 / 百万 tokens,显式与隐式缓存读取 $0.075 / 百万 tokens,5 分钟缓存写入 $1.875 / 百万 tokens,1 小时缓存写入 $3.00 / 百万 tokens。根据 QwenCloud 新模型免费额度通用规则,新加坡区域新老用户可享受该模型 100 万 tokens 免费实时调用额度(自模型发布日起 90 天内有效,需使用新加坡区域 API Key 并请求新加坡端点,不抵扣联网搜索等内置工具费;其他区域无免费额度)。
北京(China North 2)与 Global 区域定价:中国北京区域以及 Global 节点(法兰克福、香港、东京、美国弗吉尼亚)执行统一美元定价:输入 $1.413 / 百万 tokens,输出 $4.24 / 百万 tokens,缓存读取 $0.071 / 百万 tokens,5 分钟缓存写入 $1.767 / 百万 tokens,1 小时缓存写入 $2.827 / 百万 tokens。
OpenRouter 正式上架(qwen/qwen4-max):OpenRouter 已在 2026 年 11 月 16 日上架唯一供应商(Alibaba)的正式端点 qwen/qwen4-max,支持文本、图像与视频输入及 1M 上下文,最大输出 131,072 tokens。OpenRouter 现网标价为每百万 tokens 输入 $1.425、输出 $4.275、缓存读取 $0.07125,5 分钟缓存写入 $1.78125,1 小时缓存写入 $3.00;该价与上文 QwenCloud 新加坡官方标准价分别记录。支持 xhigh / high / low / none 思考强度调节。
OpenCode Go 纳入编程代理套餐:OpenCode 官方于 11 月 16 日宣布 Qwen4 Max(配置 ID 为 opencode-go/qwen4-max)正式加入 OpenCode Go 订阅模型名单(覆盖 Go $10/月、Go Plus $40/月与 Go Teams $20/人/月三档套餐)。其 Token 折算单价与官方新加坡标准价相同($1.50 / $4.50 / $0.075),从对应套餐月度美元额度池中按规则扣减(5 小时上限为月度额度的 20%、周上限 50%),且配置为零数据留存(0 days)且不用于模型训练。
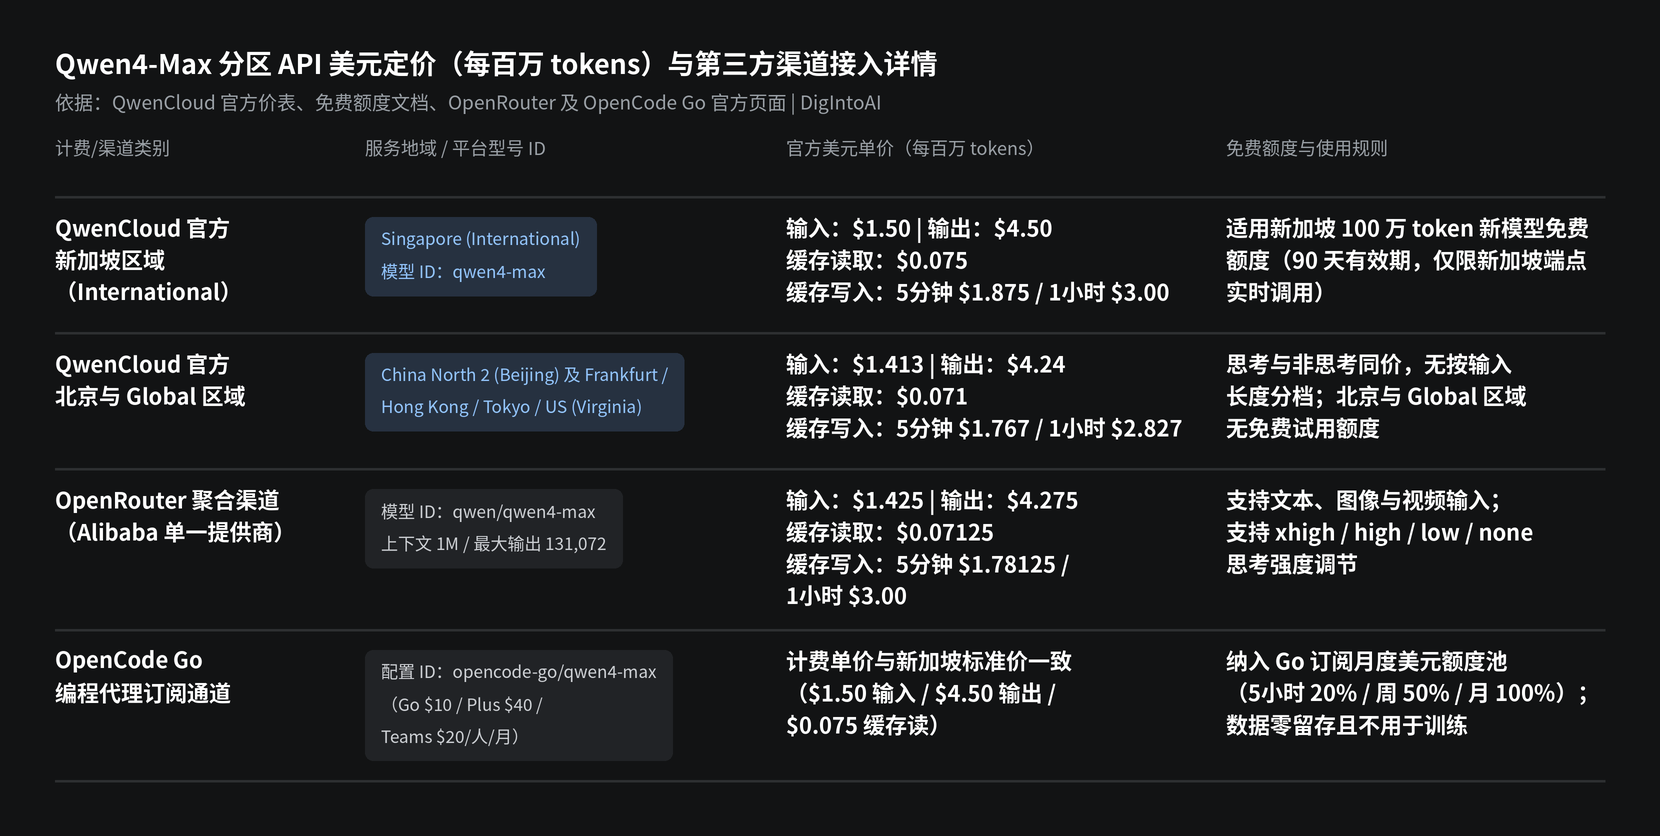
图片来源:DigIntoAI 根据 QwenCloud 官方价表、OpenRouter 及 OpenCode Go 文档整理制作。
Novita AI 上架(qwen/qwen4-max)
2026 年 11 月 16 日,通义千问官方账号 @Alibaba_Qwen 引用 Novita AI,确认 Qwen4-Max 已在 Novita「上线首日」可调用。Novita 官方博客 同日 17:30(亚洲/上海)发布。调用 ID 为 qwen/qwen4-max,与上文 OpenRouter 所用字符串相同;QwenCloud 官方 ID 为 qwen4-max。模型页 提供 OpenAI 兼容与 Anthropic 兼容接口。
Novita 平台价为每百万 tokens 输入 $1.413、输出 $4.24、缓存读取 $0.071,缓存写入 5 分钟 $1.767、1 小时 $2.827。这些数字与上文已列的 QwenCloud 北京及 Global 区域单价相同,按 Novita 平台价计费。上下文在 Novita 模型页展示为 977K,标称 1,000,000 tokens。
最大输出方面,Novita 博客 写最大输出 393,000 tokens,并称其模型页展示 384K;当前 模型页 展示 128K,公开模型目录与页内示例为 131,000 tokens。
第三方社区盲测与补充边界
第三方榜单表现(仅作社区参考):在 2026 年 11 月 16 日通义千问官方转发的第三方社区评测动态中,DesignArena 公布 Qwen4-Max 在 Python-PPTX 与 Spreadsheet 类别位列第一;LM Arena 公布其在 Agent Arena 位列开源模型第一,并在 Image-to-WebDev Arena(preliminary 初步榜单)与 Code Arena WebDev(preliminary 初步榜单)中位列开源第一(总榜均位列第二)。上述 Arena 榜单中的 WebDev 成绩均带有 preliminary 初步评测标记,与官方内部基准分属不同评估体系。
开源权重时间边界:截至 2026 年 11 月 16 日,Qwen4 系列尚未发布开源权重,官方博客提及同系列较小尺寸模型的开源计划将于后续推出。
