
2026 年 11 月 20 日,Thinking Machines Lab 正式发布并开源新一代端侧多模态模型 Inkling 2 Mini(Apache 2.0 协议,同步登陆 Hugging Face 与自家微调推理平台 Tinker)。区别于常规单向堆叠层数的开源小模型,Inkling 2 Mini 引入了循环 Transformer(Looped Transformer)与原生混合低比特训练路线,以约 20 GB 的单文件体积支持 1M(1,024K)上下文与文本、图像双模态输入,让开发者能够在断网的消费级笔记本或单台桌面 AI 主机上运行长程编程与多智能体任务。
24 层权重跑出 48 层深度:循环 MoE 与原生 NVFP4 零损部署
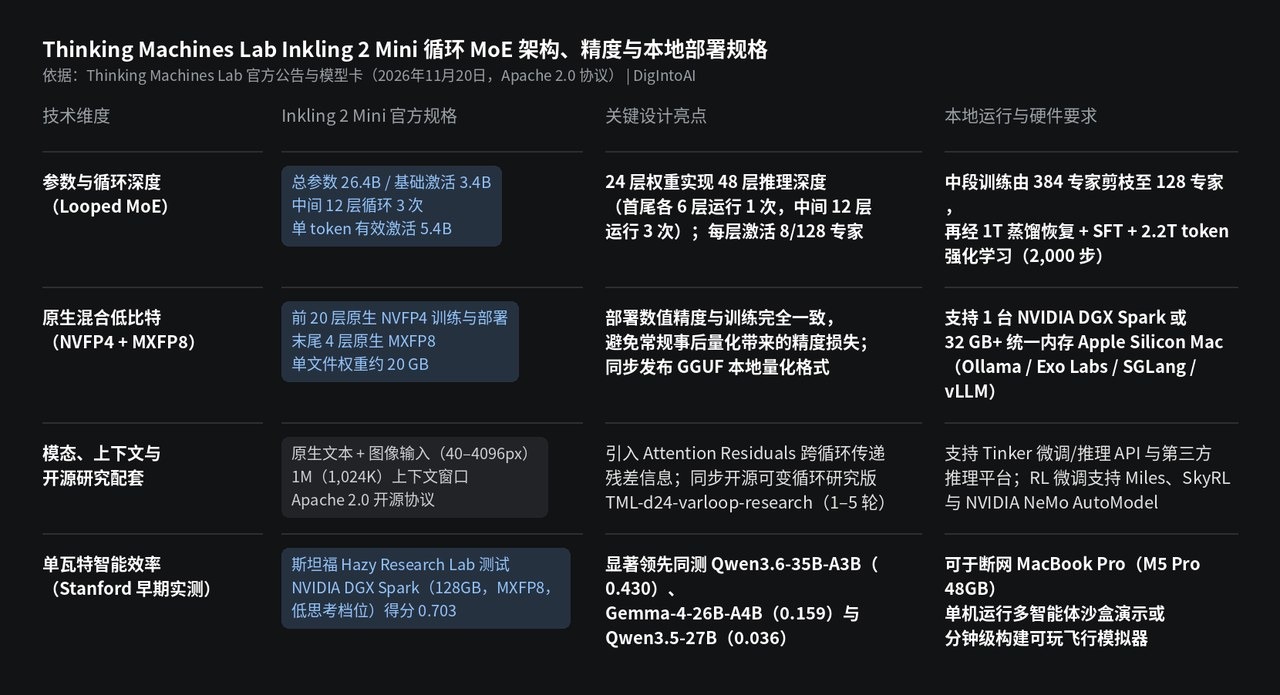
中段 12 层共享权重循环三次,配合专家剪枝与注意力残差:根据官方模型卡,Inkling 2 Mini 采用 24 层解码器稀疏 MoE 架构,划分为四个 6 层区块:首尾两个区块各运行一次,中间 12 层(第 7 至 18 层)共享权重连续运行三次,使每个 token 在不增加磁盘权重的前提下获得 48 层计算深度。模型总参数量为 26.4B,单次前向基础激活 3.4B,每增加一轮循环额外带来约 1.0B 有效计算激活,因此三轮循环下的单 token 有效激活参数为 5.4B(每层从 128 个专家中路由激活 8 个)。训练配方上,团队先在 384 个专家稀疏度下启动训练,中段一次性剪枝掉三分之二专家保留最高频的 128 个,再通过 1T tokens 内部大模型蒸馏恢复性能,并叠加 SFT 与总计 2.2T tokens(2,000 步)的强化学习;同时借鉴 Attention Residuals 机制并引入可学习门控,稳定地将上一轮循环输出传递至下一轮。
原生 NVFP4 + MXFP8 零转换损失,32 GB 内存 Mac 离线可跑:数值精度方面,Inkling 2 Mini 在从预训练到强化学习的全流程前向计算中,前 20 层专家层原生采用 4-bit NVFP4(依托 NVIDIA GB300 硬件加速),末尾 4 层采用 8-bit MXFP8,最终以完全相同的混合精度发布约 20 GB 的单个检查点文件,消除了传统事后量化带来的精度跌落。官方支持在单台 NVIDIA DGX Spark、配备 32 GB 及以上统一内存的 Apple Silicon Mac(可通过 Ollama 与 Exo Labs 运行)或 32 GB+ 显存显卡(支持 SGLang、vLLM、Unsloth 及 llama.cpp GGUF)上本地推理。在斯坦福 Hazy Research Lab 与 Scaling Intelligence Lab 的早期能效测试中,Inkling 2 Mini 在 128 GB DGX Spark(MXFP8、低思考档位)上取得 0.703 的单瓦特智能分(Intelligence per Watt),大幅高于同测的 Qwen3.6-35B-A3B(0.430)、Gemma-4-26B-A4B(0.159)与 Qwen3.5-27B(0.036)。
图片来源:DigIntoAI 根据 Thinking Machines Lab 官方公告与模型卡整理制作。
百亿级以下编码领跑、循环可监控性实验与坦承短板
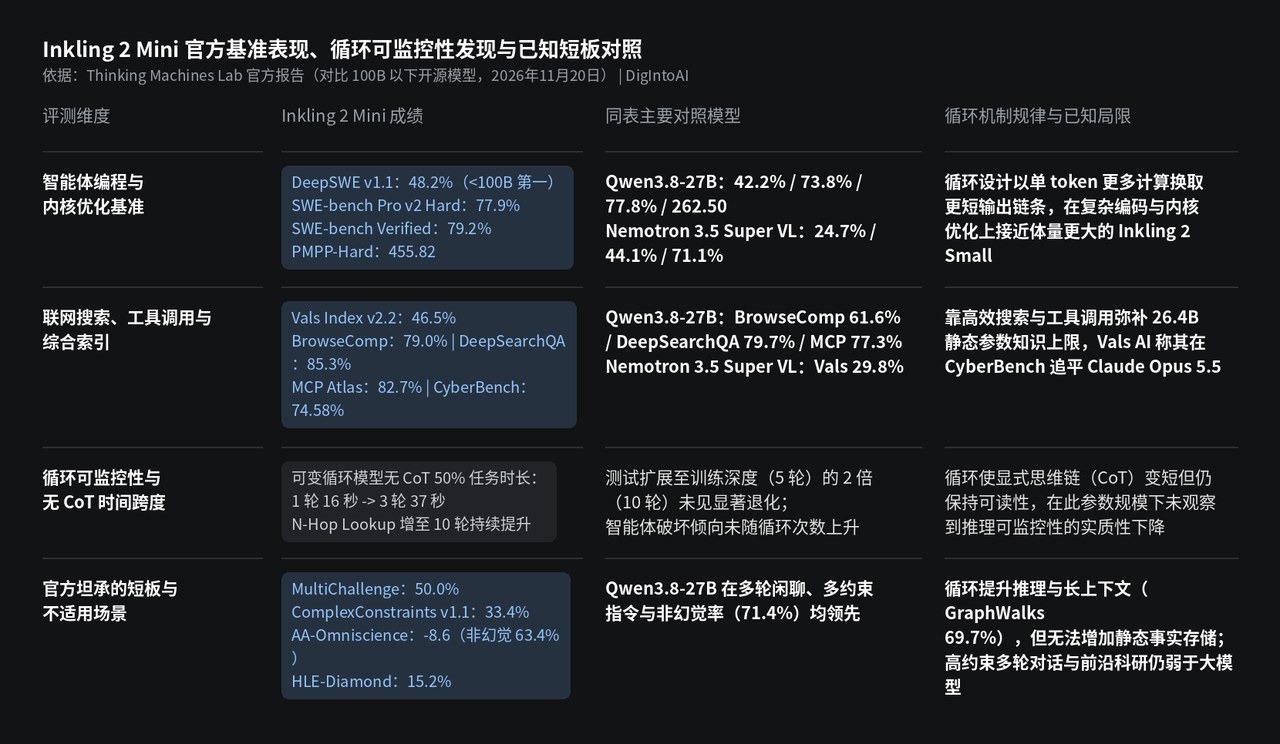
编程与工具检索领跑同尺寸开源,弥补静态知识上限:在官方披露的 100B 以下开源模型横向对比中,Inkling 2 Mini 在 DeepSWE v1.1(48.2%)、Vals Index v2.2(46.5%)、SWE-bench Pro v2 Hard(77.9%)、SWE-bench Verified(79.2%)以及 GPU 内核优化基准 PMPP-Hard(455.82)上均居前列;在依赖联网搜索与工具调用的 BrowseComp(79.0%)、DeepSearchQA(85.3%)与 MCP Atlas(82.7%)上同样领先同体量模型(第三方评测平台 Vals AI 亦指出其在 CyberBench 取得 74.58%)。官方在文中明确解释了循环的边界:增加循环次数能显著提升复杂推理与长上下文定位(GraphWalks BFS 256K 达 69.7%、MRCR v2 达 46.4%),但无法突破 26.4B 总参数量的静态事实记忆上限,因此需结合搜索与工具调用发挥实战优势。
同步开源可变循环研究模型与明确的能力短板:针对学界担忧「循环层在不写明思维链(CoT)的情况下完成内部推理会降低安全可监控性」,Thinking Machines Lab 同步在 Hugging Face 开源了支持 1 至 5 轮可变循环的研究权重 TML-d24-varloop-research。实验显示,该研究模型的无 CoT 50% 任务时长跨度从 1 轮循环的 16 秒提升至 3 轮的 37 秒,在串行推理任务 N-Hop Lookup 中扩展至 10 轮循环(训练最大深度的两倍)仍持续提升;随着循环增加,模型显式写出的 CoT 变短但仍保持可读,且内部智能体破坏测试未呈上升趋势。与此同时,官方也坦承了 Inkling 2 Mini 的明显短板:其在多轮对话(MultiChallenge 50.0%)、多约束复杂指令(ComplexConstraints v1.1 33.4%)以及非幻觉率(AA-Omniscience 63.4%)上均落后于 Qwen3.8-27B,在 HLE-Diamond(15.2%)与 CritPt v2 等重度前沿推理题上也仍与大参数旗舰存在差距。
图片来源:DigIntoAI 根据 Thinking Machines Lab 报告及 Vals AI 公开数据整理制作。