
本文目录
人工智能研究机构 Zyphra 近期在 Hugging Face 与 GitHub 同步公开了新一代多语言文本转语音(TTS)模型 ZONOS3-Mini。需要提前说明的是,其 Hugging Face 技术文章页面顶部标注的发布日期为 2026 年 11 月 12 日,而正文作者栏署期为 11 月 11 日,官方主页与代码提交记录亦跨越 11 月 9 日至 12 日;在官方进一步统一口径前,本文暂不将其中任一日期作为确定的首次上线时间,仅以当前公开的权重与代码仓库状态为准。
在授权协议方面,ZONOS3-Mini 采用了对商业集成较为友好的双许可拆分布局:模型权重(包含完整的 bf16 PyTorch 检查点与量化后的 GGUF 文件)以 Apache 2.0 协议发布,而配套的推理服务端、浏览器 WebGPU 构建脚本以及前端工作室界面(Zonos Voice Studio)则以 MIT 协议在 GitHub 开源。对于希望在私有环境或客户端侧集成本地语音合成的开发者而言,无需向模型方支付按字符或按分钟计费的授权费用。
模型架构与 43 种语言支持范围
上一代 Zonos 模型采用 8B 参数骨干网络配合 86 Hz 帧率音频编解码器,在浏览器与轻薄笔记本上部署门槛较高。ZONOS3-Mini 通过重新设计音频编解码器与序列混合层,将模型压缩至边缘设备可实时运行的体量:
100M 激活参数的稀疏混合专家骨干:模型主体由 11 层网络构成(隐藏维度 1,024),总参数量为 800M,其中前馈层采用包含 64 个专家、每次路由激活前 2 个专家的 Latent MoE 结构,使单个 Token 的实际计算激活参数控制在约 100M。序列混合采用 3 比 1 的混合比例,由 9 层 Gated DeltaNet 循环层与 2 层全局分组查询注意力(GQA)层交替组成,支持最长 32,768 位置的上下文窗口,单次连续生成最长可达 10 分钟音频。
15 Hz 双编码器 ZAC-1 与 44.1 kHz 输出:Zyphra 同步开源了专用音频编解码器 Zyphra Audio Codec 1(ZAC-1)。它将 44.1 kHz 采样率音频压缩为每秒仅 15 帧(15 Hz)的离散编码,每帧包含 10 个码本(第 0 号码本蒸馏自 Wav2Vec2-BERT 2.0 的语义特征,其余 9 个码本为声学残差向量量化)。解码端采用因果多分辨率逆短时傅里叶变换(iSTFT)头,支持标准模式(full-mr)与精简模式(keep2-plain,官方称解码速度可再提升约 3 倍),每生成一帧即可流式输出音频波形。
43 种支持语言与音色控制机制:模型卡列出的 43 种语言覆盖东亚、东南亚、南亚、欧洲及中东地区,明确包含简体中文(Mandarin Chinese)、英文(English)与日文(Japanese)。其中文本前端内置了基于 Rust 移植的 NeMo 文本正则化模块(zyphra-textnorm),专门针对中文、英文、日文、韩文及五种欧洲主要语言的数字、日期与符号读法做了规则处理(其余语言按原文直通送入 8,192 词表的 SuperBPE 分词器)。音色方面支持上传 5 至 60 秒参考音频进行零样本克隆,也可加载 192 维 MECT-B2 说话人向量调节年龄感、音色明亮度、语速、响度与情绪倾向。
如何在浏览器与本地设备上部署运行?
根据 GitHub 仓库的运行说明,所有本地与服务端后端均共享同一套 HTTP 接口协议(兼容 OpenAI 的 /v1/audio/speech 端点以及原生的 /v2/generate 端点)和同一套 Zonos Voice Studio 网页交互界面。开发者可以根据目标硬件选择以下四条运行路径:
路径一:浏览器 WebGPU 零安装纯前端运行(servers/web):这是门槛最低的体验与端侧集成方式。借助 WebGPU 与 Web Worker 技术,ZONOS3-Mini 可以直接在用户的 Chrome、Edge 或 Safari 浏览器内调用本地显卡完成推理,整个过程不需要安装 Python 环境,也不需要搭建后端推理服务器。用户打开官方提供的 WebGPU 交互页面(或本地构建后在地址后附加 ?api=web 参数)时,浏览器会在首次访问时自动下载并缓存分片权重,后续再次打开即可离线调用。
路径二:Apple Silicon Mac 原生 MLX 服务(servers/mlx):针对搭载 M1、M2、M3 或更新芯片的 Mac 设备,仓库提供了基于苹果 MLX 框架的原生服务端。配置好 Python 3.12(通过 uv 管理依赖)与 Rust 编译工具链(用于编译文本正则化组件)后,只需从 Hugging Face 拉取 gguf 目录下的量化权重文件并执行启动脚本,即可在本地 127.0.0.1:1919 端口启动带可视化界面的语音服务。Zyphra 在技术报告中披露,该模型在 M3 MacBook Air 上的首包音频延迟(TTFA)低于 150 ms,在 Pixel 9 手机浏览器上的 WebGPU 首包延迟低于 570 ms。
路径三:跨平台 C++ 与 ggml 独立命令行/服务(servers/ggml):对于 Windows 笔记本、无独立显卡的 Linux 主机,或者不希望在生产环境中引入 Python 依赖的桌面软件,可以直接编译仓库内置的 C++ / ggml 后端。它支持 CPU、CUDA、Metal 与 Vulkan 多种硬件加速,直接加载 GGUF 权重与内置的 27 种多语言默认音色文件即可运行。
路径四:NVIDIA 显卡高并发服务端与离线 Python 接口(servers/sgl):在配备 NVIDIA 显卡(如 A100 或 H100)及 CUDA 12.8 工具链的 Linux 服务器上,可通过集成的 Mini-SGLang 后端(或直接安装 SGLang-Omni)启动高并发服务,首次运行会自动下载约 9 GB 的完整 PyTorch 权重。官方给出的测试数据显示,在单张 H100 80GB 显卡、8 路并发请求下,其中位首包延迟为 80 ms,峰值吞吐达到实时播放速度的 457 倍。
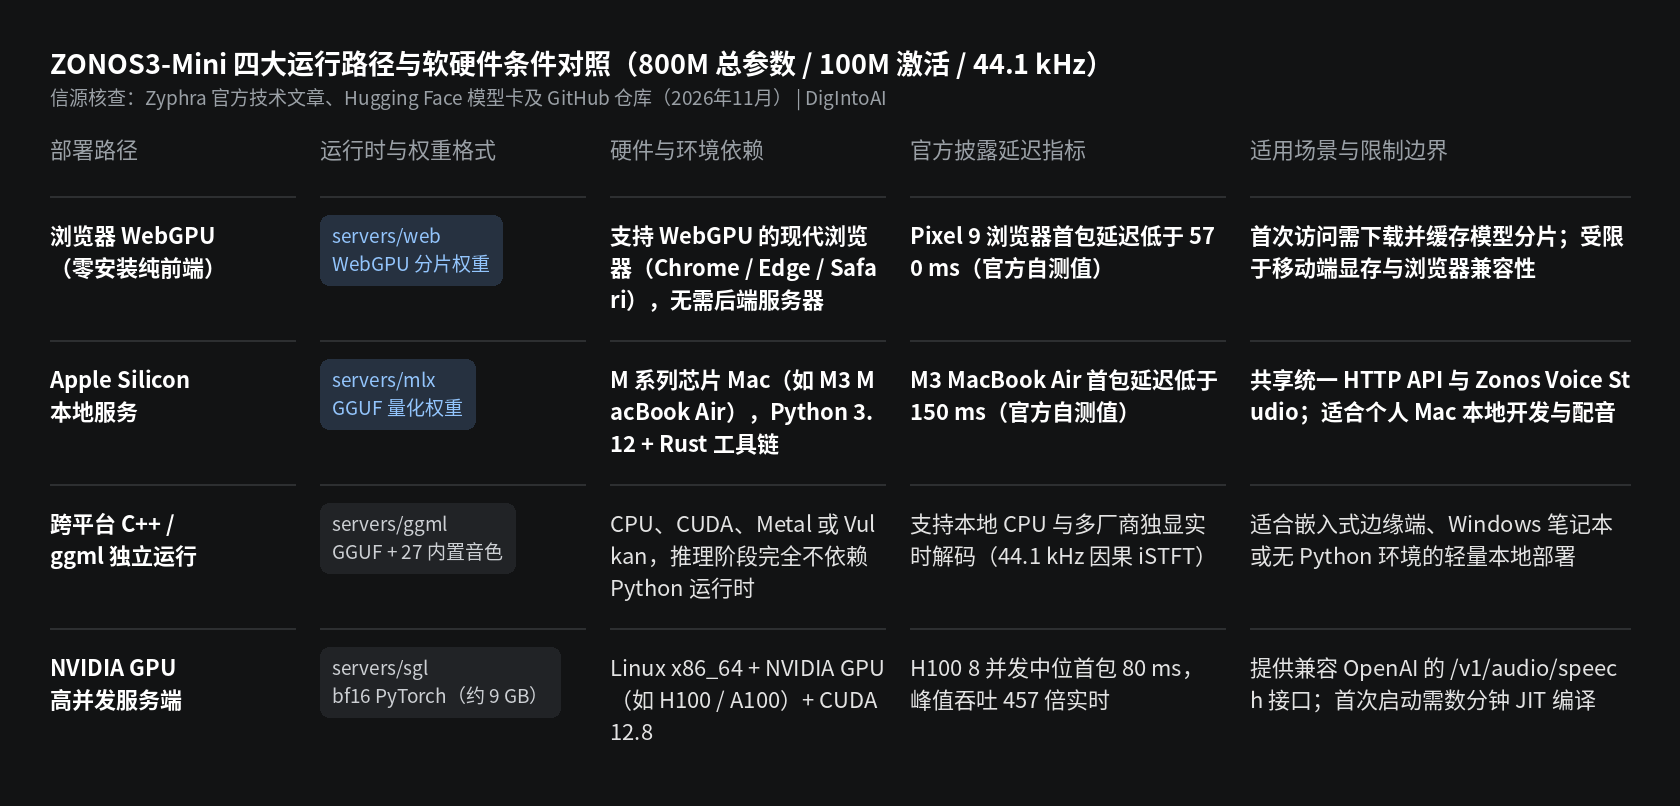
图片来源:DigIntoAI 根据 Zyphra 技术文章、Hugging Face 模型卡及 GitHub 仓库说明整理制作。
与云端语音 API 的成本及工程边界对比
在决定采用 ZONOS3-Mini 自建还是直接调用商业云端语音接口时,中、英、日开发者可以从三笔账来衡量差异:
边际调用费用与基础设施账本:商业云端服务通常按字符或生成时长计费。以 2026 年 11 月公开的 API 价格为例,OpenAI 的 tts-1 标价为每百万字符 15 美元,高清版 tts-1-hd 为每百万字符 30 美元,gpt-4o-mini-tts 折合每分钟音频约 0.015 美元;ElevenLabs 的 Flash v2.5 与 v4 Turbo 接口为每千字符 0.04 美元(即每百万字符 40 美元),标准多语言模型 Eleven v4 为每千字符 0.08 美元(每百万字符 80 美元)。相比之下,ZONOS3-Mini 的权重与代码完全免费商用——如果采用浏览器 WebGPU 模式,推理算力全部由终端用户的本地显卡承担,开发者服务端几乎只需要支付静态模型分片的 CDN 分发流量费用;如果部署在自有 GPU 服务器上,则转化为固定的显卡折旧或云主机租金,在有声书批量制作、游戏 NPC 实时对话或高频语音助手场景下,一旦日均生成量跨越固定算力成本线,单分钟边际成本将显著低于云端按量计费。
数据隐私与离线可用性:调用云端语音接口必须将合成文本与参考人声样本上传至第三方服务器;而通过 WebGPU 或本地 ggml / MLX 部署时,所有文本输入与参考音频均留在本地设备或企业内网中,不仅满足金融、医疗等行业的敏感数据隔离要求,也能在断网或弱网环境下稳定工作。
声线克隆自由度与附加组件边界:主流标准云端接口(如 OpenAI TTS)通常仅提供 9 至 13 种固定预设音色,不支持通过常规接口传入任意参考音频做零样本克隆;商业克隆接口则往往按订阅套餐限制可保存的音色槽位数量。ZONOS3-Mini 在基础模型中直接内置了参考音频克隆与词级韵律控制,但需要留意的是,其进阶的“语音局部编辑(Speech Editing)”与“音素级发音指定”功能并非开箱即用,而是需要额外加载独立的编辑 LoRA 权重、强制对齐模型 FuseAlign(检查点约 1.34 GB)以及语音识别模型 Qwen3-ASR-1.7B。
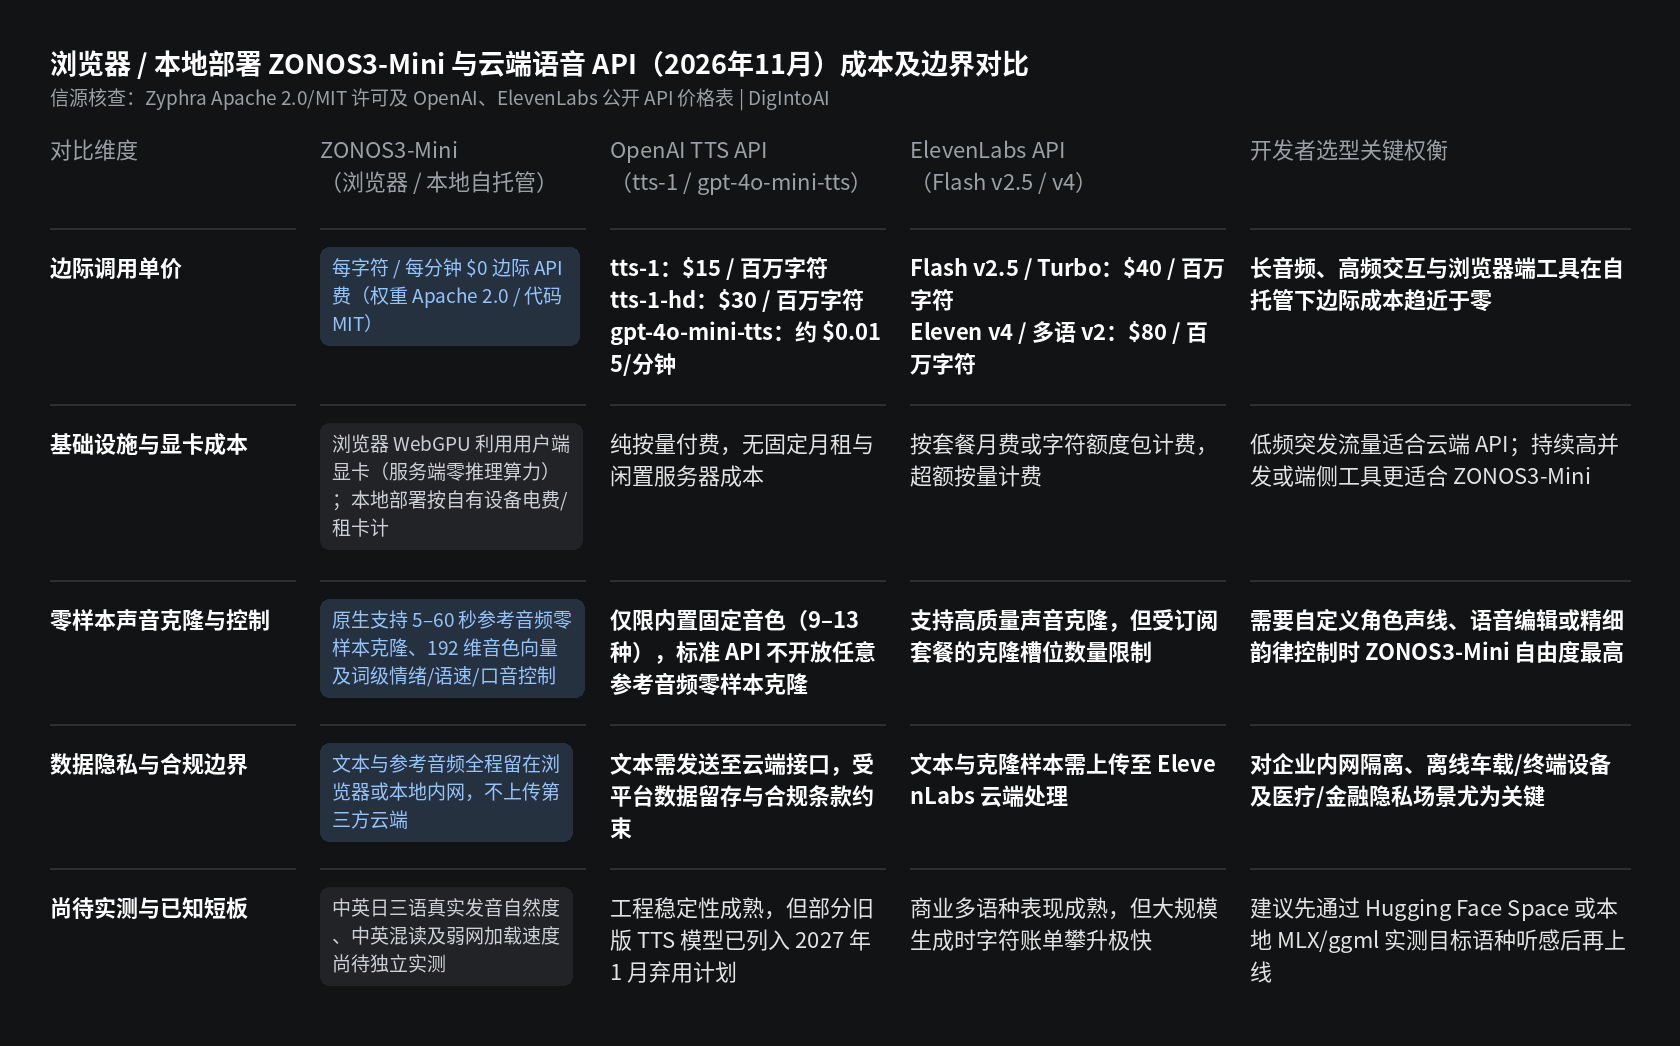
图片来源:DigIntoAI 根据 Zyphra 开源许可条款及 OpenAI、ElevenLabs 公开 API 定价整理制作。
排除说明与待实测项
为了避免在技术选型时产生误判,以下三点边界需要明确区分:
并非通用对话大模型:ZONOS3-Mini 是专注于文本转语音与声音克隆的专用音频生成模型,虽然内部采用了混合专家语言模型骨干来预测音频离散码本,但它不能作为通用聊天机器人回答开放式文本问题。
浏览器端存在首屏下载与显存门槛:零安装并不等于零资源消耗。浏览器 WebGPU 首次运行需要拉取数百兆级别的量化分片权重,在移动网络或低配核显设备上可能会遇到首屏加载耗时较长、显存不足或部分浏览器默认未开启 WebGPU 特性开关的情况。
多语言真实听感与推理速度尚待独立实测:前文提及的 80 ms、150 ms 与 570 ms 延迟数据以及开源排行榜第一的评测结果(ZTTS2-Eval)均引自 Zyphra 官方披露。至于 ZONOS3-Mini 在中文四声调自然度、日语高低音重音(Pitch Accent)、中英日混读断句以及不同消费级显卡上的实际生成倍速,我们将在后续实机测试后单独发布评测报告。