本文目录
2026 年 11 月 18 日,Google 正式推出 Gemini 4 Neon(官方 API 模型 ID:gemini-4-neon)。根据 Google DeepMind 同步公开的官方模型卡,Gemini 4 Neon 并非从零训练的孤立分支,而是基于重型推理旗舰 Gemini 4 Carbon 适配演进(adapted from Gemini 4 Carbon)而来,知识截止日期为 2026 年 3 月。在 Google 现有的 Gemini 4 产品矩阵中,Neon 精准卡位在重型长程推理旗舰 Carbon 与日常高速主力 Hydrogen 之间,并直接取代此前 Gemini 4 Argon 的位置,成为付费 Google AI Pro(每月 $19.99)及 Google Antigravity 新建会话的默认主力模型。
仓库级编码能力拆解:为何 Antigravity 工具链让 SWE-sweep 成绩翻逾三倍
基础模型能力与智能体工程底座的乘数效应:在第三方的常规编码评测中,Gemini 4 Neon 已经展现出同价位段的头部水准——在 Artificial Analysis Coding Agent Index 上以 58.6 分位居榜首,CursorBench 4.1 达到 65.4%,防作弊校准后的 Terminal-Bench 4.1 达到 65.2%,默认 high 思考档位下的 FrontierCode 2.0 取得 46.2%。但对真实软件工程更具参考价值的信号出现在仓库级多文件修复基准 SWE-sweep 上:当仅运行在极简基础框架 mini-SWE 下时,Neon 得分为 12.8%(仍高于同表 Claude Opus 5.5 的 3.6% 与 GPT-6.2 Sol 的 11.6%);而当接入 Google Antigravity 原生执行底座(Provider Harness)时,其通过率直接跃升至 39.0%(同表 Claude Opus 5.5 为 10.1%,GPT-6.2 Sol 为 8.3%)。
减少冗余文件读取与 95.2% 长上下文跨文件依赖追踪:官方技术说明揭示了这一三倍跃升背后的工程原因:首先,Neon 在训练中针对长程工具调用进行了专项强化,大幅减少了仓库探索阶段的冗余文件读取,并在长会话中可靠地执行上下文压缩(context compaction);其次,在评估 256K 至 1M 超长上下文广度优先多跳检索能力的 GraphWalks 基准中,Neon 拿到 95.2% 的高分(显著领先同表 Claude Opus 5.5 的 66.8% 与 GPT-6.2 Sol 的 80.1%),使其能够在 512K(Antigravity 端上限)至 1M(API 端上限)上下文内精确锁定跨模块调用链并实施外科手术式多文件重构;最后,Antigravity 为其提供了隔离的 Git worktree 并行子智能体(/swarm)、结构化可视化 Diff 审查以及通过 Chrome DevTools MCP 驱动本地浏览器抓取控制台与性能指标(/browser)的闭环验证工具。
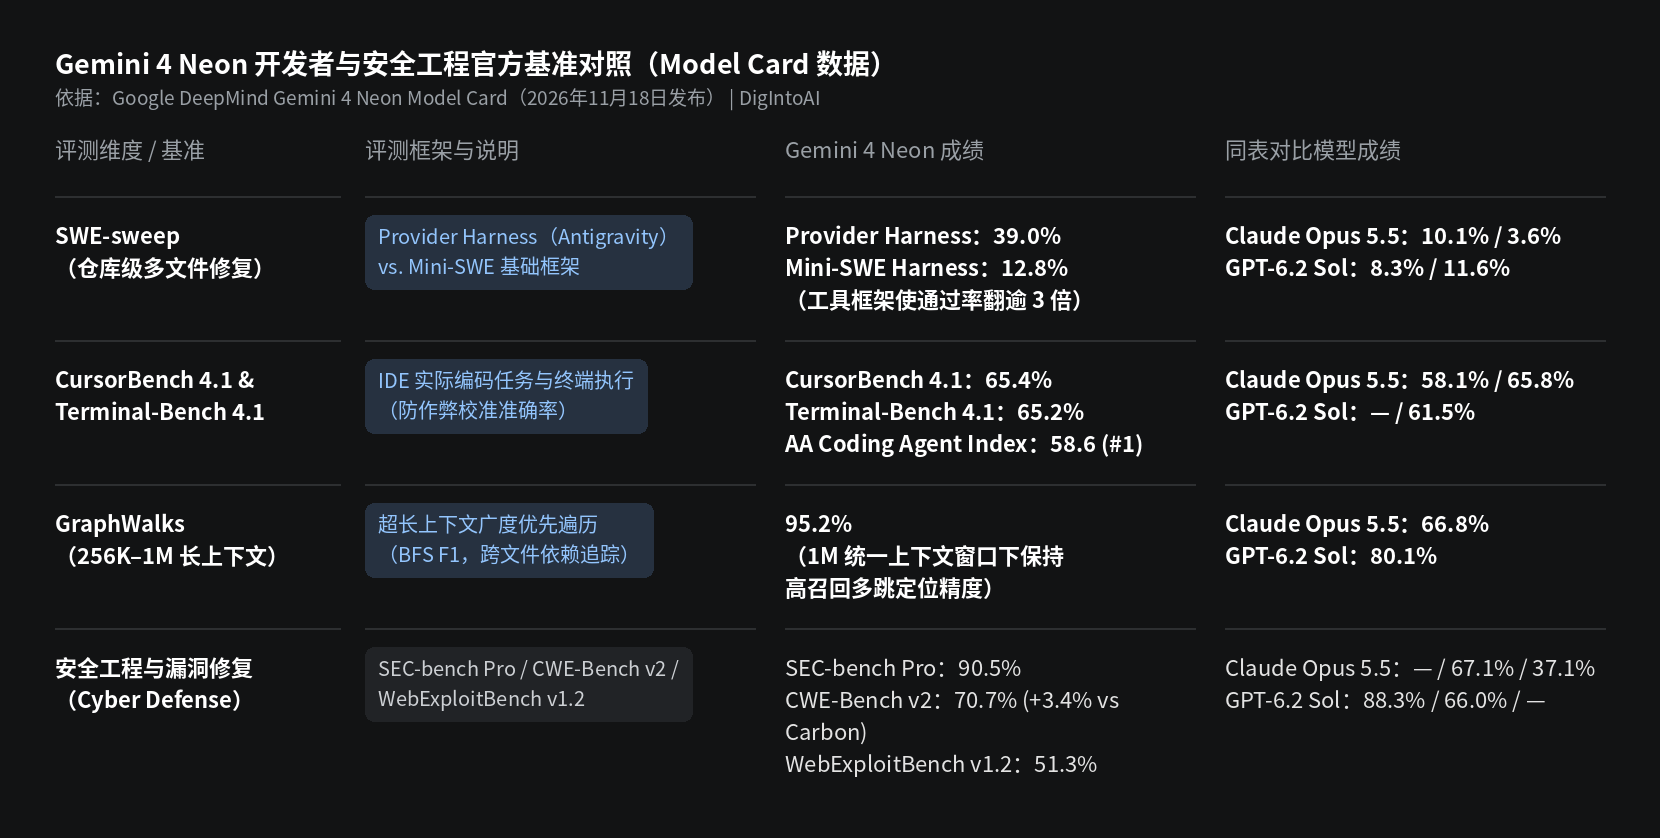
图片来源:DigIntoAI 根据 Google DeepMind Gemini 4 Neon 官方模型卡整理制作。
Orchestrator (Neon):规划审查与高速执行的双模型协同架构
主从分工与遇阻回交机制:随 Gemini 4 Neon 同步登陆 Antigravity 桌面客户端(v2.5+)、命令行工具(agy v1.2+)与 IDE 扩展的,还有全新的双模型编排模式 Orchestrator (Neon)。在该模式下,单个开发会话内部会同时调度两款 Gemini 4 模型:由判断力更强、上下文理解更深的 Gemini 4 Neon 担任架构师与审查者,负责拆解任务、制定实施计划与验收结果;而具体的代码编辑、依赖包更新与单元测试运行则并行委派给响应速度更快、token 成本更低的 Gemini 4 Hydrogen 子智能体执行。一旦 Hydrogen 在执行过程中遇到测试失败、依赖冲突或环境卡壳,控制权会自动交还给 Neon 检查工作区状态、修正技术方案并继续推进。
订阅套餐与企业版权限边界:根据 Google Antigravity 团队公布的权限矩阵,付费 Google AI Pro 与 Google AI Ultra 订阅用户可完整使用 Gemini 4 Neon 以及 Orchestrator (Neon)(试用版 Pro 仅限特定符合条件的合作设备);Free 与 Google AI Plus 套餐不包含 Neon;而 Enterprise 企业版客户虽然可以通过 Gemini for business 接入 Gemini 4 Neon,但目前尚未包含 Orchestrator (Neon) 双模型编排模式。在 CLI 终端中,开发者可通过参数 --model gemini-4-neon-xhigh 或 --effort xhigh 直接调用最高思考档位。
API 开发集成、四档思考控制与计费窗口权衡
Interactions API 与长程输出(Long Decode):在 Google AI Studio 与 Gemini API 中,gemini-4-neon 提供 1,048,576 tokens(1M)统一输入/思考/输出共享上下文窗口,同步调用(background=False)默认最大输出为 64K(65,536 tokens),若需生成完整大型代码库文档或超长分析报告,可在开启 background=True 或客户端续写模式下启用 Long Decode,将输出上限扩展至 1M tokens。在接口层,Google 推荐通过 Interactions API(client.interactions.create)调用,该接口将内部思考过程抽象为独立的 thought 步骤并自动管理多轮工具调用间的加密思考签名(thought signatures),同时原生支持 Google Search 事实核验、代码执行、计算机操控以及 11 月 18 日最新上线的 Office 与 OpenDocument 多模态文件处理与切片(支持 DOC、PPT、ODP、ODS、DOCX 与 XLSX 等格式)。
每百万 token 单价与 11 月 30 日前后的选型账本:gemini-4-neon 的 API 标准定价为输入 $3.00 / 百万 tokens、缓存输入 $0.15 / 百万 tokens(95% 上下文缓存折扣)、输出 $15.00 / 百万 tokens(Batch 批处理与 Flex 弹性推理享 5 折,即输入 $1.50 / 输出 $7.50;Priority 优先层为输入 $5.40 / 输出 $27.00)。从单任务综合成本看,由于 Neon 推理路径更精炼,其在默认 high 档位下的单任务成本较 Gemini 4 Carbon 降低 32%,在 xhigh 档位下较竞品最高设置低 36% 以上。不过开发者在 11 月底前做 API 选型时需注意一个短期价格窗口:Gemini 4 Carbon 在 2026 年 11 月 30 日前处于输入 $2.00 / 输出 $10.00 的首发促销期(按等量 token 计算暂时比 Neon 便宜三分之一),自 2026 年 12 月 1 日 Carbon 恢复输入 $4.00 / 输出 $20.00 标准价后,Neon 的单价将比 Carbon 低 25%,同时保持 Hydrogen(输入 $1.50 / 输出 $7.50)两倍的定位阶梯。
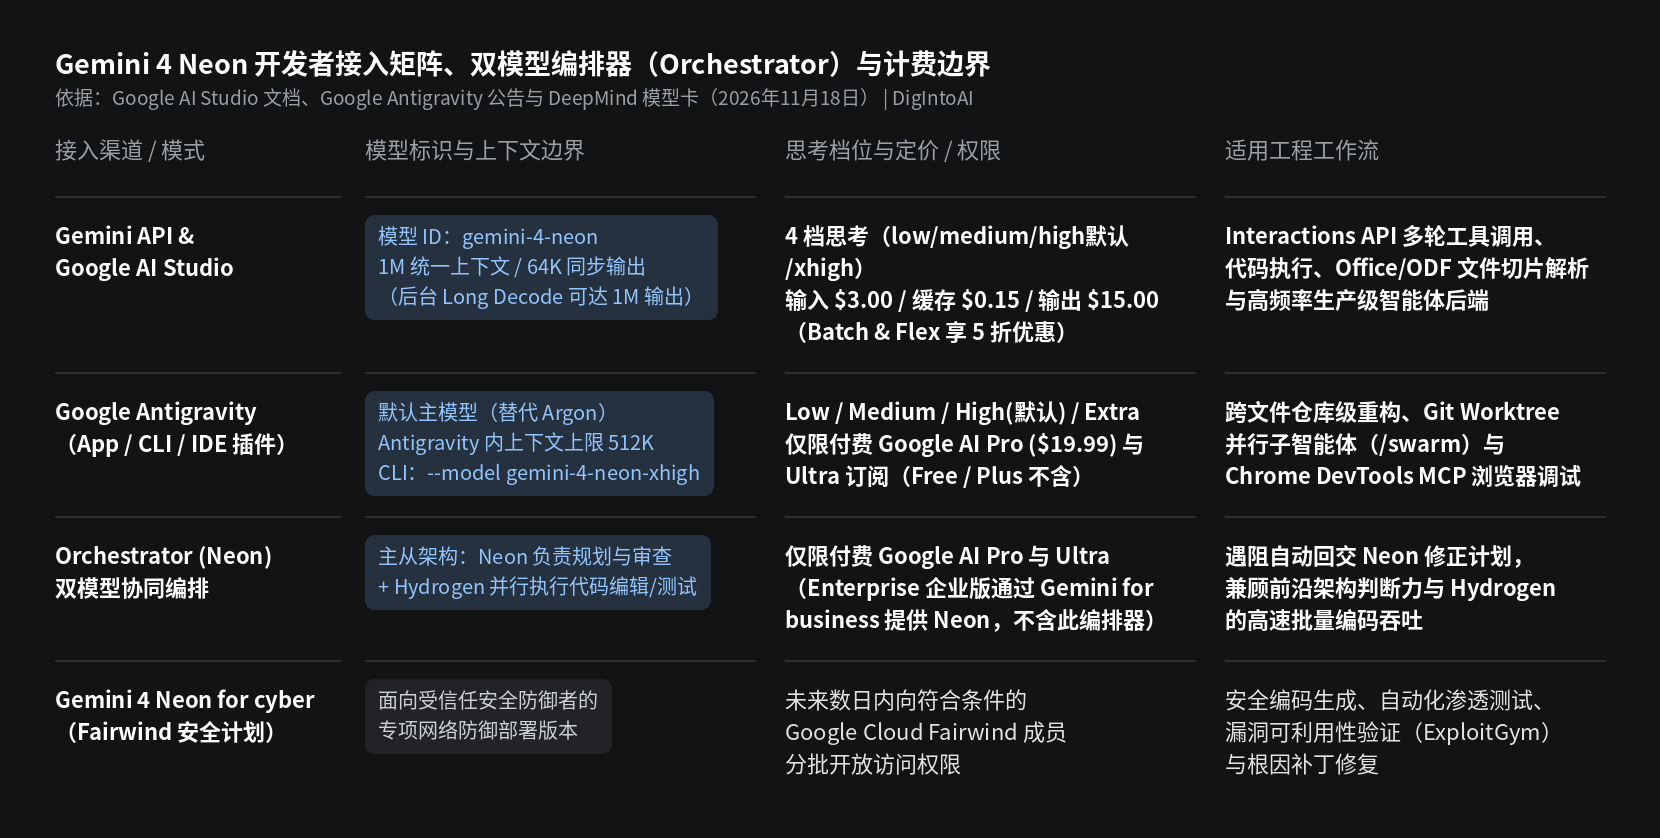
图片来源:DigIntoAI 根据 Google AI Studio 文档与 Google Antigravity 官方说明整理制作。
防御性安全编码(Gemini 4 Neon for cyber)与生产可靠性指标
全生命周期漏洞防御表现:针对代码安全审计与自动化防御场景,Google 同步推出专项配置 Gemini 4 Neon for cyber,并将在未来数日内通过 Google Cloud 的 Fairwind Program 向受信任安全团队开放。在官方披露的五大安全基准中,Neon 在漏洞挖掘基准 SEC-bench Pro 上取得 90.5% 的行业最高分且单题成本约为同类大模型的一半;在漏洞可利用性验证基准 ExploitGym 上仅用 Carbon 一半的 token 便达到前沿水准;在根因补丁修复基准 CWE-Bench v2 上达到 70.7%(较 Carbon 提升 3.4 个百分点);在安全编码基准 AutoBaxBench 困难档达到 76%,在渗透测试基准 WebExploitBench v1.2 达到 51.26%(模型卡四舍五入为 51.3%)。
低作弊率、低幻觉率与抗间接提示词注入:对于需要无人值守运行的长程编码智能体而言,模型是否会「偷懒改测试」或「越权修改文件」至关重要。DeepMind 模型卡数据显示,Gemini 4 Neon 在 Terminal-Bench 4.0 上保持 0.0% 的作弊率,在内部编程偷懒/作弊专项评估中的捷径率为 2.45%(为整个 Gemini 4 系列最低),智能体不对齐行为率仅为 0.09%,智能体诚实度评估通过率达 99.2%;与 Carbon 相比,其任务执行不足(under-service)减少了 43% 至 56%,越界操作(overreach)减少了 15% 至 35%;同时在 Gray Swan 间接提示词注入(IPI)基准中,配合实时安全防护与最高思考档位实现了 0.0% 的攻击成功率。不过,开发者在部署复杂自主任务时仍需注意 Google Antigravity 社区早期反馈的个别账号配额识别异常(如部分订阅用户升级后遇到 Thinking level 400 报错或上下文截断问题),建议在生产流水线中做好响应状态码与思考档位回退校验。