本文目錄
2026 年 11 月 18 日,Google 正式推出 Gemini 4 Neon(官方 API 模型 ID:gemini-4-neon)。根據 Google DeepMind 同步公開的官方模型卡,Gemini 4 Neon 並非從零訓練的孤立分支,而是基於重型推理旗艦 Gemini 4 Carbon 適配演進(adapted from Gemini 4 Carbon)而來,知識截止日期為 2026 年 3 月。在 Google 現有的 Gemini 4 產品矩陣中,Neon 精準卡位在重型長程推理旗艦 Carbon 與日常高速主力 Hydrogen 之間,並直接取代此前 Gemini 4 Argon 的位置,成為付費 Google AI Pro(每月 $19.99)及 Google Antigravity 新建會話的預設主力模型。
倉庫級編碼能力拆解:為何 Antigravity 工具鏈讓 SWE-sweep 成績翻逾三倍
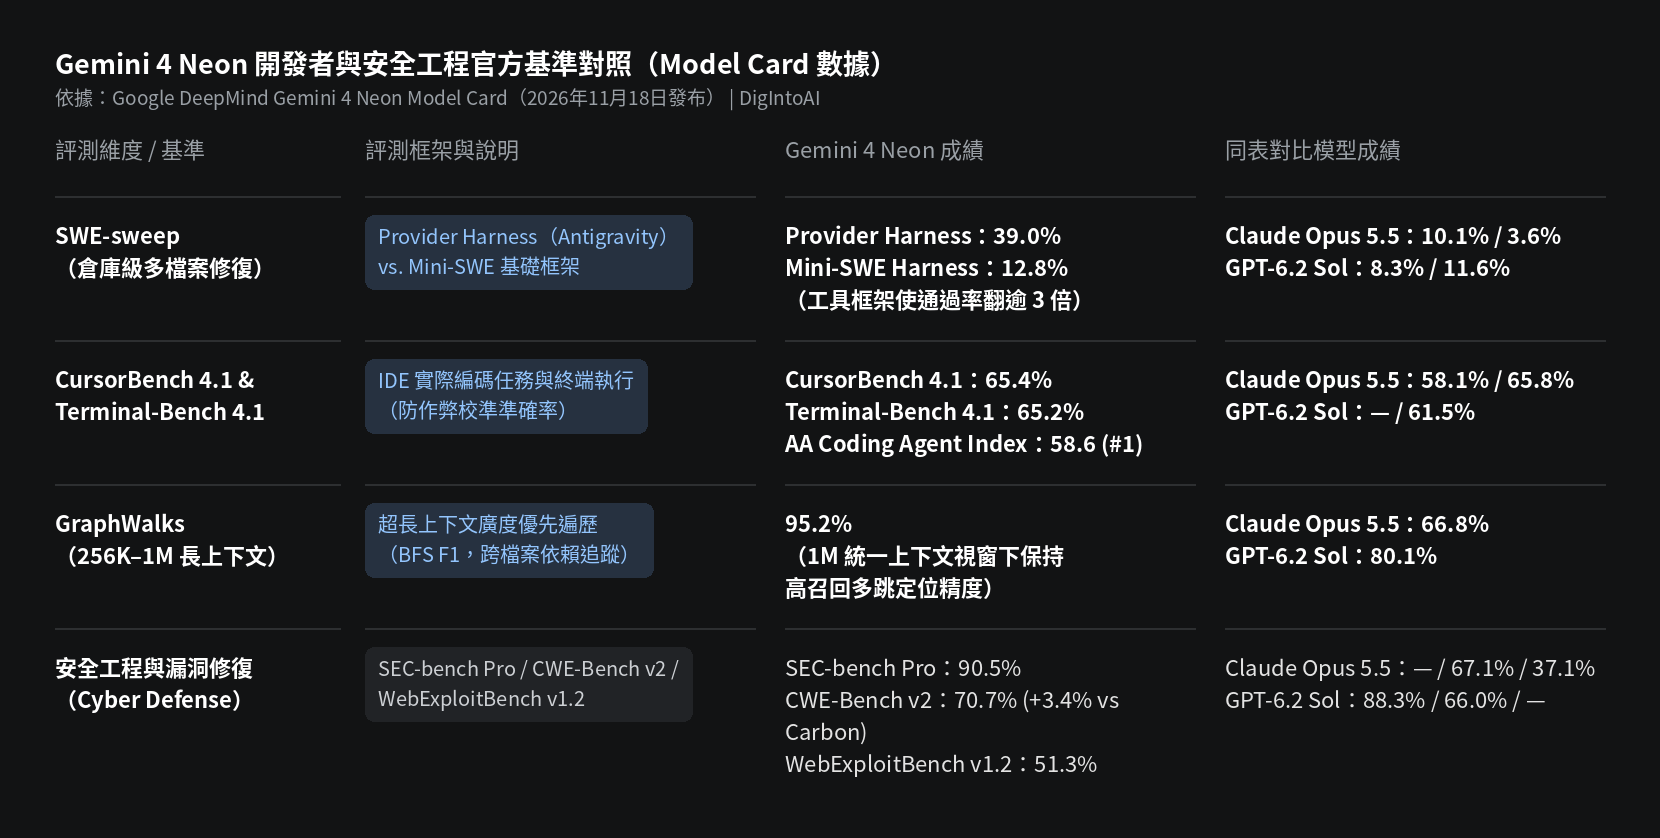
基礎模型能力與智能體工程底座的乘數效應:在第三方的常規編碼評測中,Gemini 4 Neon 已經展現出同價位段的頭部水準——在 Artificial Analysis Coding Agent Index 上以 58.6 分位居榜首,CursorBench 4.1 達到 65.4%,防作弊校準後的 Terminal-Bench 4.1 達到 65.2%,預設 high 思考檔位下的 FrontierCode 2.0 取得 46.2%。但對真實軟件工程更具參考價值的訊號出現在倉庫級多檔案修復基準 SWE-sweep 上:當僅運行在極簡基礎框架 mini-SWE 下時,Neon 得分為 12.8%(仍高於同表 Claude Opus 5.5 的 3.6% 與 GPT-6.2 Sol 的 11.6%);而當接入 Google Antigravity 原生執行底座(Provider Harness)時,其通過率直接躍升至 39.0%(同表 Claude Opus 5.5 為 10.1%,GPT-6.2 Sol 為 8.3%)。
減少冗餘檔案讀取與 95.2% 長上下文跨檔案依賴追蹤:官方技術說明揭示了這一三倍躍升背後的工程原因:首先,Neon 在訓練中針對長程工具呼叫進行了專項強化,大幅減少了倉庫探索階段的冗餘檔案讀取,並在長會話中可靠地執行上下文壓縮(context compaction);其次,在評估 256K 至 1M 超長上下文廣度優先多跳檢索能力的 GraphWalks 基準中,Neon 拿到 95.2% 的高分(顯著領先同表 Claude Opus 5.5 的 66.8% 與 GPT-6.2 Sol 的 80.1%),使其能夠在 512K(Antigravity 端上限)至 1M(API 端上限)上下文內精確鎖定跨模組呼叫鏈並實施外科手術式多檔案重構;最後,Antigravity 為其提供了隔離的 Git worktree 並行子智能體(/swarm)、結構化視覺化 Diff 審查以及透過 Chrome DevTools MCP 驅動本地瀏覽器抓取控制台與效能指標(/browser)的閉環驗證工具。
圖片來源:DigIntoAI 根據 Google DeepMind Gemini 4 Neon 官方模型卡整理製作。
Orchestrator (Neon):規劃審查與高速執行的雙模型協同架構
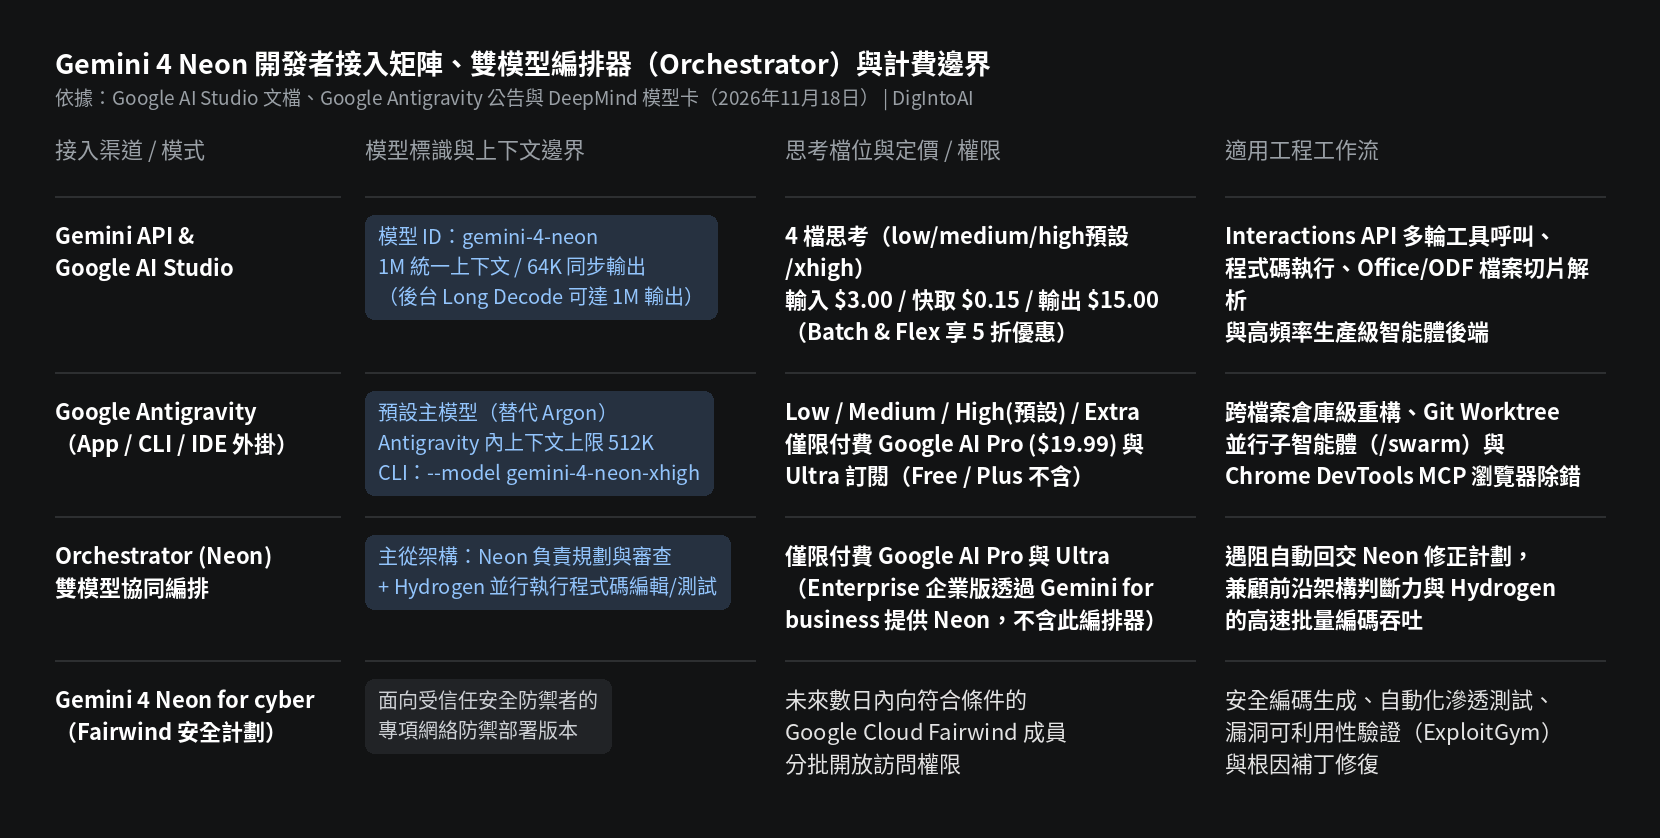
主從分工與遇阻回交機制:隨 Gemini 4 Neon 同步登陸 Antigravity 桌面客戶端(v2.5+)、命令列工具(agy v1.2+)與 IDE 擴充功能的,還有全新的雙模型編排模式 Orchestrator (Neon)。在該模式下,單個開發會話內部會同時調度兩款 Gemini 4 模型:由判斷力更強、上下文理解更深的 Gemini 4 Neon 擔任架構師與審查者,負責拆解任務、制定實施計劃與驗收結果;而具體的程式碼編輯、依賴套件更新與單元測試運行則並行委派給響應速度更快、token 成本更低的 Gemini 4 Hydrogen 子智能體執行。一旦 Hydrogen 在執行過程中遇到測試失敗、依賴衝突或環境卡關,控制權會自動交還給 Neon 檢查工作區狀態、修正技術方案並繼續推進。
訂閱套餐與企業版權限邊界:根據 Google Antigravity 團隊公布的權限矩陣,付費 Google AI Pro 與 Google AI Ultra 訂閱用戶可完整使用 Gemini 4 Neon 以及 Orchestrator (Neon)(試用版 Pro 僅限特定符合條件的合作裝置);Free 與 Google AI Plus 套餐不包含 Neon;而 Enterprise 企業版客戶雖然可以透過 Gemini for business 接入 Gemini 4 Neon,但目前尚未包含 Orchestrator (Neon) 雙模型編排模式。在 CLI 終端中,開發者可透過參數 --model gemini-4-neon-xhigh 或 --effort xhigh 直接呼叫最高思考檔位。
API 開發整合、四檔思考控制與計費視窗權衡
Interactions API 與長程輸出(Long Decode):在 Google AI Studio 與 Gemini API 中,gemini-4-neon 提供 1,048,576 tokens(1M)統一輸入/思考/輸出共享上下文視窗,同步呼叫(background=False)預設最大輸出為 64K(65,536 tokens),若需生成完整大型程式碼庫文檔或超長分析報告,可在開啟 background=True 或客戶端續寫模式下啟用 Long Decode,將輸出上限擴展至 1M tokens。在介面層,Google 推薦透過 Interactions API(client.interactions.create)呼叫,該介面將內部思考過程抽象為獨立的 thought 步驟並自動管理多輪工具呼叫間的加密思考簽名(thought signatures),同時原生支援 Google Search 事實驗證、程式碼執行、電腦操控以及 11 月 18 日最新上線的 Office 與 OpenDocument 多模態檔案處理與切片(支援 DOC、PPT、ODP、ODS、DOCX 與 XLSX 等格式)。
每百萬 token 單價與 11 月 30 日前後的選型賬本:gemini-4-neon 的 API 標準定價為輸入 $3.00 / 百萬 tokens、快取輸入 $0.15 / 百萬 tokens(95% 上下文快取折扣)、輸出 $15.00 / 百萬 tokens(Batch 批處理與 Flex 彈性推理享 5 折,即輸入 $1.50 / 輸出 $7.50;Priority 優先層為輸入 $5.40 / 輸出 $27.00)。從單任務綜合成本看,由於 Neon 推理路徑更精煉,其在預設 high 檔位下的單任務成本較 Gemini 4 Carbon 降低 32%,在 xhigh 檔位下較競品最高設定低 36% 以上。不過開發者在 11 月底前做 API 選型時需注意一個短期價格視窗:Gemini 4 Carbon 在 2026 年 11 月 30 日前處於輸入 $2.00 / 輸出 $10.00 的首發促銷期(按等量 token 計算暫時比 Neon 便宜三分之一),自 2026 年 12 月 1 日 Carbon 恢復輸入 $4.00 / 輸出 $20.00 標準價後,Neon 的單價將比 Carbon 低 25%,同時保持 Hydrogen(輸入 $1.50 / 輸出 $7.50)兩倍的定位階梯。
圖片來源:DigIntoAI 根據 Google AI Studio 文檔與 Google Antigravity 官方說明整理製作。
防禦性安全編碼(Gemini 4 Neon for cyber)與生產可靠性指標
全生命週期漏洞防禦表現:針對程式碼安全審計與自動化防禦場景,Google 同步推出專項設定 Gemini 4 Neon for cyber,並將在未來數日內透過 Google Cloud 的 Fairwind Program 向受信任安全團隊開放。在官方披露的五大安全基準中,Neon 在漏洞挖掘基準 SEC-bench Pro 上取得 90.5% 的行業最高分且單題成本約為同類大模型的一半;在漏洞可利用性驗證基準 ExploitGym 上僅用 Carbon 一半的 token 便達到前沿水準;在根因補丁修復基準 CWE-Bench v2 上達到 70.7%(較 Carbon 提升 3.4 個百分點);在安全編碼基準 AutoBaxBench 困難檔達到 76%,在滲透測試基準 WebExploitBench v1.2 達到 51.26%(模型卡四捨五入為 51.3%)。
低作弊率、低幻覺率與抗間接提示詞注入:對於需要無人值守運行的長程編碼智能體而言,模型是否會「偷懶改測試」或「越權修改檔案」至關重要。DeepMind 模型卡數據顯示,Gemini 4 Neon 在 Terminal-Bench 4.0 上保持 0.0% 的作弊率,在內部編程偷懶/作弊專項評估中的捷徑率為 2.45%(為整個 Gemini 4 系列最低),智能體不對齊行為率僅為 0.09%,智能體誠實度評估通過率達 99.2%;與 Carbon 相比,其任務執行不足(under-service)減少了 43% 至 56%,越界操作(overreach)減少了 15% 至 35%;同時在 Gray Swan 間接提示詞注入(IPI)基準中,配合即時安全防護與最高思考檔位實現了 0.0% 的攻擊成功率。不過,開發者在部署複雜自主任務時仍需注意 Google Antigravity 社群早期回饋的個別賬號配額識別異常(如部分訂閱用戶升級後遇到 Thinking level 400 報錯或上下文截斷問題),建議在生產流水線中做好響應狀態碼與思考檔位回退校驗。