北京時間 2026 年 11 月 19 日 05:51,Google 官方帳號(@Google)正式推出新模型 Gemini 4 Neon;隨後於 06:06,Google Antigravity 官方帳號(@antigravity)宣布該模型正式向 Google Antigravity 桌面端應用、CLI 與 IDE 擴充套件推送,面向付費的 Google AI Pro 與 Ultra 個人訂閱用戶以及 Gemini for business 企業用戶開放。
模型定位、1M 上下文與 Orchestrator 雙模型編排
根據 Google 官方說明,Gemini 4 Neon 面向複雜程式設計、知識工作與科研工作流打造,具備 1M tokens 上下文視窗,並提供 四檔思考強度(four thinking levels)供開發者按任務複雜度調節計算深度。在可控性方面,Neon 在 Agent Arena 可控性(steerability)榜單排名第 2,具備強多步指令遵循能力,並在 Antigravity 內部測試中創下迄今最低的編造率(fabrication rate)。
在 Google Antigravity 中,開發者還可透過 Orchestrator 將 Gemini 4 Neon 設為規劃者(planner)、將此前發布的 Gemini 4 Hydrogen 設為執行者(executor),以 Neon 的判斷力把控關鍵架構與決策節點,同時複用 Hydrogen 的高速執行處理常規任務。官方示範影片展示了多代理協作(Swarm)構建 3D 迷你高爾夫遊戲《NEONPUTT '84》,8 個子模組最終匯入 @engine 與 @verifier 完成編譯校驗。
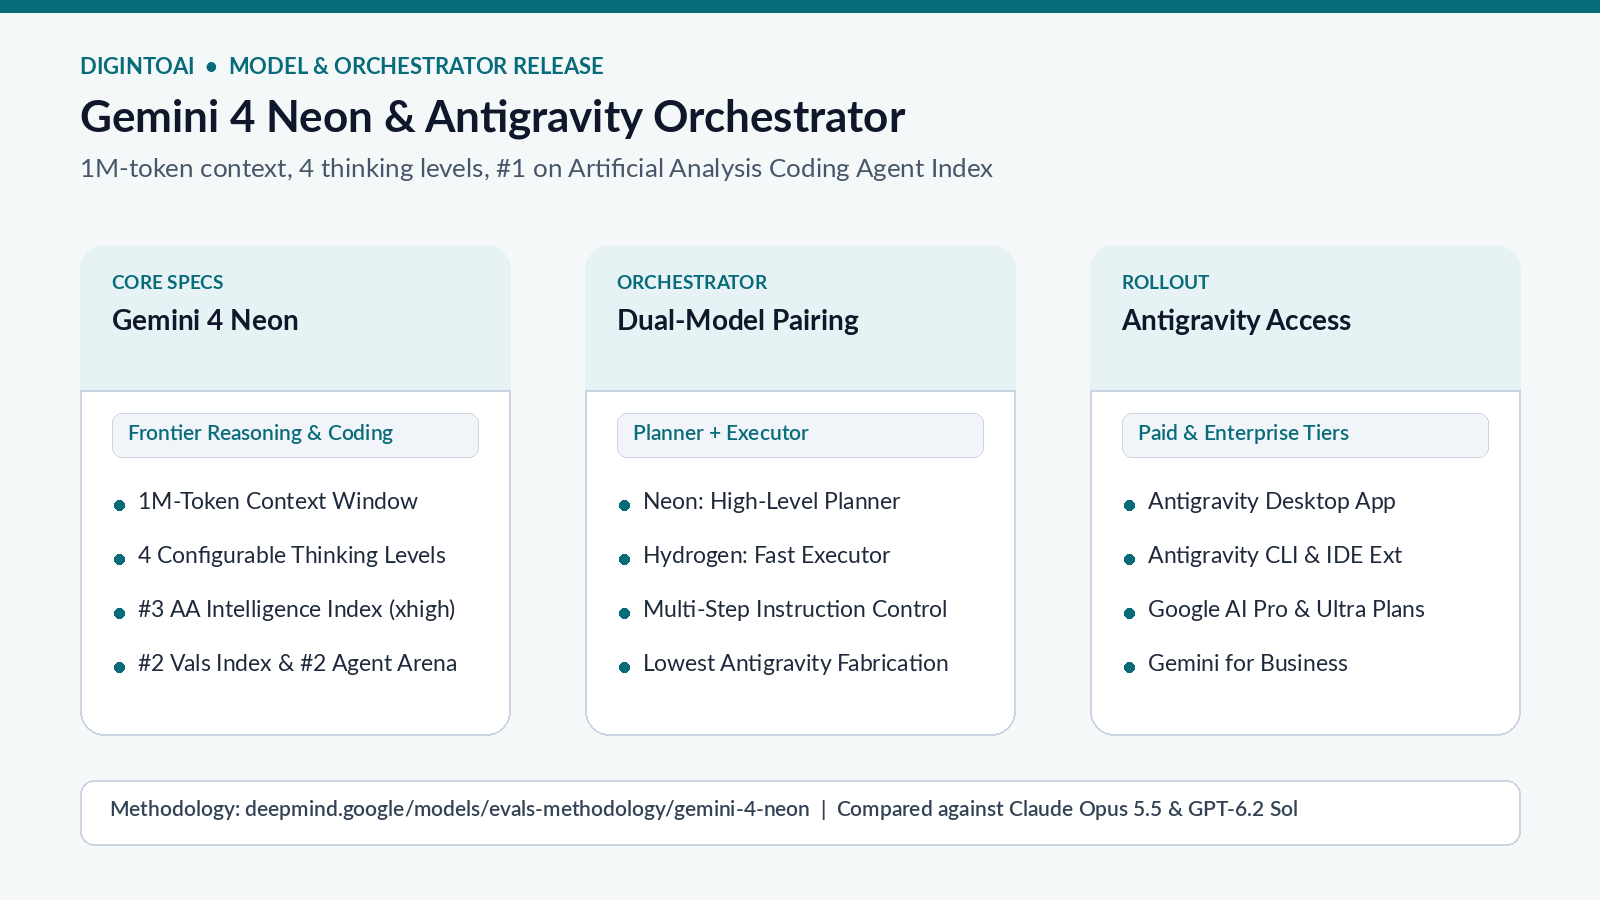
圖片來源:DigIntoAI 根據 Google 及 Google Antigravity 官方公告製作的功能示意圖。
官方披露的基準跑分對比(對比 Claude Opus 5.5 與 GPT-6.2 Sol)
Google 官方同步公布了 Gemini 4 Neon 與 Claude Opus 5.5、GPT-6.2 Sol(相關評測與定價亦可參閱站內 OpenAI GPT-6.2 Astra 與 GPT-6.2 Sol 報導)在七大類別共 18 項測試中的對比數據(完整評測方法公布於 deepmind.google/models/evals-methodology/gemini-4-neon):
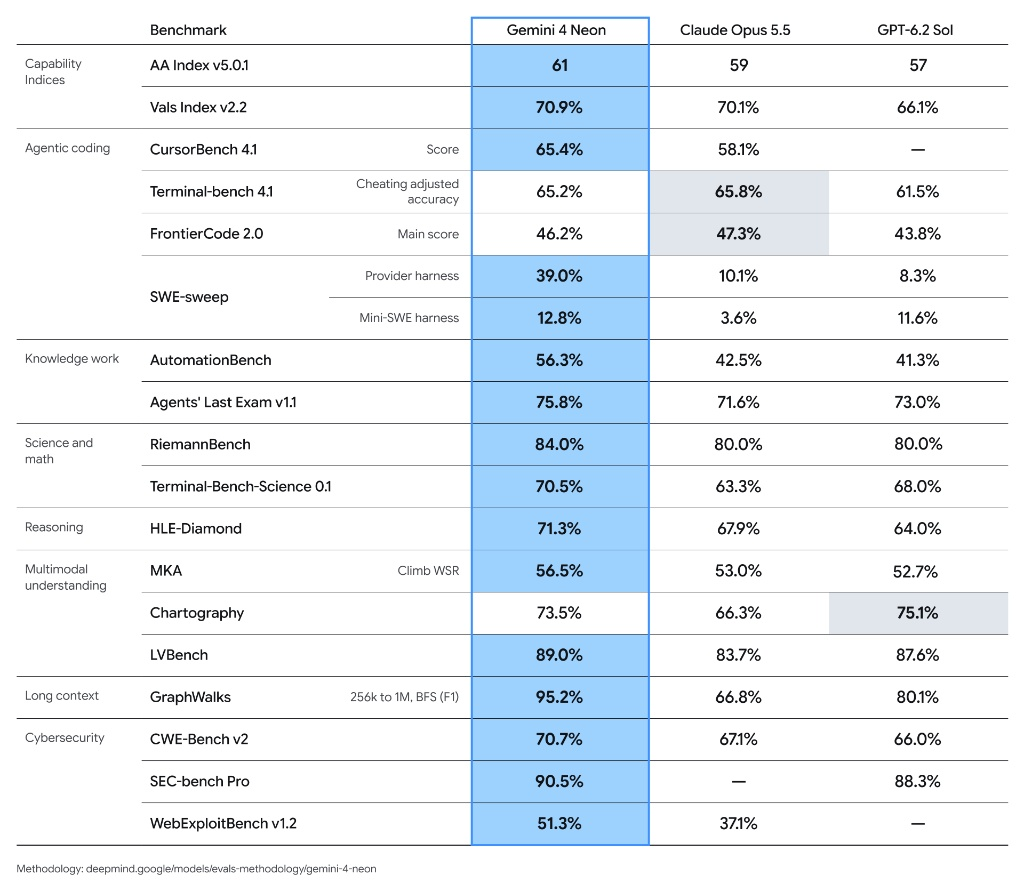
圖片來源:Google 官方 X 公告(@Google)發布的基準測試圖表。
綜合能力榜單(Capability Indices):在 AA Index v5.0.1 中,Gemini 4 Neon 取得 61 分(xhigh 檔位在 Artificial Analysis Intelligence Index 排名總榜第 3,在 Coding Agent Index 排名第 1),領先 Claude Opus 5.5 的 59 分與 GPT-6.2 Sol 的 57 分;在 Vals Index v2.2 中取得 70.9%(總榜排名第 2),高於 Claude Opus 5.5 的 70.1% 與 GPT-6.2 Sol 的 66.1%。
代理式程式設計(Agentic coding):CursorBench 4.1 得分為 65.4%(Claude Opus 5.5 為 58.1%);SWE-sweep(Provider harness)達到 39.0%(Claude Opus 5.5 為 10.1%,GPT-6.2 Sol 為 8.3%),Mini-SWE harness 下為 12.8%(Claude Opus 5.5 為 3.6%,GPT-6.2 Sol 為 11.6%);Terminal-bench 4.1(防作弊調整準確率)為 65.2%(略低於 Claude Opus 5.5 的 65.8%,高於 GPT-6.2 Sol 的 61.5%);FrontierCode 2.0 主得分為 46.2%(Claude Opus 5.5 為 47.3%,GPT-6.2 Sol 為 43.8%)。
知識工作、科研數學與深度推理:AutomationBench 為 56.3%(Claude Opus 5.5 為 42.5%,GPT-6.2 Sol 為 41.3%);Agents' Last Exam v1.1 為 75.8%(Claude Opus 5.5 為 71.6%,GPT-6.2 Sol 為 73.0%);RiemannBench 為 84.0%(兩款對比模型均為 80.0%);Terminal-Bench-Science 0.1 為 70.5%(Claude Opus 5.5 為 63.3%,GPT-6.2 Sol 為 68.0%);HLE-Diamond 推理測試為 71.3%(Claude Opus 5.5 為 67.9%,GPT-6.2 Sol 為 64.0%)。
多模態理解、長上下文與網路安全:MKA(Climb WSR)為 56.5%(Claude Opus 5.5 為 53.0%,GPT-6.2 Sol 為 52.7%);LVBench 為 89.0%(Claude Opus 5.5 為 83.7%,GPT-6.2 Sol 為 87.6%);Chartography 為 73.5%(高於 Claude Opus 5.5 的 66.3%,低於 GPT-6.2 Sol 的 75.1%);256k 至 1M 區間 GraphWalks(BFS F1)達到 95.2%(Claude Opus 5.5 為 66.8%,GPT-6.2 Sol 為 80.1%);網路安全三項測試中,CWE-Bench v2 為 70.7%、SEC-bench Pro 為 90.5%、WebExploitBench v1.2 為 51.3%。截至發文,Google 尚未公布 Gemini 4 Neon 的公開 API 模型 ID 或按 token 計費價表。