本文目录
2026 年 10 月至 11 月期间,全球头部实验室密集释放了一批具有标志意义的新模型:Anthropic 推出了强调长程推理与工程自治的 Claude Fable 5.2(及定向授权版 Mythos 5.2),Google 沿元素周期表序列先后上线了 Gemini 4 Argon、Gemini 4 Carbon 与面向高频智能体工作流的 Gemini 4 Hydrogen,字节跳动则更新了原生视频生成模型 Seedance 2.5 及其高速版本。把这几条产品线放在同一张技术坐标系里审视,可以观察到过去两年行业普遍默认的三条直觉正在被改写:第一,代码模型开始直接接管 2D 动画与 3D 场景生成,视频模型是否走了弯路;第二,通用推理模型为何能在机器人控制与电路板设计上跨界击穿垂直模型;第三,拥有最庞大互联网与视频语料的 Google,为何在静态事实知识榜上反被 Anthropic 超越。
生成范式的左右脑分工:程序化代码骨架与原生像素渲染
Claude Fable 5.2 与 Claude Motion 展示出仅凭提示词即可生成高质量演示动画与 3D 短片的能力后,不少创作者开始质疑专门训练扩散类视频模型(如 Seedance 2.5 或 Veo)的必要性。事实上,两者在底层属于完全不同的技术路线,各自统治着互不重叠的能力象限。
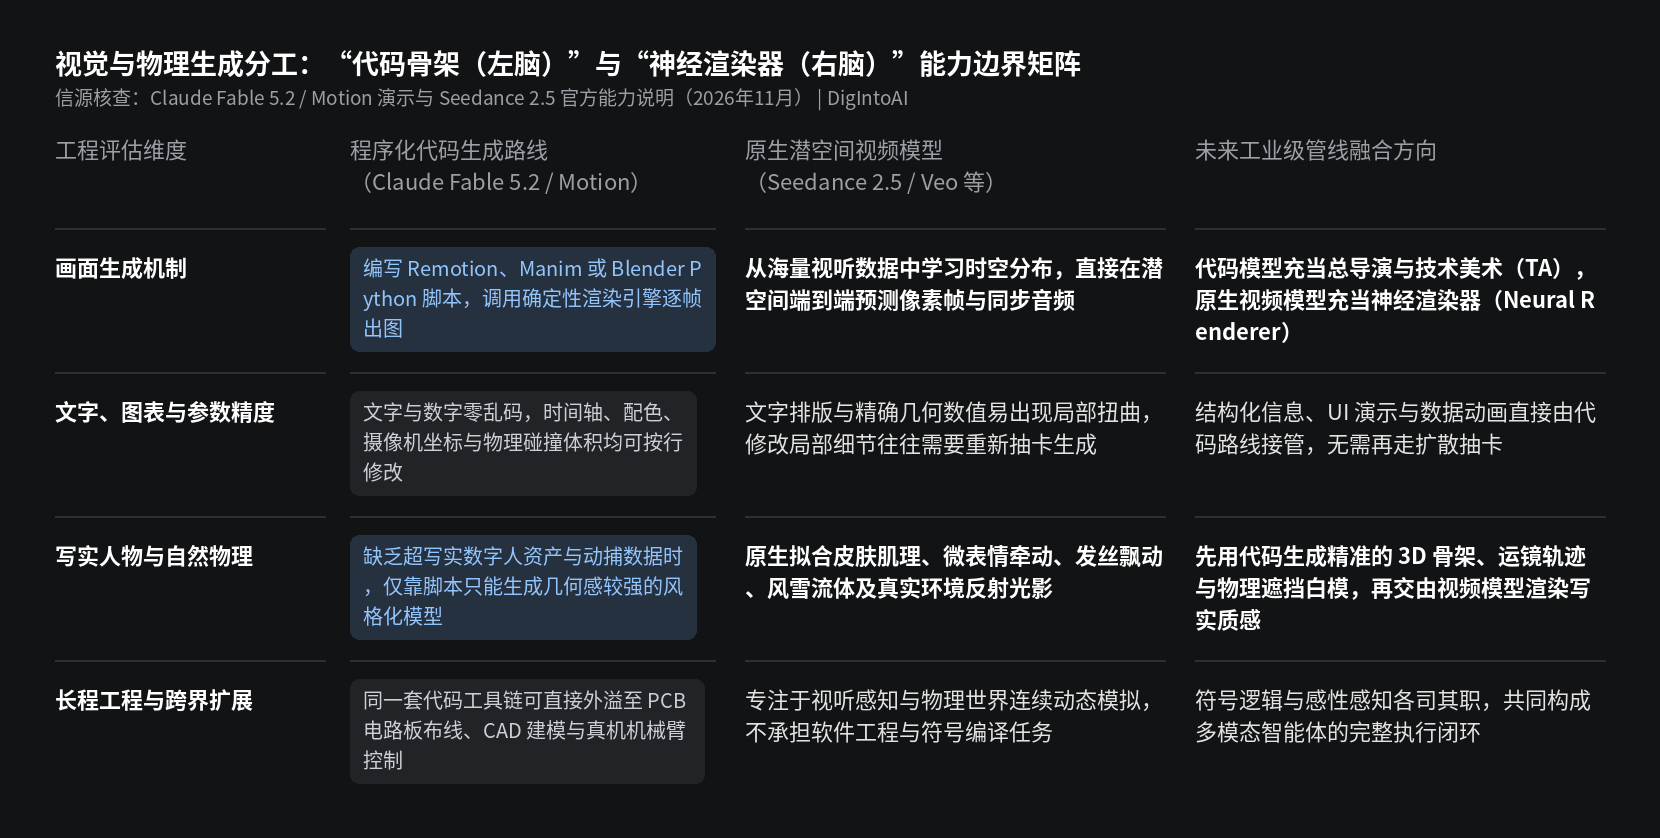
以 Claude 为代表的程序化生成路径,本质上是“写代码驱动确定性渲染引擎”。面对产品界面演示、数据看板动画或技术科普视频,模型在后台编写 Remotion、Manim 或矢量动画代码并导出视频;面对复杂 3D 镜头,Fable 5.2 则直接生成 Blender Python 脚本,自主完成建模、材质、布光、多机位运镜切换与昼夜环境光变化。这条路线的核心优势在于确定性与可编辑性——画面中的文字和数字不会出现乱码,时间轴、配色或摄像机坐标随时可以按行精准修改,无需像传统视频生成那样反复抽卡重绘。
然而,代码可以穷举逻辑与几何拓扑,却无法用几百行脚本凭空写出真实物理世界的高维连续细节。如果要求模型生成一个“演员在黄昏飘雪中回头、眼眶微红、发丝被微风吹过脸颊并带着叹息说出台词”的镜头,在没有预先制作好的超写实数字人资产与动作捕捉数据时,纯粹靠代码生成的只能是几何感明显的风格化模型。而 Seedance 2.5 这类原生视频大模型从海量视听数据中学习时空潜空间分布,支持 30 秒连续叙事、多达 50 个多模态参考素材以及原生音画同步,能够直接端到端拟合皮肤肌理、微表情牵动与风雪流体光影。
因此,原生视频模型并未走弯路,但市场分工正在发生明确迁移:所有强逻辑、强文字、强结构的演示类与动态图表视频正快速被代码模型接管;而在复杂影视与工业内容管线中,更合理的演进方向是“左脑搭骨架、右脑做渲染”——由代码模型充当总导演与技术美术(TA),先构建精确的 3D 空间布局、物理遮挡与运镜轨迹,再交由原生视频模型作为神经渲染器(Neural Renderer)赋予写实质感与声音表现。
图片来源:DigIntoAI 根据 Claude Fable 5.2 工程演示与 Seedance 2.5 官方技术规格整理制作。
通用基座的苦涩的教训:从代码工具到天级工程军团
Claude Fable 5.2 之所以在发布后引发关于“苦涩的教训”(The Bitter Lesson)的广泛讨论,是因为它证明了当通用基座的符号推理深度、空间理解与工具调用跨越临界点后,代码会成为操控各类工程软件的通用接口,从而跨界冲击多个垂直领域。
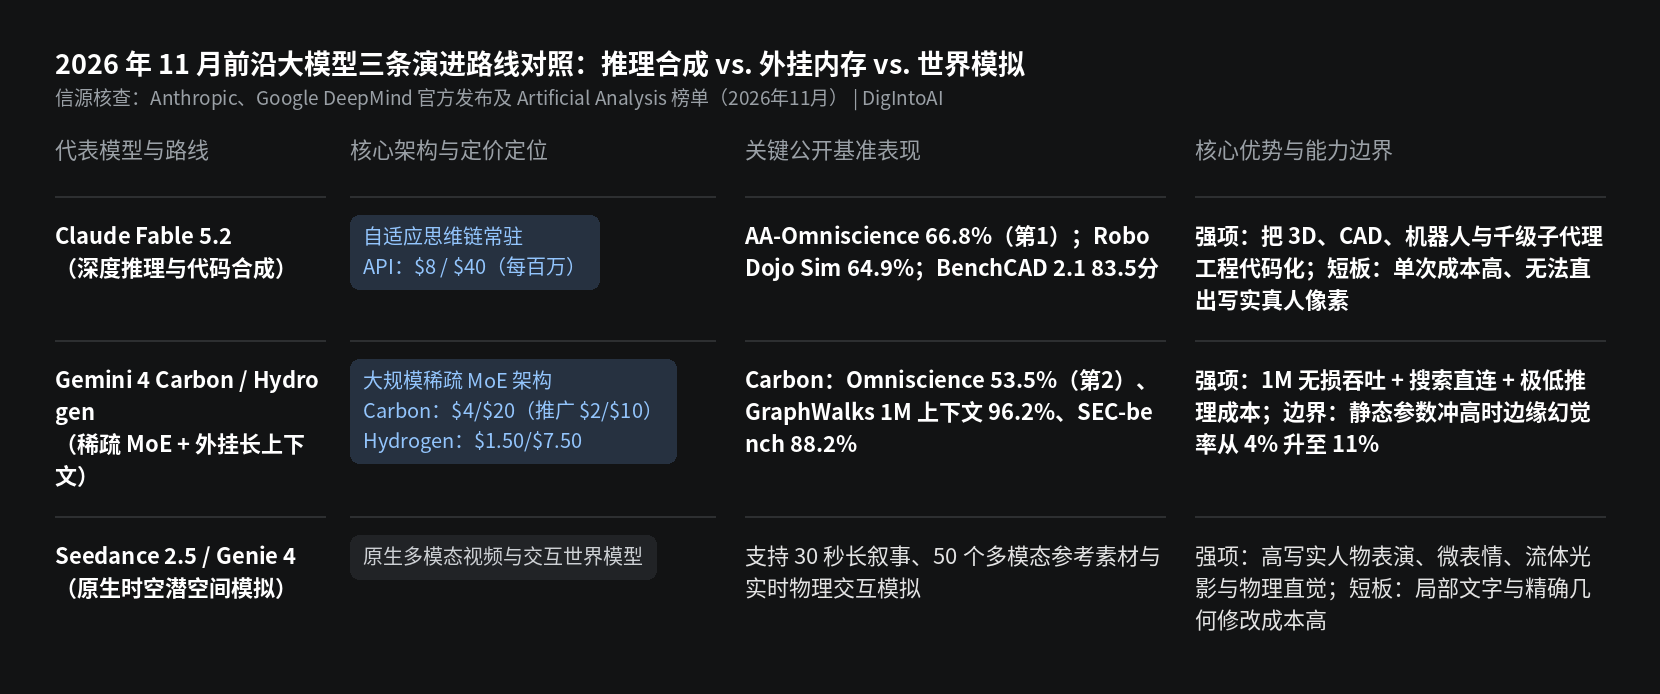
跨界击穿机器人与硬件工程基准:在机器人操作评测 RoboDojo Sim 上,Fable 5.2 的得分从上一代 Fable 5.1 的 27.6% 跃升至 64.9%,大幅领先 Claude Opus 5.5(39.4%)与 GPT-6 Astra(29.8%),并在真机测试中实现了零样本机械臂操作与连续 62 步的物理接触纠偏。在硬件工程基准 BenchCAD 2.1 上,其得分达到 83.5 分(Opus 5.5 为 65.3 分),并在独立电路板设计测试中自主完成了元器件选型、原理图、自动布线与 3D 外壳建模,打样成品无需人工修改即可通电运行。
时间尺度从小时级跃迁至天级与千级子代理协同:传统前沿模型在连续运行数小时后容易陷入死循环或停留在半成品阶段,而 Fable 5.2 展现出多日级(Days-long)持续推进与千级子代理并行编排能力。公开披露的极限案例包括调度 1,000 个智能体协同运行 30 小时完成费马大定理的 Lean 形式化证明(Opus 5.5 在 18 小时完成 26% 后停滞),以及千级智能体连续运行 8 天构建包含驱动、存储与窗口系统的完整操作系统原型。在安全工程侧,早期测试机构也披露其可在单次会话中构建并形式化验证包含超过 3,500 条机器检查证明的虚拟化隔离层。
自适应思考带来的算力效率曲线变化:默认常驻的自适应思考机制使 Fable 5.2 在低(Low)或中(Medium)思考投入下,就能在部分高难度推理与图表理解基准上以不到 Opus 5.5 十分之一的单任务成本追平甚至反超对手满血档位表现;而在开启最高思考强度(Xhigh / Max)并赋予长执行周期时,则进一步拉开了复杂工程交付的上限。
图片来源:DigIntoAI 根据 Anthropic、Google DeepMind 官方公告及 Artificial Analysis 公开数据整理制作。
知识范式的去静态化:推理合成 vs. 外挂百万上下文内存
另一项反直觉的现象出现在世界知识评测中。根据 Artificial Analysis 公布的 AA-Omniscience 事实知识基准数据,2026 年 10 月底发布的 Gemini 4 Carbon 曾凭借谷歌深厚的数据积累以 53.5% 的得分登顶榜首,但随后就被 Claude Fable 5.2 以 66.8%(Max 档净分 67)大幅反超。表面上看谷歌掌握着全网最丰富的网页、学术与视频资源,为何静态参数知识分却低于 Anthropic?
评测细节揭示了静态记忆的边际收益递减规律:当 Gemini 4 Carbon 把事实问答准确率推高至顶尖水平时,其在未知长尾知识上的幻觉率从 Gemini 4 Argon 的 4% 上升到了 11%(AA-Omniscience v1.1 净分榜中 Carbon Medium 幻觉率为 4%,而更高覆盖档位则出现明显波动)。单纯把冷门网页信息烤进模型权重不仅训练成本高昂,还容易诱发模型在模糊边界强行抢答。
面对这一瓶颈,Anthropic 与 Google 走出了两条截然不同的破局路径。Anthropic 选择的是“深度推理合成路线”——不单纯依赖死记硬背,而是依靠严密的逻辑链条在推理时动态推导并补全高阶专业知识,代价是较高的单 Token 价格(Fable 5.2 标准 API 定价为每百万输入 8 美元、输出 40 美元,快速模式为 16 美元与 80 美元)。
Google 则选择了“稀疏高效架构 + 外挂动态内存路线”。从 Gemini 4 Argon 模型卡披露的信息来看,Gemini 4 全系采用大规模稀疏混合专家(Sparse MoE)架构,每次推理仅激活极小比例参数。这使得 Gemini 4 Carbon 标准定价仅为每百万输入 4 美元、输出 20 美元(推广期低至 2 美元与 10 美元),而 11 月 12 日发布的 Gemini 4 Hydrogen 更是压低至 1.50 美元与 7.50 美元,并直接接入全球 Google Search 底层。在多模态知识代理基准 MKA 上,Carbon 质量位列第二的同时平均任务成本仅为榜首的六分之一;而在 256K 至 100 万 Token 的 GraphWalks 超长上下文推理评测中,Carbon 拿下了 96.2% 的高分。换言之,Google 放弃了把整个互联网硬塞进静态权重,而是用 100 万 Token 无损吞吐加上实时搜索引擎,把互联网变成了随取随用的外挂内存。
边界说明与待实测项
在参考上述分析进行技术选型时,需要明确区分已验证基准与行业推演的边界:
关于后续超大参数旗舰的推测属于行业研判:目前 Google 公布的 Gemini 4 型号(Hydrogen 1 号元素、Carbon 6 号元素、Argon 18 号元素)均位于元素周期表前三周期,结合其定价与延迟定位,Carbon 实际上承担的是主力 Pro 生态位。业界普遍推测 Google 实验室仍在打磨对应更重元素的 Ultra 级旗舰,但截至 2026 年 11 月 13 日,Google 官方尚未公布任何比 Carbon 更大的 Gemini 4 型号名称或参数规模。
混合渲染管线与跨模型基准仍待独立实测:文中引用的 AA-Omniscience、RoboDojo Sim、BenchCAD 2.1 与 GraphWalks 分数均来自各实验室技术报告与 Artificial Analysis 公开榜单,各家评测时的思考强度配置(如 Medium 与 Max 档位)存在差异。此外,“代码模型生成 3D 白模骨架 + 原生视频模型进行神经渲染”的混合工作流目前仍处于早期工程探索阶段,其真实跨帧一致性与生产成本账本尚待我们后续在独立测试环境中实测验证。